AIの進化により、従来のAIOps(1.0)から、LLMや因果AI、深層強化学習を活用した新たな”AIOps 2.0”へ進化が非常に早いスピードで進んでいます。自律型AIエージェントによる自己修復インフラの導入など、自律型IT運用へのパラダイムシフトについて解説します。
はじめに:アラート対応に追われるIT運用の限界とAIOps 2.0へのパラダイムシフト
現代のエンタープライズIT環境は、マイクロサービス化、マルチクラウドの浸透、コンテナやサーバーレス構成の爆発的普及によって、人間の認知能力と手動運用の限界を超える複雑性に達しています。仮想マシン、コンテナ群、各層のSaaSにまたがる分散型インフラからは、ログ、時系列メトリクス、分散トレース、イベント通知といったテレメトリデータが年率2桁の速度で増加し続けています。
このデータ爆発に伴い、運用現場では1日に数万件単位のアラートが発報される「アラート疲れ(Alert Fatigue)」が常態化し、エンジニアの注意力を削ぎ落とすと同時に重大なインシデントの予兆を見落とす壊滅的なリスクを生み出しています。さらに、障害対応の手順や問題調査のノウハウが特定エンジニアの「暗黙知」として属人化しているため、人材の流動化に伴う運用品質の低下やSLA(サービスレベル合意)違反の頻発が、企業経営における重大な脆弱性となっています。デジタルサービスが事業収益の核となった今日、受動的な人海戦術による障害火消し作業は戦略的限界を迎えており、IT運用モデルの根本的な再構築が急務となっています。
AIOps 1.0とAIOps 2.0(Agentic Ops)の対比分析
2016年にガートナー(Gartner)が提唱した「AIOps 1.0」は、サイロ化した監視データの集約と、静的ルールや基本的な機械学習(時系列クラスタリング、主成分分析(PCA)等)によるアラート相関・ノイズ削減を主な目的としていました。これに対し、2026年の最前線である「AIOps 2.0(Agentic Ops)」は、大規模言語モデル(LLM)による非構造化データの文脈解釈、因果関係をダイレクトに捉える因果AI(Causal AI)、深層強化学習(DRL)、および自律型AIエージェントを融合させることで、障害の「自動調査」「根本原因の因果特定」「自己修復(Self-Healing)」までを一気通貫で自動遂行するテクノロジーへと進化しています。
| 評価軸 | AIOps 1.0(従来型:統計・ルールベース) | AIOps 2.0(最新型:Agentic / 統合AI) |
| 中核テクノロジー | 静的閾値、統計的機械学習(時系列クラスタリング、PCAなど) | LLM、因果AI(Causal AI)、深層強化学習(DRL)、AI SRE Agent |
| 主な機能範囲 | ログ集約、重複アラート排除、統計的異常検知、静的相関付け | 非構造化ログの意味解釈、因果関係特定、自律根本原因分析(RCA)、自己修復 |
| 意思決定の主体 | 人間(AIはスコアや集約結果をダッシュボード提示するのみ) | AIエージェント(段階的権限付与による自律実行、人間は検証・承認) |
| 対応スピード (MTTR) | 短縮幅は限定的(手動によるログ・メトリクス解析の補助にとどまる) | 劇的短縮(手動の数時間単位から、数分・数秒単位へ) |
| 未知障害への対応 | 事前定義ルールや過去の統計データに依存するため対応困難 | プロンプト調整やメモリ主導型メタ制御によるZero-Shot(未学習事象)対応 |
受動的対応から能動的自律対応へのパラダイムシフト(So What? の深掘り)
この進化が示唆する本質(So What?)は、単なる既存ツールのリプレイスではありません。IT運用が「障害発生後に手動で火消しを行う受動的業務(Reactive Operations)」から、「AIエージェントが予兆を感知し自律的に修復する能動的業務(Autonomous/Proactive Operations)」へと不可逆的にパラダイムシフトすることを意味します。
従来のIT部門は、システム停止に伴う機会損失や運用人件費を浪費する「コストセンター」とみなされがちでした。しかし、AIOps 2.0によってインフラのレジリエンス(回復力)と連続稼働が自律的に担保されることで、IT部門はトイル(Toil:定型的で付加価値を生まない手作業)から解放され、事業継続性を保証するとともにプロダクトの信頼性設計やイノベーションに専念できる「戦略的成長基盤」へと変革を遂げます。
IT運用パラダイムの変遷構造
[従来の受動的運用 (Reactive Ops)]
  └─ 手動の監視・生アラート大量受信 → 属人的な切り分け・手動復旧 → 長時間のダウンタイム・コスト膨張
        │
        ▼
[AIOps 1.0 (Assisted Ops)]
  └─ ノイズ削減・アラート相関付け → 統計的異常検知 → 人間による手順書(ランブック)の手動解釈・実行
        │
        ▼
[AIOps 2.0 (Autonomous / Agentic Ops)]
  └─ 因果AI・LLMによる根本原因特定 → DRL・AIエージェントの自律修復 → 予防的保守・戦略的SRE活動への移行
自律型IT運用への移行を成功させるためには、自社組織が現在どの成熟度段階に位置し、どのようなステップで自律性を高めていくべきかを体系的に理解することが不可欠です。次章では、IT運用の発展段階を示す「5つの成熟度モデル」と、それを後押しする海外市場・先進スタートアップの最新動向を検証します。
第1章:自律運用における「5つの成熟度モデル」と海外市場の急速な進化
自律型IT運用への移行を安全かつ着実に進めるためには、組織の「現在地」と「到達目標」を正確にマッピングするフレームワークが不可欠です。成熟度モデルに基づいて運用実態を客観評価することは、無駄なツール投資を防ぎ、IT投資対効果(ROI)を極大化するうえで決定的な戦略的意義を持ちます。特にSRE(サイト信頼性エンジニアリング)の観点からは、SLI/SLO(サービスレベル指標/目標)の策定やエラーバジェット(Error Budget)の消化率モニタリングとAIOps 2.0の自律アクションを動的に連動させることが、投資対効果を左右する鍵となります。
5つの成熟度モデルの階層解説
IT運用の成熟度は、完全な手動対応から高度な自律運用まで以下の5つのレベルに整理されます。レベルが高まるにつれて、アラートノイズの削減率やMTTR(平均修復時間)が劇的に改善します。
| 成熟度レベル | 運用ステージ | 運用の実態と特徴 | アラートノイズ削減率 | MTTR(平均修復時間)へのインパクト |
| Level 1 | Manual | サイロ化した個別の監視ツール群。AI活用なし。すべての生アラートを人間が目視で確認・切り分け。 | 0%(生アラートが全件到達) | 2〜4時間以上(検出・切り分け・修復の全行程が手動) |
| Level 2 | Scripted / Alert Correlation | 類似アラートの自動重複排除とグループ化。定義済みルールに基づく静的スクリプトの実行。 | 80〜85% 削減 | 45〜90分(ノイズ削減により初動確認が高速化) |
| Level 3 | Rule-Based / Automated Triage | MLによる根本原因分析(RCA)の提示とチケットの自動ルーティング・優先順位付け。SLOの監視。 | 85〜90% 削減 | 18〜45分(手動切り分けと比較して40〜50%短縮) |
| Level 4 | AI-Assisted / Self-Healing | 承認済みランブックに基づく自律修復。エラーバジェット消化率に応じた修復アクション提案と人間による承認。 | 90〜95% 削減 | 18分未満(障害解決時間を65%以上短縮) |
| Level 5 | Autonomous | 多元AIエージェントと因果AIによる完全自律運用。障害の事前予兆検知と自動回避、動的SLO最適化。 | 95%以上 削減 | 数秒〜数分(人間の介在なしにシステムが自律回復) |
海外市場動向と試算モデルの複眼的検証
AIOps市場は世界的に急成長を遂げていますが、調査機関の定義範囲によって推計数値に特徴が存在します。
- 狭義のAIOpsプラットフォーム市場: Fortune Business Insightsの報告によると、コアなAIOpsプラットフォーム市場規模は2025年の22.3億ドルから2026年には26.7億ドルへ達し、2034年には118億ドル(CAGR 20.40%)へ達すると試算されています。
- 広義のAI運用・観測可能性市場: Zylos Research(およびGlobal Growth Insights)による試算では、隣接するAI観測可能性(Observability)ツールやAPM、AI運用インフラを含めた広義の市場規模として、2024年の89.1億ドルから2025年には111.6億ドルへ達し、2029年には325.6億ドル(CAGR 30.7%)に達すると推計されています。
この市場成長の裏側で極めて重要な示唆を与えるのが「採用ギャップ」の存在です。Fortune 500企業の67%がすでにAIOpsツールを本番環境へ配備しているのに対し、中堅企業(Mid-Market)での導入率は18%にとどまっています。しかし、SaaS型デリバリーの拡充や年間3万ドル未満の参入しやすい価格帯ツールの登場により、中堅企業の採用速度は急加速しています。ガートナーは、2026年末までに73%の企業が自己修復AIOpsの導入を計画し、2030年までに50%の組織がAIエージェントによるIT運用を採用すると予測しています。
主要プラットフォームおよび先進スタートアップの技術的差別化
主要プラットフォームと、YC(Y Combinator)等から台頭する先進AI Opsスタートアップ群は、明確な技術的差別化軸を展開しています。
大手プラットフォームの技術特性
- Dynatrace (Davis AI): 統計的相関に頼らず、インフラ全体の依存関係を全自動発見するOneAgentとGrailデータレイクを組み合わせ、決定論的な因果関係を特定する「Causal AI」を強みとします。
- Datadog (Bits AI SRE): 750以上のインテグレーション群を背景に、24時間常時オンコール体制で自律的にインシデント調査、依存関係解析、修復ガイダンスを行うAIチームメイトを提供します。
- BigPanda: 既存のSplunk、Prometheus、Datadog等の上に位置する「Event Hub」として機能し、独自の相関エンジンで95%以上のアラートノイズを排除します。
- PagerDuty (AI SRE): 過去のインシデント履歴をリアルタイム解析し、最適なランブックの即時提案や自動応答エスカレーションを支援します。
- Azure SRE Agent: Microsoftの観測可能性スタックと深く統合され、Azure環境における自動根本原因分析と効率的なインシデント対応を実現します。
先進スタートアップ・エコシステム
- Routant: 社外や顧客のプライベートシステムに跨がって動作するAIエージェントに対し、どのデータにアクセスしどのアクションを実行できるかを全監査ログ付きで統制する「Zero-Trustアクセス層」を提供。
- Tilo: 人間とAIエージェントが同一ワークスペースで協調動作するために設計されたLinuxベースのOS。画面のスクリーンショットを撮ってGUI操作する非効率を排除し、Model Context Protocol(MCP)経由でアプリ操作を直接統合。
- HyperProbe: ソースコードの再デプロイなしで実行中サービスへ非破壊プロブを挿入し、障害発生瞬間のメモリ内変数状態を直接読み取るリアルタイムデバッグ層を構築(CPUオーバーヘッド1%未満、自動PIIマスキング対応)。
- Alter: AIエージェント向けZero-Trustアイデンティティ制御基盤。データベースの
DROP TABLEやポリシー上限を超える決済などの危険なアクションをパラメータレベルで検証・ブロック。 - Papaya: 200以上の研究ベース解析を適用し、プロンプトの冗長化や不必要なツール呼び出しなどのコンテキスト膨張(Context Bloat)を改善するエージェント最適化エンジン。
- Mirrors / Kestrel AI / IncidentFox / Executor.sh: 過去のエラーから再発防止策をコンテキスト付与する仕組み(Mirrors)、自然言語から決定論的なインフラ操作ワークフローを自動生成するプラットフォーム(Kestrel AI)、顧客環境を自動学習するAI SREエージェント(IncidentFox)、および多様なAPI/OpenAPIをMCP経由で統一管理するゲートウェイ(Executor.sh)。
SREチームおよびベンダーエコシステムへの破壊的インパクト
これらの先進ツールの台頭は、従来のSRE(サイト信頼性エンジニアリング)運用体制に破壊的なインパクトを与えています。これまでエンジニアの業務時間の多くを占めていた「ダッシュボードの常時監視」「一次調査」「チケットのルーティング」といった機械的作業(Toil)はAIエージェントによって代替されつつあります。エンジニアはトイルの根絶によって、本来の信頼性工学の実践やシステム構造改革へ回帰することが可能になります。また、単一ベンダーによる垂直統合型スタックから、MCP(Model Context Protocol)等を介して多様なAIエージェントとツール群が動的連携するオープンな生態系へと主導権が移行しています。
成熟度レベル(Level 4〜5)に到達し、高度な自己修復を実現するためには、堅牢なAIアーキテクチャが不可欠です。次章では、生成AIの言語理解能力と深層強化学習の動的最適化能力を融合させた最先端の技術基盤について紐解きます。
第2章:技術アーキテクチャの進化(LLM × DRL × 人間の協調)
AIOps 2.0が複雑な分散インフラの自己修復を確実に行える背景には、生成AI(LLM)が持つ「高度なコンテキスト・非構造化データの意味理解能力」と、深層強化学習(DRL)が持つ「動的な環境変化に対する最適アクションの選択能力」の相互補完的なハイブリッド設計が存在します。
マルチエージェント型AI SRE Agentの動作メカニズム
最新の自律型運用アーキテクチャでは、単一のAIモデルではなく、専門化された役割を持つマルチエージェント群がリアルタイムに環境と相互作用します。
- 環境グラフと動的トポロジー構築: 監視対象(Dynatrace OneAgent等)から収集されたデータに基づき、コンテナ、マイクロサービス、データベース間の依存関係を動的な依存グラフとしてマッピングします。
- 多角的テレメトリ調査と仮説検証ツリー: ログ、メトリクス、トレースを横断解析し、AIエージェントが仮説検証ツリーを構築。「マイクロサービスAの応答遅延が、データベースBの接続プール枯渇に起因する」といった因果関係を導き出します。
- グラデュアル・トラスト(段階的信頼)に基づく権限分離: 修復アクションのリスク度に応じて権限を分離します。低リスク操作(キャッシュ消去、ログレベル変更、ノードのオートスケール)は自動実行を許可し、高リスク操作(DBフェイルオーバー、破壊的再起動)は人間による承認を必須とします。
マルチエージェント動作および意思決定データフロー
[テレメトリデータ入力 (Logs, Metrics, Alerts)]
        │
        ▼
[LLM主導型・障害意味解釈モジュール]
  ├─ 異種データのモーダル認識エンコード (f_enc)
  └─ 深層アテンション計算による状態ベクトルの抽出 (z_t)
        │
        ▼
[DRL修復ポリシー最適化モジュール]
  ├─ 高レベル・方策カテゴリ選択 (Restart, Migrate, Scale)
  └─ 低レベル・実行パラメータ設定 (Target ID, Resource Ratio)
        │
        ▼
[メモリ主導型メタコントローラー]
  ├─ 過去トラジェクトリの優先度付き経験再生 (Replay Buffer)
  └─ 未知障害に対するプロンプト・ソフトテンプレート調整
        │
        ▼
[Human-in-the-Loop 2.0 & ガバナンス制御]
  ├─ Model Context Protocol (MCP) によるツール統合 (Tilo / Executor.sh)
  ├─ 権限分離 (Gradual Trust) & シャドウモード評価
  └─ 人間による最終承認 → 本番環境への修復アクション実行
Human-in-the-Loop (HITL 2.0) とガバナンス要件
過度な自動化(Over-Automation)は、AIの誤誤認によるシステム破壊を引き起こすリスクがあります。そのため、実践的なAIOps 2.0運用では「HITL 2.0」ガバナンスが不可欠です。
- 透明性と説明可能性(Explainability): LLMが「なぜその修復選択に至ったか」をトポロジー依存関係や過去のインシデント履歴に基づいて自然言語で明確に提示し、エンジニアが瞬時に妥当性を検証できるようにします。
- Model Context Protocol (MCP) の標準採用:
Tilo(エージェント専用OS)やExecutor.sh(MCPゲートウェイ)の事例に見られるように、ツール呼び出しをMCP経由で統一することにより、安全なAPI実行と権限統制を単一レイヤーで管理します。 - シャドウモード(Shadow Mode)実行の運用的必須性: 自律修復アクションを本番適用する前に、最低2週間は「シャドウモード」で運用することが推奨されます。AIエージェントは修復プランの生成とログ記録のみを行い、実際の実行は行いません。オンコールエンジニアがそのログを事前評価・チューニングすることで、 misconfigured runbook(誤設定手順書)による破滅的トラブルを未然に防ぎます。
こうした高度な技術アーキテクチャの導入が、実際に企業の財務やIT運用プロセスにどのような定量的成果をもたらすのか、次章で具体的なデータとともに検証します。
第3章:導入効果とインパクト(定量データで見るROI)
AIOps 2.0の導入効果は、単なる「エンジニアの作業軽減」にとどまりません。障害復旧時間の劇的短縮、運用コストの削減、そしてヒューマンエラーの排除を通じて、企業経営に直接的な利益と競争力をもたらします。
核心的な定量的メトリクスの分析
1. MTTR(平均修復時間)の激減
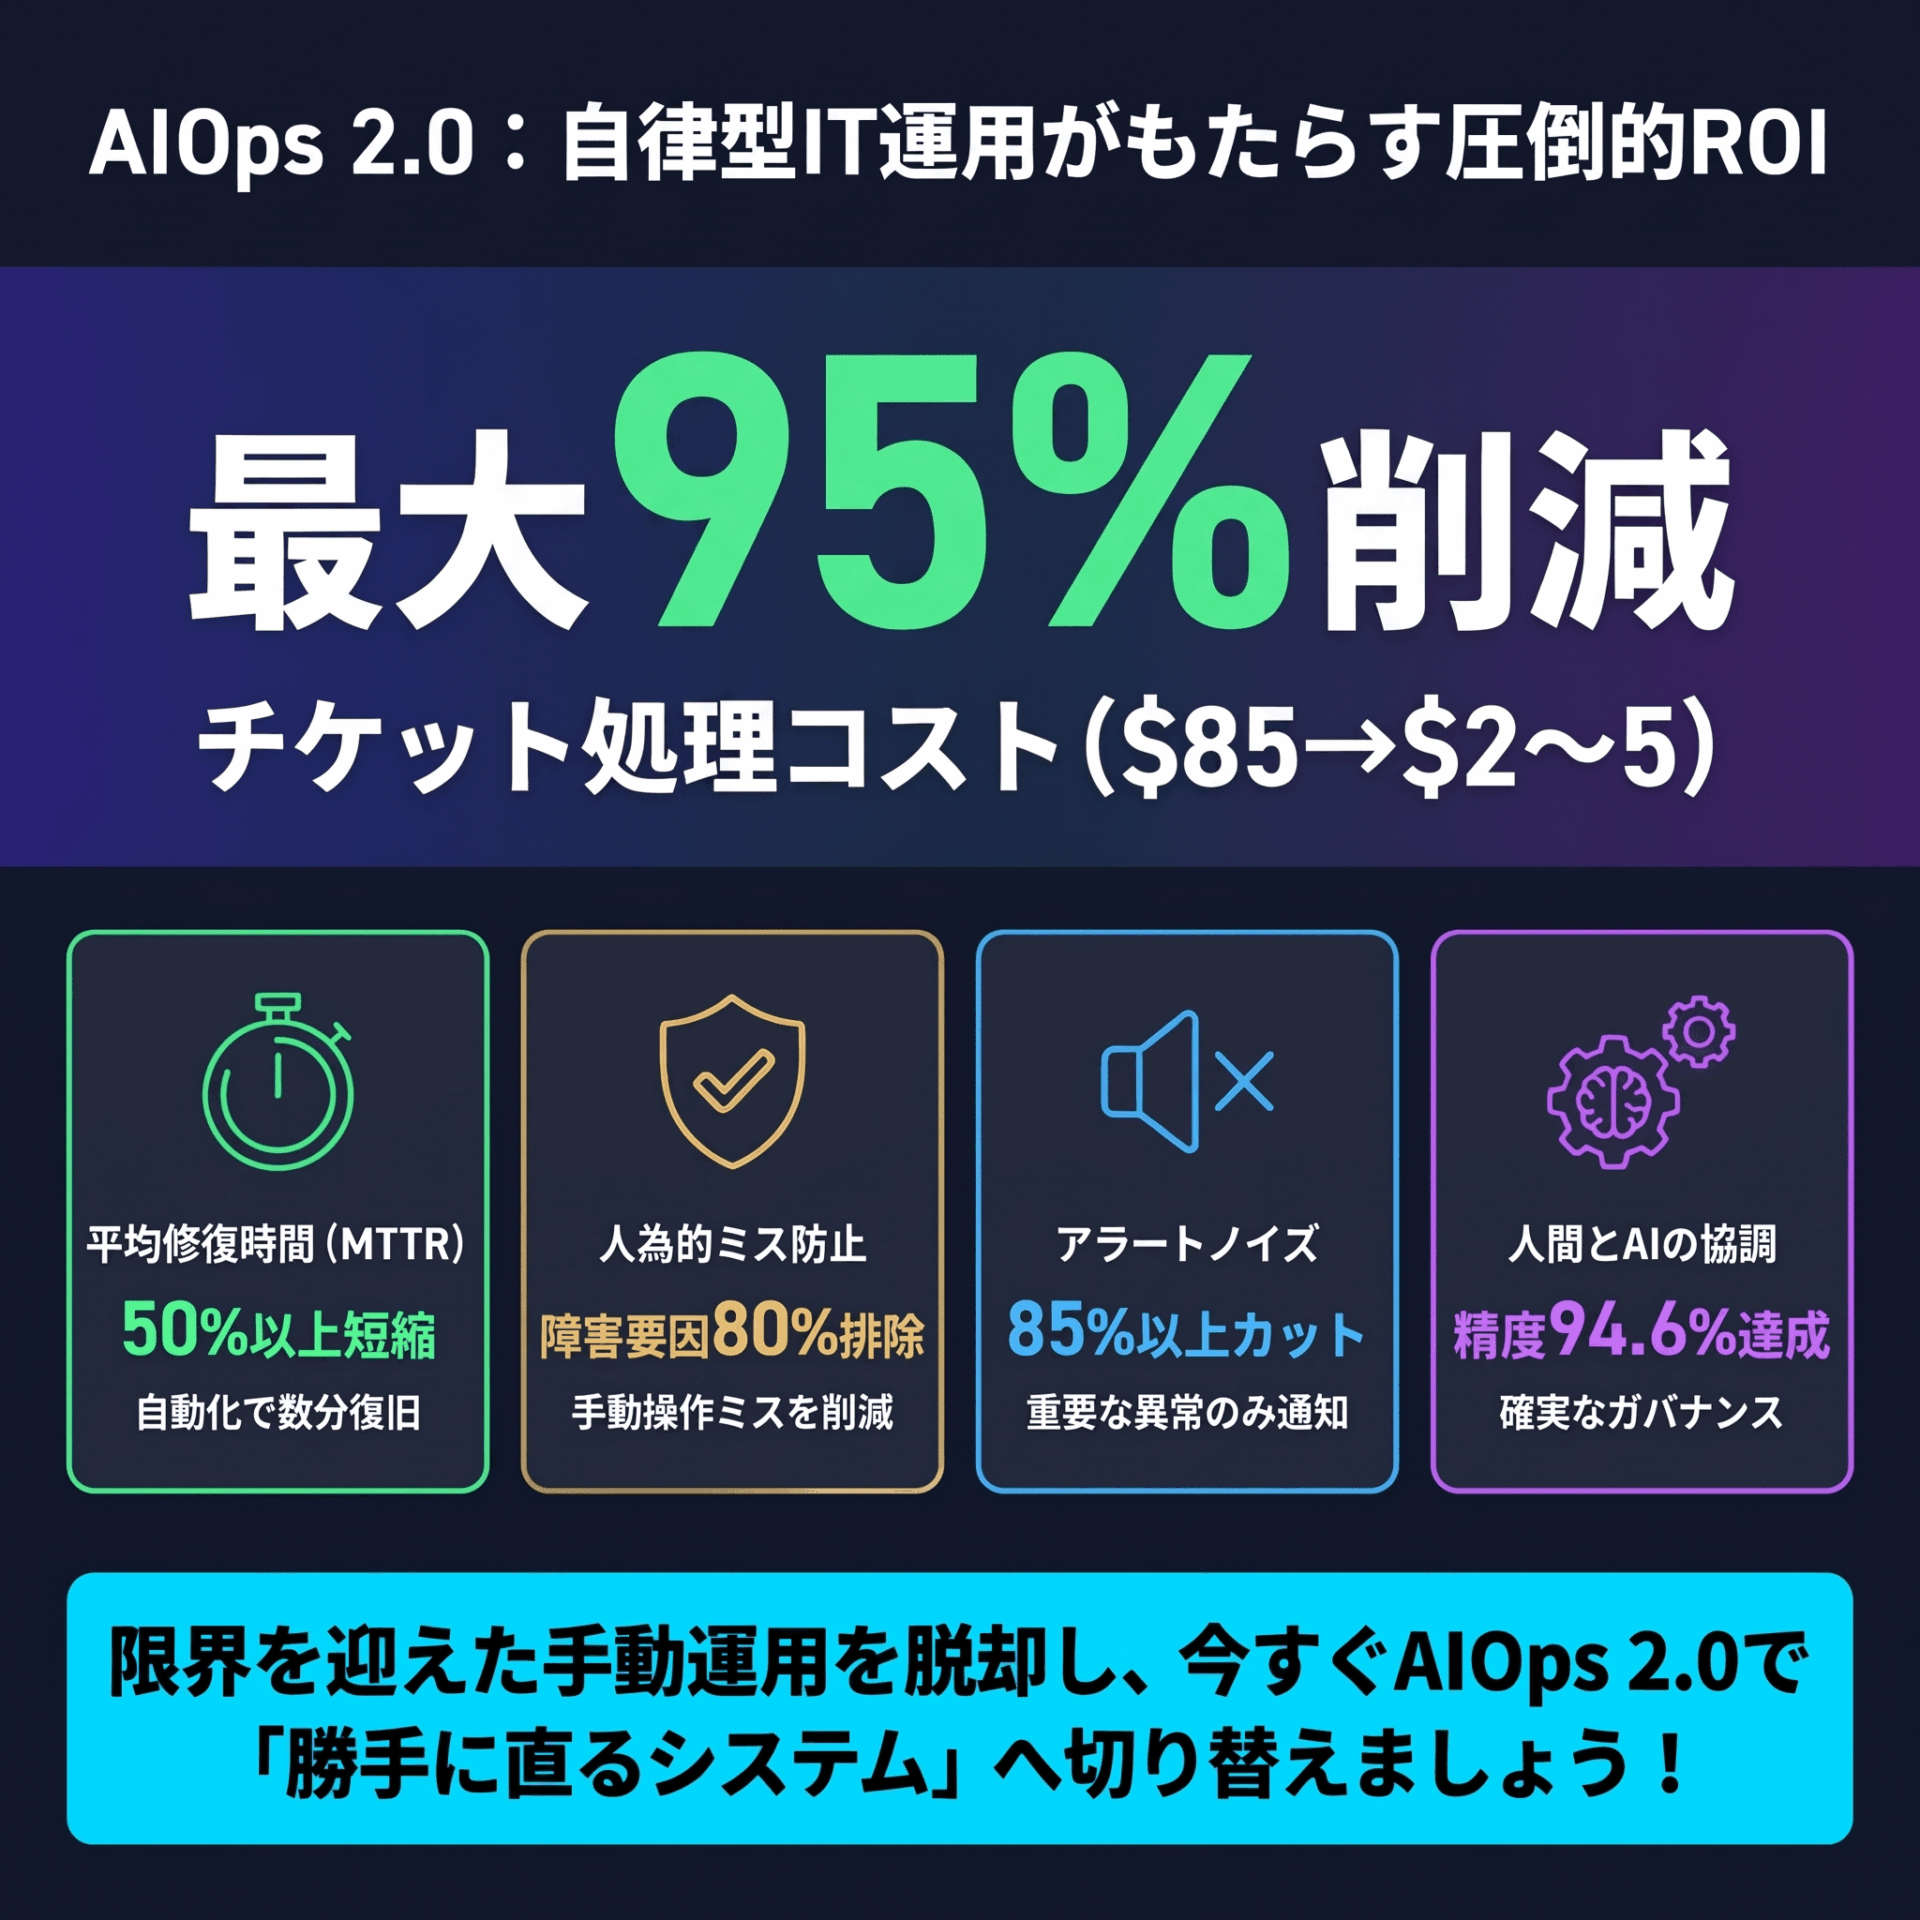
手動対応中心の従来運用における平均MTTRは2〜4時間ですが、AIOps 2.0を導入したベンチマーク組織では18〜85分(40〜60%短縮)へと短縮されます。極端な成功事例として、英BT Groupのケースでは自動アラート相関と自己修復ランブックの適用により、MTTRが2時間から85秒(97%短縮)へと削減されました。また、Microsoft AzureのTriangleシステムでは、AIによる一次分類精度97%を達成し、エンジニアがインシデントに対応するまでの時間(Time-to-Engage)を91%削減しています。
2. チケット対応コストの急減
運用サポートチケットの処理コストは、L1(一次対応)の手動対応で1件あたり平均85、L2〜L3への昇格を含めると75〜600ドルに達します(Team Computers 2026レポート)。一方、パスワードリセット、ディスク容量拡張、アクセス権限付与などの定型作業(全チケットの約67%を占める)をAIエージェントが完全自動化した場合、1件あたりの処理コストは0.50〜5ドルまで急減します。これは最大95%の削減(12倍〜17倍のコスト差)であり、劇的な財務改善をもたらします。
3. 経営的レバレッジと人員拡張効果
Team Computersの2026年レポートによると、インフラエンジニアは1日の業務時間の約40%をチケットの分類や管理事務作業に費やしています。AIOps 2.0によってこの定型作業(Toil)を解放することは、深刻なIT人材不足と採用難に直面する企業にとって、新規採用を行わずに実質的なエンジニアヘッドカウントを40%拡張することと同等の経営的レバレッジを生み出します。
4. ヒューマンエラー起因障害の抑止と損失回避ROI
IT障害の約80%は人為的エラー(手順書の不遵守、設定ミス、確認漏れ)に起因しています(Uptime Institute 2025調査)。コード化された自動手順書(Runbook Automation)やIaCガードレールの適用により、手順不順守エラーの85%、設定ミスの60〜75%が防止され、結果として人為的障害全体を30〜50%削減できます。現代のエンタープライズ企業において、1時間のダウンタイムコストは30万ドル(約4,500万円)を超えており(90%以上の企業が該当)、障害発生そのものを抑止することによる「損失回避ROI(Avoided Cost ROI)」は計り知れません。
定量的ROIベンチマーク比較表
手動運用(Manual Baseline)とAIOps 2.0自動運用(Automated Benchmark)の主要メトリクス対比は以下の通りです。
| 評価メトリクス | 手動運用ベースライン (Manual Baseline) |
AIOps 2.0自動運用ベンチマーク | 改善効果・削減幅 |
| 平均修復時間 (MTTR) | 2〜4時間 | 18〜85分(最速ケースで85秒) | 40〜60% 短縮(最大97%) |
| チケット平均対応単価 | 75〜600ドル(L1平均 85ドル) | 0.50〜5ドル(AI完全自動対応) | 最大95% 削減(12〜17倍のコスト差) |
| エンジニアのToil費やし比率 | 業務時間の40%を消費 | 10%未満に圧縮 | 実質的な人員キャパシティ拡張 |
| ヒューマンエラー起因障害率 | 全障害の約80%を占める | 手順自動化・Guardrail適用により抑止 | 人為的障害を 30〜50% 削減 |
| アラートノイズ削減率 | 0%(毎日大量の生アラート受信) | 80〜95%+ を自動圧縮・抑止 | 約85〜95% のノイズカット |
| チケット分類・Triage精度 | 77%(手動ルーティング) | 95〜99%(AI自動ルーティング) | +22ポイント向上 |
| 第一報・初動対応時間 | 4〜6時間 | 即時(AI対応で2秒未満) | 99% 削減 |
| 投資回収期間 (Payback Period) | N/A(単なるコストセンター) | 9〜18ヶ月(Level 4達成で18ヶ月ROI 300%) | 明確なROIタイムライン |
高付加価値業務へのシフト
これらの定量的改善がもたらす最大の価値は、単なる人件費カットではありません。SREエンジニアを日常的な「火消し作業(Toil)」から解放し、本質的な信頼性工学へ回帰させる点にあります。
エンジニアの工数は、プロダクトの新規機能開発、開発者体験(DX)の向上、カオスエンジニアリングを用いた分散システムの耐障害性設計といった高付加価値業務へと再配分されます。これにより、企業のデジタルプロダクトのリリース速度と信頼性が同時に高まります。
しかし、AIエージェントに強い実行権限を与える自律運用には、新たなセキュリティリスクや誤操作の危険性が伴います。次章では、自律運用が抱えるリスクと防衛策について解説します。
第4章:自律運用が抱える新たなリスクとセキュリティ対策(「AI Oops」問題)
AIエージェントにインフラの変更・修復権限を付与することは、運用効率を飛躍的に高める一方で、新たなセキュリティ上の脅威や誤操作(「AI Oops」問題)を引き起こすリスクを孕んでいます。堅牢なセキュリティガバナンスなしに自律化を進めることは、企業システムに重大な脆弱性を自ら埋め込むことと同義です。
新しいリスク概念と具体的攻撃ベクトルの検証
1. テレメトリ操作攻撃(AIOpsDoom)の具体シナリオ
悪意ある攻撃者や侵入されたノードが、改ざんされたログや意図的なメトリクス(偽のタイムアウトやメモリ枯渇通知)をシステム内へ大量注入(Injection)する攻撃手法です。
- 具体例: 攻撃者が特定のマイクロサービスから「データベース応答タイムアウト」および「メモリリーク発生」の偽ログを連続注入します。AIOpsの因果推論エンジンはこのフェイクデータに騙され、「プライマリDBノードの異常」と誤認。AI SRE Agentは正常に稼働しているプライマリDBを自動切り離し(あるいは
DROP TABLE等のクリーンアップ)を実行し、システム全体を意図的な大規模障害へと陥れます。
2. コンテキスト汚染とモデルのドリフト (Model Drift)
インフラ構成の変更や新サービスの追加に伴い、AIモデルの推推論精度が経時的に低下する現象です。適切な再学習が行われていないAIOps導入環境の少なくとも30%においてモデルドリフトが発生しており、過剰な修復アクションや誤った自動対応による二次障害が引き起こされています。
Agentic Securityと多層防御策の提示
これらの未知の脅威からシステムを防衛するためには、「エージェント向けセキュリティ(Agentic Security)」の確立と多層防御アーキテクチャの導入が必須です。
1. テレメトリサニタイズ(AIOpsShield / HyperProbe等の活用)
AIエージェントに取り込まれるデータストリームに対し、リアルタイムで改ざん検知とフィルタリングを実施します。また、HyperProbe等に組み込まれた自動個人識別情報(PII)マスキング技術を適用し、ログに含まれる機密データや顧客情報がLLMのプロンプト経由で外部へ漏洩・学習されるリスクを遮断します。
2. Zero-Trustエージェントアクセス制御(Alter, Routant等の活用)
AIエージェントに対して、長期的・広範囲な特権資格情報(Long-lived Admin Credentials)を付与することを厳禁とします。
[AIエージェント修復リクエスト発行]
        │
        ▼
[Alter Zero-Trust 認可層]
  ├─ 1. パラメータレベル検証 (破壊的コマンド `DROP TABLE` や上限超え決済を検知・即時ブロック)
  ├─ 2. 一時的資格情報 (Ephemeral Credentials) の動的発行 (有効期限:数秒〜数分)
  └─ 3. 改ざん不可なリアルタイム全監査ログ (Audit Trail) の記録 (Routant連携)
        │
        ▼
[対象インフラへの安全な修復コマンド実行]
- 一時的資格情報(Ephemeral Credentials)の発行:
Alter等のプラットフォームを活用し、修復アクション実行の瞬間にのみ、操作対象を限定した数秒〜数分で失効する短寿命資格情報を動的に発行します。 - パラメータレベルの検証(Parameter-level Authorization): コマンドの種別だけでなく、引数パラメータまでリアルタイム検証します。
DROP TABLEやポリシー上限を超えるインスタンス追加などの危険なアクションは即座に自動ブロックされます。 - リアルタイム監査ログ(Audit Trail)の確立:
Routant等のアクセス層を介し、エージェントが「いつ、どのような根拠で、どのアクションを実行したか」を完全に記録・可視化します。
3. 国際標準ガバナンスとコンプライアンスの適用
ISO/IEC 42001(人工知能マネジメントシステム)などの国際規格に準拠した管理フレームワークを構築します。また、SOC 2、HIPAA、GDPR等の業界規制に適合したガバナンス基盤の中でAIエージェントのアクションを厳密に制御します。
セキュリティ対策が不十分な自律運用は、ひとたび事故が発生した際に企業のコンプライアンス違反やブランド信頼性の失墜をもたらします。セキュリティとガバナンスの確保こそが、自律型IT運用を実現するための絶対的な前提条件です。
これらのリスクと防衛策を踏まえたうえで、組織が目指すべき将来像と具体的な導入ロードマップを最終章で総括します。
まとめ:人間とAIエージェントが協調する次世代IT運用のロードマップ
AIOps 2.0時代におけるIT運用のゴールは、人間を現場から排除することではありません。人間の洞察力・倫理的判断力と、AIエージェントの高速なデータ処理・自律実行能力を組み合わせた「Resilient and Adaptive Operations(適応力と回復力に優れたIT運用)」を確立することにあります。
SRE・IT運用の役割変化の再定義
自律型IT運用の導入に伴い、SREやIT運用エンジニアの役割は根本的に再定義されます。
- 従来の役割: アラートの監視者、生ログの手動検索者、手順書に基づく手作業の実行者(火消し役)
- これからの役割: AIエージェントの指導者(Trainer)、ガバナンスと安全ガードレールの設計者、システム全体の「信頼性アーキテクト(Reliability Architect)」
エンジニアはトイルから脱却し、AIエージェントが安全に動くための境界条件を定義し、ビジネス要求に応じたSLO(サービスレベル目標)を設計する戦略的ポジションへと移行します。
成功のための段階的導入ロードマップ(4ステップ)
自律型IT運用への変革を安全に進めるため、以下の4つのステップに沿ったスモールスタートと段階的拡大が推奨されます。
Step 1:可視化と基盤整備(Visualization & Data Foundation)
社内に散在するログ、メトリクス、トレース、イベントなどのテレメトリデータを1つの観測可能基盤(データレイク等)へ統合・標準化します。データ品質の整備なしにAIの精度は出ません。
Step 2:ノイズ削減と自動Triage(Noise Reduction & Low-Risk Automation)
アラートの相関付けによるノイズ削減を実施します。同時に、パスワードリセット、ディスク容量拡張、ソフトウェアアクセス申請など、故障リスクが極めて低く発生頻度の高い「L1チケット」の自動化からスモールスタートします。
Step 3:シャドウモード検証(Shadow Mode Execution)
自律修復(Level 4)の導入に際しては、最低2週間以上のシャドウモード運用を行います。AIエージェントが作成した修復プランを実行せずにログ出力させ、オンコールエンジニアがその妥当性を監査・検証してランブックのミスをチューニングします。
Step 4:限定的自律化と継続的学習(Controlled Autonomy & HITL 2.0)
シャドウモードで高い精度が実証された修復アクションから順に本番環境での自動実行を許可します。HITL 2.0(段階的権限付与)の承認フローを組み込みながら全社へ展開し、人間のフィードバックをモデルへ戻す継続的なPDCAサイクルを構築します。
2026年10月時点におけるAIOps 2.0と自律型IT運用について解説しました。次世代IT運用においては、AIエージェントに「呼び出しベル(Pager)」を丸投げして運用から人間が逃避するのではなく、人間とAIがそれぞれの強みを活かし合って協調する「Resilient and Adaptive Operations」の構築こそが、今後のIT運用市場における絶対的な競合優位性となると言えます。AIOps2.0(Agentic Ops)、自律型IT運用へ向け、適切な段階的ロードマップと堅牢なガバナンスを携えた変革を推進することが今求められていると言えます。
最後までお読みいただき、ありがとうございました。