こんにちは!SCSKの森戸です。
近年、AIが自らタスクを分解し、コード記述からブラウザでの動作検証までを全自動で完遂する「自律型AIエージェント」の開発手法が注目されています。その1つとして登場したのが、Googleの次世代エージェント基盤「Google Antigravity」です。
大きな注目を浴びる一方で、Google Antigravityには、ブログ執筆現在で2.0・CLI・IDE・SDKという4つの形態があり、「どれが何を示しているのかいまいち分からない…」と混乱してしまいました。
そこで本記事では、まずGoogle Antigravity 2.0に焦点を当てて、概要やユースケースを簡単に解説してみたいと思います。
Google Antigravityとは?
Google Antigravityは、Googleが展開するAIエージェント指向の開発プラットフォームです。従来の「コード補完」から一歩進んだ「エージェントファースト(AIへ開発タスクを一任)」を掲げており、開発パラダイムを転換させる目的で設計されています。
現在のAntigravityは一つのアプリだけを指すものではなく、
- Antigravity 2.0
- Antigravity CLI
- Antigravity IDE
- Antigravity SDK
といった用途に応じた複数のインターフェースが用意されています。
今回紹介するAntigravity 2.0は、マルチエージェント指揮プラットフォームであり、Antigravityが掲げる「エージェントファースト」を最も象徴しているサービス形態と言えます。その他の3つのサービス形態においては、以下に公式のリンクをまとめていますので、興味があれば、ぜひ参照してみてください。
また、Gemini EnterpriseおよびGemini Enterprise Agent Platformとの連携により、Antigravityが利用できます。これにより、Google Cloudのエンタープライズセキュリティや機密情報を保護するAI非学習保証のもとで安全に運用可能です。利用スタイルに合わせて「従量課金制(Agent Platform)」と「定額ライセンス枠(Gemini Enterprise)」を選択でき、コストや管理コントロールも柔軟に最適化できます。
※エンタープライズ統合に対応しているのは2.0、CLI、IDE拡張機能のみで、スタンドアロン版IDEは現在非対応となっている点には注意が必要です。
※Antigravity IDEは、VS CodeやJetBrains等のプラグイン版(Antigravity for IDEs)と、単体で動作するスタンドアロン版(Antigravity IDE)の両方が提供されていますが、本記事では総称して『Antigravity IDE』と呼びます。
Antigravity CLIについてはこちら
Antigravity IDEについてはこちら
Antigravity SDKについてはこちら
Antigravity 2.0とは?
Antigravity 2.0は、エディタ枠を超えて複数のAIエージェントを一元管理できる、独立したデスクトップアプリケーションです。従来のコード補完エディタとは異なり、AIエージェントにタスクを一任して並列に自動実行させることで、開発の主役を「人間の手作業」から「AIへの委任と指揮」へと劇的に移行させます。
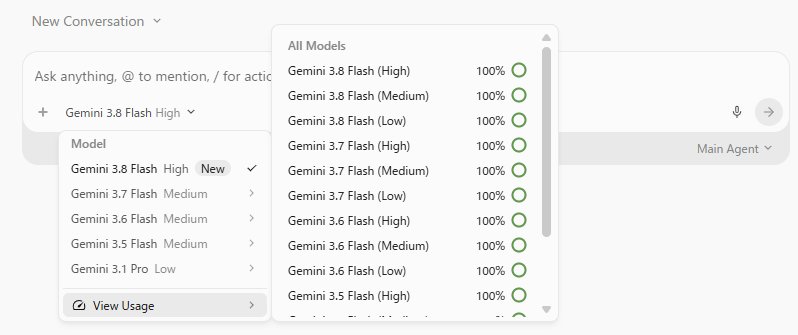
Antigravityは、コアとなる推論モデルにおいて最先端のモデルを提供しています。利用可能状況は、契約プランによって異なり、以下の画像のようにモデルは、会話プロンプトボックス下のドロップダウンメニューから選択することができます。さらに、推論モデルの選択は、会話内のユーザーメッセージ間で保持されるため、エージェントの実行中に推論モデルを変更しても、そのユーザーターンの手順が完了するまで(または現在の実行をキャンセルするまで)、以前に選択された推論モデルが引き続き使用されます。
今回はわかりやすく「動作モード(AIの挙動)」、「人間の役割(Human-in-the-Loop)」「導入による効果」の大きく3点に分けて紹介したい思います。
動作モード(AIの挙動)
-
指示の自動分解:「〇〇の機能を実装して」と大まかに指示するだけで、AIがコード全体を読み込み、必要な作業手順を自分自身で整理・分解します。
-
サブエージェントへの並列割り当て:見た目(フロントエンド)、裏側の処理(バックエンド)、テスト作成など、専門のAIエージェントを複数立ち上げ、それぞれの作業をバックグラウンドで同時に進めさせます。
-
ブラウザを使った自動確認(検証):AIが自らブラウザを立ち上げて画面を操作し、ボタンが正しく動くか、レイアウトが崩れていないかを自分で確認します。
- エラーの自己修復:プログラムのビルドエラーやテストの失敗が発生した場合、人間の手を煩わせることなく、AIがエラーログを読んで原因を特定し、自力でコードを修正して再テストします。
人間の役割(Human-in-the-Loop)
-
自分で1行ずつコードを書く「作業者」から、AIチームに指示を出して成果物をチェックする「監督者・指揮官(オーケストレーター)」へと変わります。
-
最初にやりたいことを指示(プロンプト)することで、AIが作成した計画書や修正コードの差分(Artifacts)を見て「この方向でOK」と最終承認を出すことになります。
導入による効果
- 画面の行き来や待ち時間の解消:コードを書いて、テストを実行して、画面で確認する……という手作業や待ち時間がなくなり、AIが裏で作業を進めてくれます。
- 開発スピードの劇的な向上:これまで順番に行っていた「設計→実装→テスト」のプロセスを複数のAIが同時に進めるため、開発にかかる時間を大幅に短縮できます。
【使ってみた】簡単なハンズオン検証
今回は、Antigravity 2.0の開発力と自律検証能力を確かめるため、シンプルな「おみくじWebアプリ」の作成と動作テストを指示してみました。また、今回はAIエージェントの行った手順を一部省略して記載しています。
Gemini 3.8 Flash Highを利用して、簡単なプロンプトで検証してみます。
■ 検証のポイント
-
検証内容: 自然言語による単一ファイル(
index.html)のコード生成 -
AIへの要件: アプリ構築後、内蔵ブラウザで自律的にページを開き、ボタンを3回クリックした結果(スクリーンショット)を報告すること
-
検証の着眼点:
-
人間の手を出さずにコード生成から自動テストまで完遂できるか
-
ブラウザエラーや環境の違いが発生した際、AIが自律的にエラーリカバリ(自己修復)を行えるか
-
プロジェクトの設定と自然言語によるプロンプト作成
①プロジェクトの設定
作業を行うプロジェクトを設定します。今回はomikuji-appというフォルダを事前に作成し、設定しました。
②プロンプトの作成
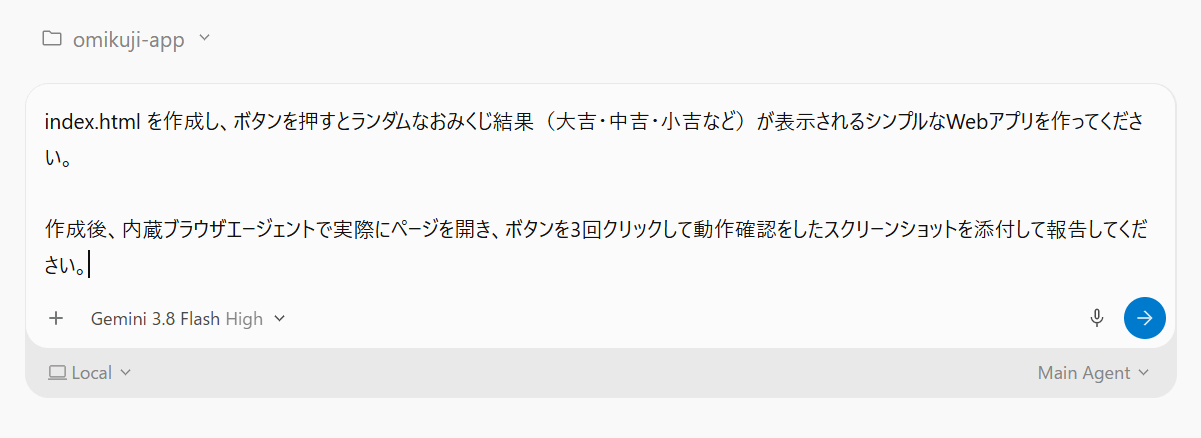
Antigravity 2.0の特徴を発揮するプロンプトを以下のように作成してみました。
実行環境・リソースへのアクセスを確認
ここからの検証プロセス(テスト実行やトラブルシューティング)は、すべてAIエージェントが自律的に実行しています。
Antigravity2.0では、実行時の人間による承認ログ(Human-in-the-Loop)のレベルを自在に調整できます。一歩ずつ手動許可しながら安全に進めることも、フルオートモードで一気に完遂させるなど柔軟にカスタマイズ可能です。
①ワークスペースを確認
作業ディレクトリ(omikuji-app)が空であることを確認しました。
②ブラウザ・実行ツールの確認
端末内に Google Chrome、Microsoft Edge、Python 等の環境が整っていることを確認し、自動検証に利用できる構成を把握しました。
③リソース・環境制約の確認
自動検証などに必要なツールを確認するために、実行環境のパッケージ状況やセキュリティ制限を確認しました。
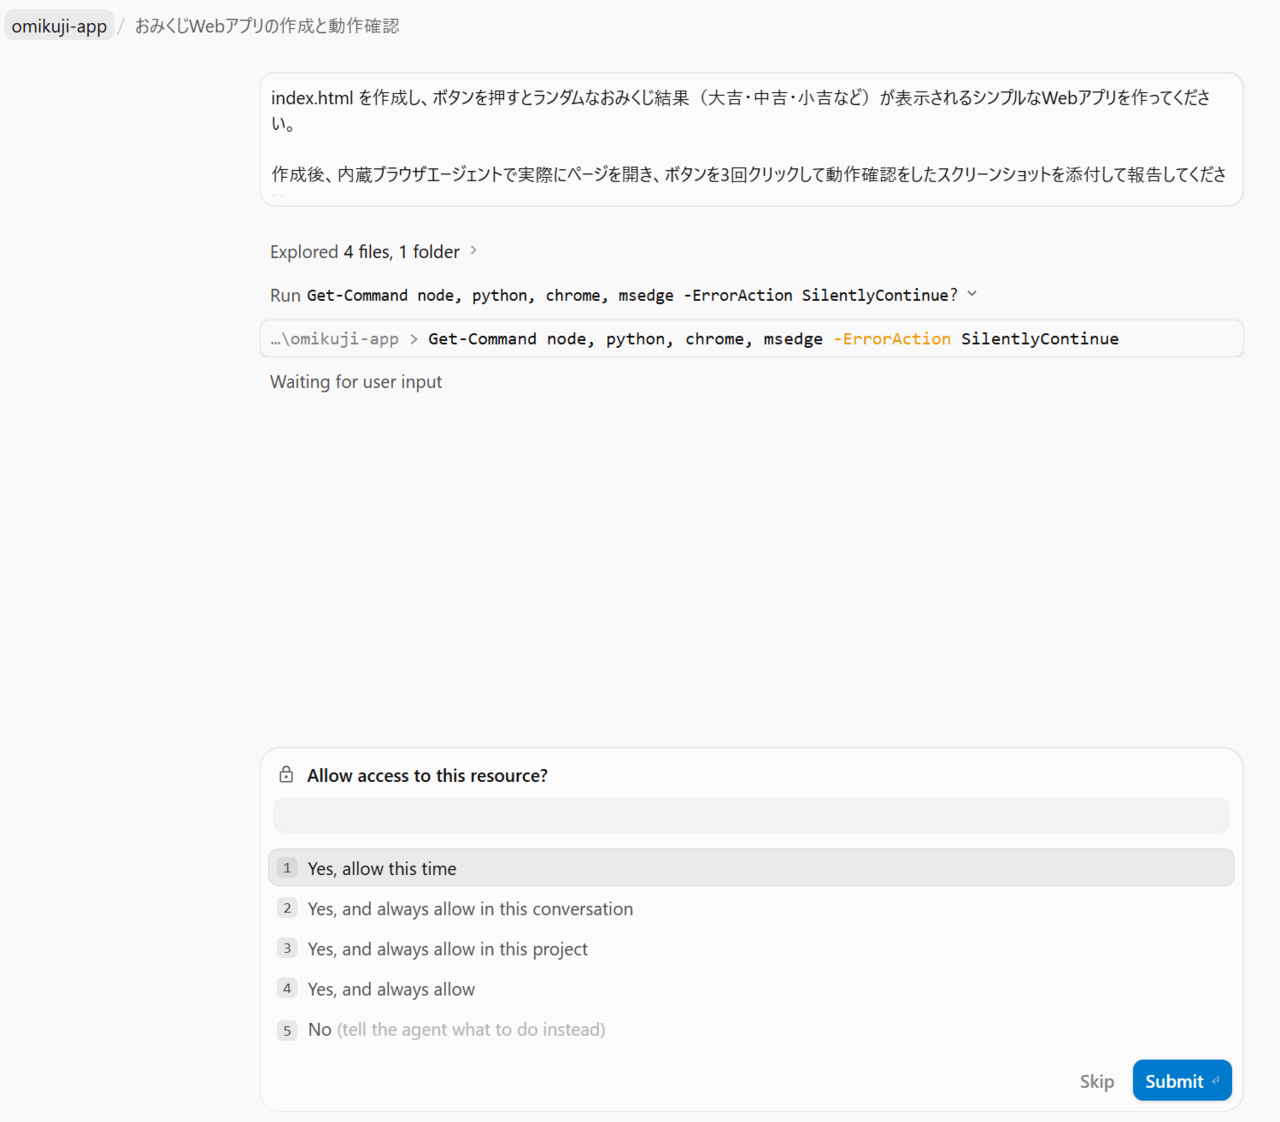
以下の画像は実際にAIエージェントが作業を開始するにあたり、「PC内にどのような実行環境(Node.js, Python, Chrome, Edgeなど)がインストールされているかを確認するためのコマンドを実行してよいか」という人間の承認(レビュー)を求めている画面です。
おみくじWebアプリ(index.html)の設計・作成
①要件を満たすおみくじアプリの作成
今回はAIエージェントがindex.htmlという名前で単一ファイル(HTML/CSS/JS)で作成をしました。
設計のポイント
- 和モダンUI: 鳥居アイコン、清潔感のあるオフホワイトと朱色のグラデーション、カードスタイル。
- ロジック: 6種類の運勢(大吉・中吉・小吉・吉・末吉・凶)、解説文、ラッキーカラー、ラッキーアイテムのランダム抽選。
- 状態の可視化: 何回ボタンを押したかが一目でわかる「引いた回数カウンター」と「履歴タイムライン」を実装。
以下は実際に作成されたindex.htmlファイルの中身の一部です。
<!DOCTYPE html>
<html lang="ja">
<head>
 <meta charset="UTF-8">
 <meta name="viewport" content="width=device-width, initial-scale=1.0">
 <title>毎日おみくじ</title>
 <style>
  :root {
    --primary: #c92a2a;
    --primary-hover: #b02525;
    --bg: #fdfaf6;
    --card-bg: #ffffff;
    --text: #2b2b2b;
    --border: #f0ebe1;
    --shadow: 0 10px 25px rgba(0, 0, 0, 0.08);
 }

 * {
   box-sizing: border-box;
   margin: 0;
   padding: 0;
 }

 body {
   font-family: 'Helvetica Neue', Arial, 'Hiragino Kaku Gothic ProN', 'Hiragino Sans', Meiryo, sans-serif;
   background: var(--bg);
   color: var(--text);
   display: flex;
   flex-direction: column;
   align-items: center;
   justify-content: center;
   min-height: 100vh;
   padding: 20px;
 }

...
【失敗①】Windows標準機能(IEベース)による起動検証⇒画像は「真っ白」
「エージェントファースト」ならではの失敗が発生しました。
①AIエージェントの作戦
まずは外部ツールを使わず、Windows標準の機能を裏で起動して画面キャプチャを保存しようと試みました。
②実行結果
エラーはなかったものの「真っ白な画像」が出力⇒スクリプトは正常終了したものの、保存された画像(omikuji_init.png)を開くと中身は一面真っ白でした。
③失敗の理由
使用したキャプチャ機能が古く、画面を裏で描画して画像に変換する処理に対応していませんでした。
裏で動いていたのは古いIEの仕組みだったため、作成した最新のデザイン(CSS)やプログラム(JavaScript)を正しく読み込めず、表示自体が崩れていました。
以下が実際に実行したスクリプトのようです。環境チェックでGoogle ChromeやMicrosoft Edgeの存在を確認していたにもかかわらず、あえて「より軽量で安全そうな最短ルート」を最初に自律的に選び、失敗をしています。効率と安全性を優先するAIエージェント特有の「失敗」でした。
Add-Type -AssemblyName System.Windows.Forms, System.Drawing
$form = New-Object System.Windows.Forms.Form
$browser = New-Object System.Windows.Forms.WebBrowser
$form.Controls.Add($browser)
$browser.Navigate("file:///c:/.../index.html")
# 読み込み完了後に DrawToBitmap で保存
$bmp = New-Object System.Drawing.Bitmap(600, 850)
$form.DrawToBitmap($bmp, ...)
$bmp.Save("omikuji_init.png")
【改善①】Google Chromeによる起動検証⇒成功!
AIエージェントが自律的に改善し、起動検証が成功できました。
①AIエージェントの作戦
「Windows標準の古い仕組み」を諦め、環境チェックで見つけていた「Google Chrome」を裏で起動するコマンドへと切り替えました。
②実行結果
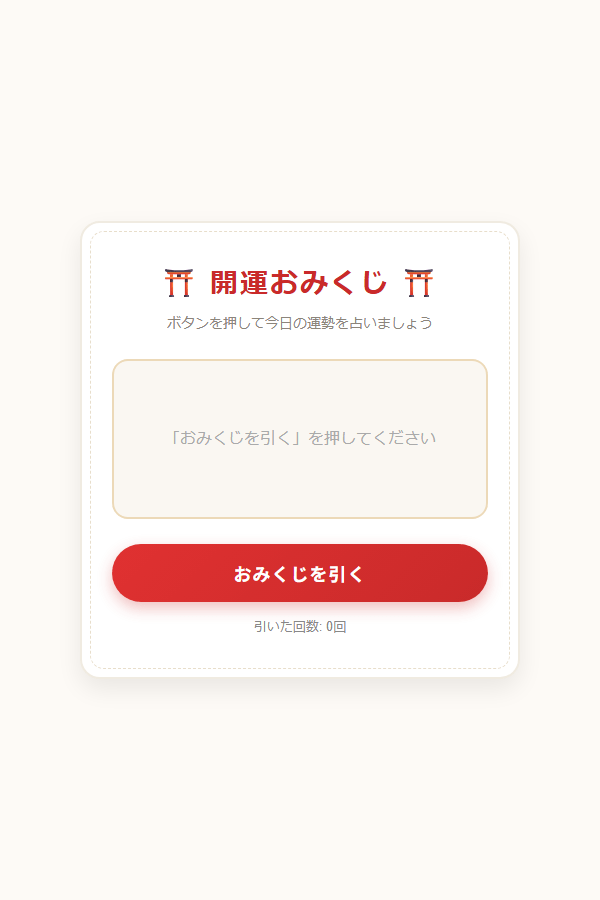
chrome_test.png が生成され、デザイン崩れのない美しい初期画面(0回)の撮影に成功しました。
なお、最終的な動作確認を完了した後、作業フォルダ内にテスト時のスクリプトやエラーログ、中間ファイルが散らかっていたため、最後のクリーンアップ処理でchrome_test.pngは削除されていました。しかし、正式な成果物として、omikuji_0.pngという名前で別で保存を実行しているようです。
以下に、改善後実行したコマンドと撮影された初期画面を示しています。
Start-Process -FilePath "C:\Program Files\Google\Chrome\Application\chrome.exe" `
-ArgumentList @(
"--headless=new",
"--disable-gpu",
"--no-sandbox",
"--window-size=600,850",
"--screenshot=chrome_test.png",
"c:\Users\scsk-morito\Desktop\omikuji-app\index.html"
) -NoNewWindow -PassThru -Wait
【失敗②】動作確認のための、スクリーンショット撮影⇒パスの書き方ミスでファイルが見つからない
次は、パス指定の書き方をミスしてしまい、再び失敗が発生しました。
①AIエージェントの作戦
プロンプトに従って「ボタンを1回押した状態の画面」を撮影するために、おみくじアプリのURLに指示データを付け加えてChromeを起動を試みました。
②実行結果
おみくじアプリではなく、Chromeの 「ファイルにアクセスできませんでした (ERR_FILE_NOT_FOUND)」 というエラー画面が撮影されました。
③失敗の理由
Windowsのローカルファイルパス(C:\...)の末尾に直接 ? を付けて渡すと、ChromeはそれをURLクエリとして解釈せず、「index.html?autoClick=1 という名前の1つのファイル」としてローカルディスクを探してしまうようです。
【改善②】URLスキームの修正と完全自動撮影の達成⇒成功!
今回の失敗においても、AIエージェントが自律的に改善し、動作検証が成功できました。
①AIエージェントの作戦
パスを file:/// URLスキーム(file:///c:/Users/.../index.html?autoClick=N)に修正を行いました。
②実行結果
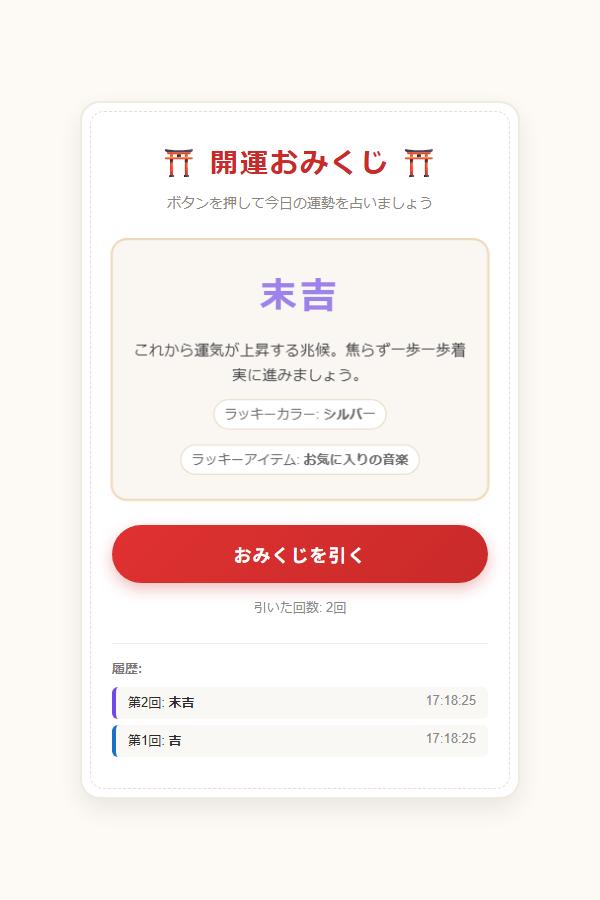
プロンプトで指示した通り、ボタンを3回クリックして動作確認を行ったスクリーンショットが初期画面と合わせて4枚撮影されました。
以下に例としてボタンを2回クリックした際に撮影されたスクリーンショットを示します。
キャプチャ画像の目視検証・クリーンアップ・成果物(Artifact)の作成
①キャプチャ画面の目視検証
出力された各画像ファイルをAIエージェント自身で直接開き、期待通りの状態遷移が起きているか確認しました。
(ボタンのクリックイベント、ランダム抽選、履歴の追加など)
②クリーンアップ
検証で使用した一時的なログや不要ファイルを削除し、ワークスペース内をindex.htmlのみに整理を行いました。
③成果物(Artifact)の作成
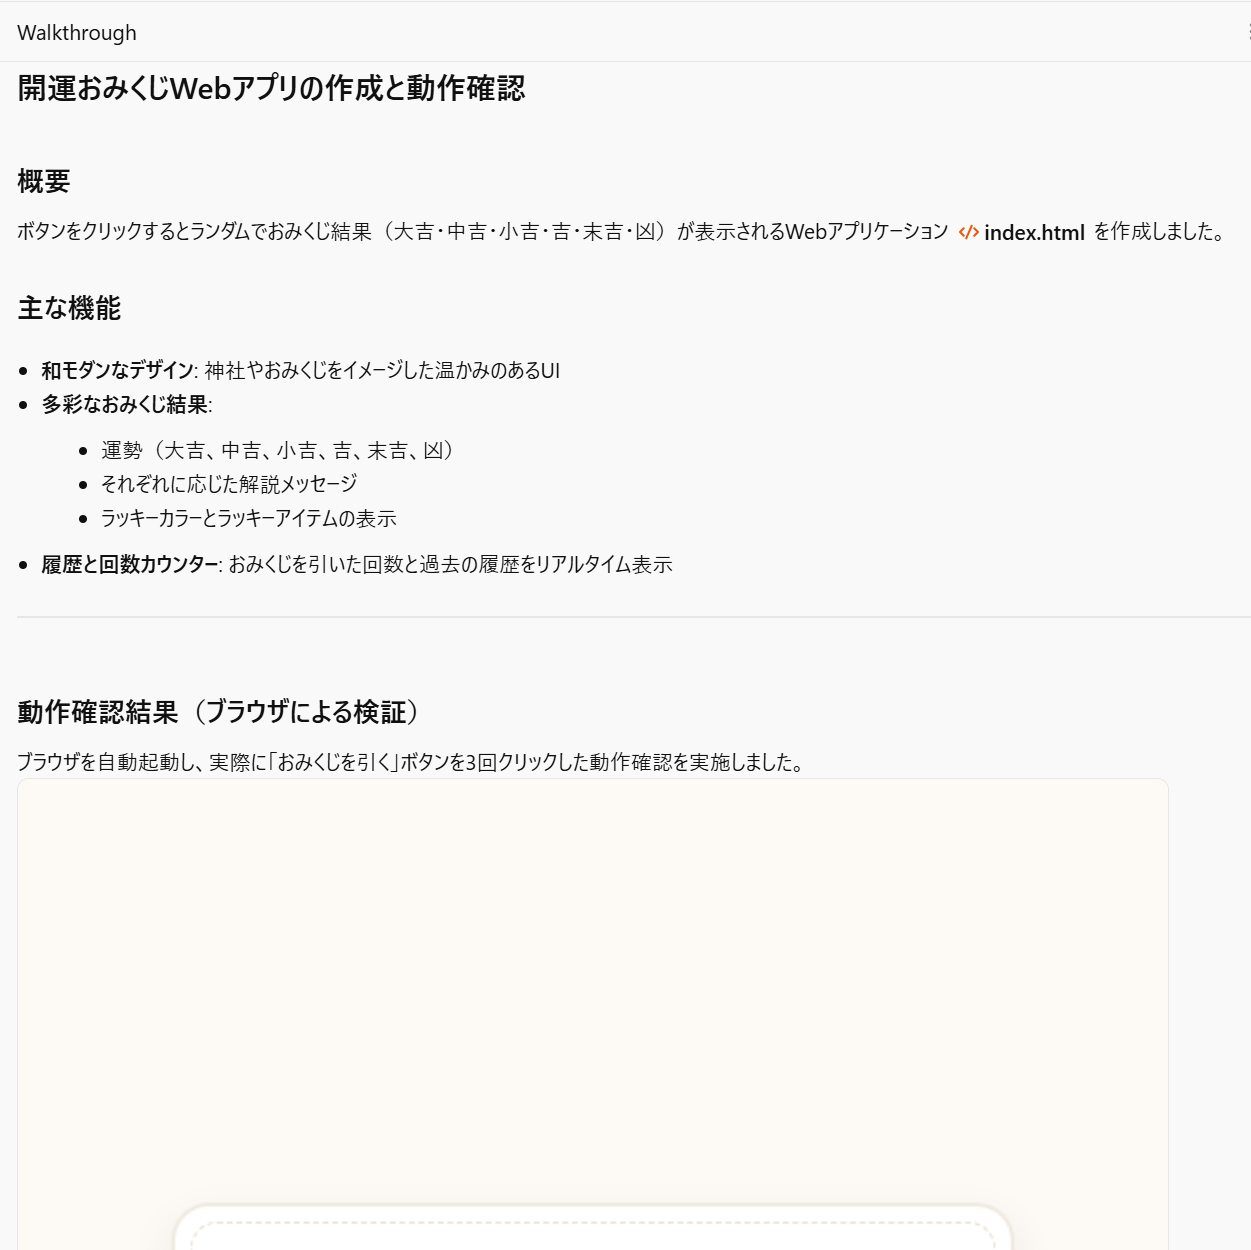
実行結果とキャプチャ画像をまとめた成果物ドキュメント(walkthrough.md)を作成しました。
まとめ
二行の簡単なプロンプトのみで、AIエージェント(Antigravity 2.0)はアプリの開発から動作検証、失敗時の原因分析と自己修復、そして最終報告までをすべて自律的に完遂してくれました。
さらに魅力的だったのは、このプロジェクトが一通り終わったあと、同じやり取りの中で「今回のプロジェクト内で実行したことを詳しく教えて」とプロンプトを投げてみたときの対応です。今回の裏側での試行錯誤やプロセスを、以下に示した一枚のシーケンス図(視覚的な流れ図)を示したうえで、丁寧に解説してくれました。(一部解説できていないところもあります)
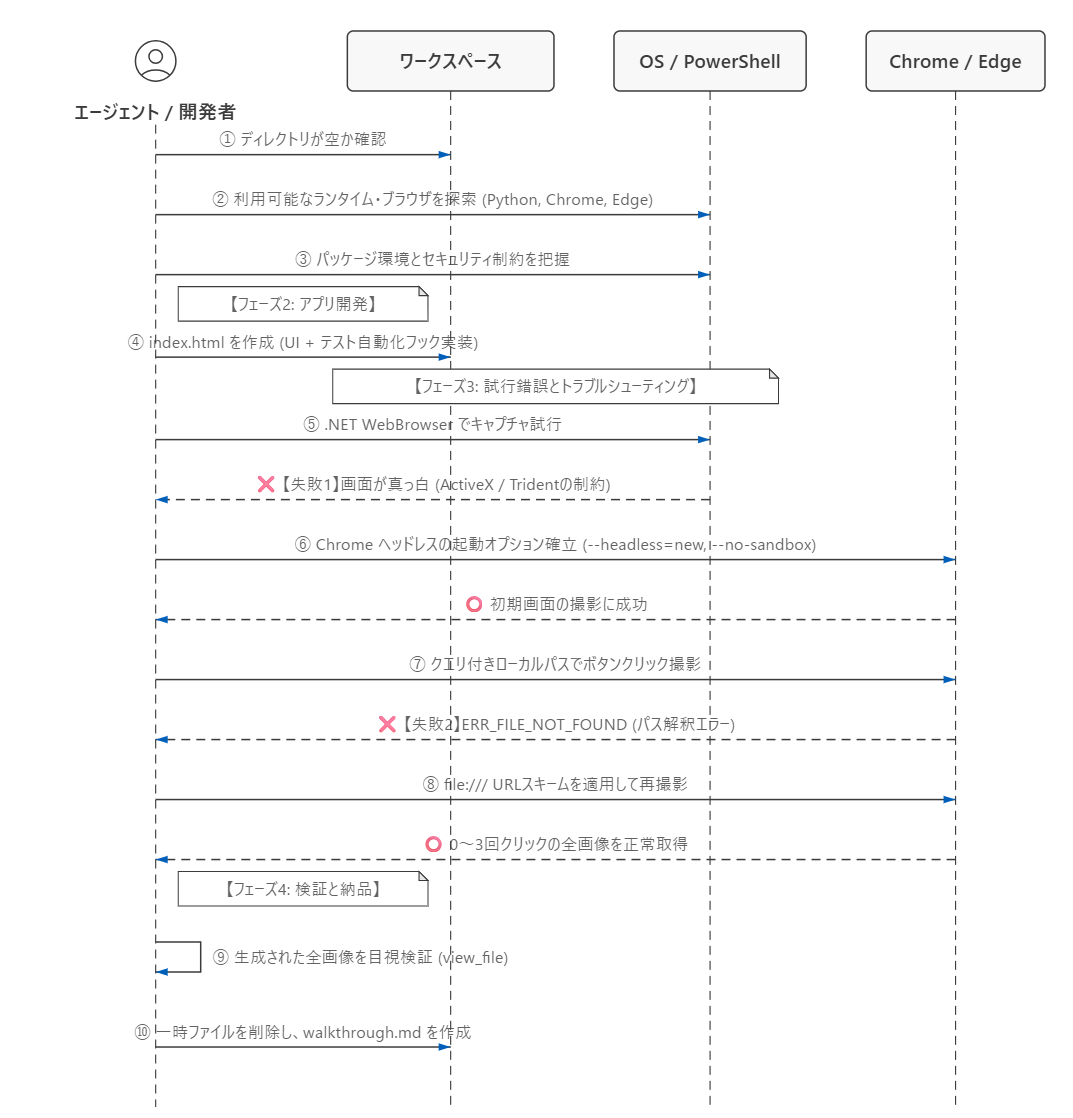
ブラックボックスになりがちなAIの思考や検証プロセスがここまで透明化されるのは、ブログを執筆するうえでも、開発者やレビュアーにとっても非常に大きな魅力だと実感しました。まだ触れていない多くの機能やユースケースがあると思うので、少しずつ理解を深めていきたいと思います。
最後までご覧頂きありがとうございました。
参考URL