こんにちは、関根です。
生成AIで業務を自動化しようとすると、たいていの場面でまずLLMを呼びます。メールの仕分け、優先度の判定、担当への振り分け。どれも「LLMに聞けばできる」ので、そのまま組んでしまいがちです。
ただ、こうした処理をよく見ると、実際にほしいのは文章ではなく「障害かどうか」「どの区分か」「どの製品か」という数個の値だけです。文章を生成する能力をフルに使う必要はありません。それでもLLMに任せようとすると、判定そのものとは別に、出力形式を固定するための指示、構造化された結果を取り出す処理、想定外の出力に備えた例外処理など、周辺に定型的なロジックが必要になります。生成AIで柔軟にしたはずなのに、そのAIを安定して使うために、結局また定型処理を書いている。
今回は、そこを別の道具でやってみます。TypeSafe AIが2026年9月15日に公開したばかりのJevです。Jevは、そもそも文章を返さず、ソフトウェアの中で使う「判断」に特化したモデルです。公開直後から開発者の間で注目を集めており、ここ数日で一気に話題になっています。
会計システムのサポート窓口に届いた問い合わせ100件を一次判定させ、同じ100件を Amazon Bedrock の Claude Sonnet 4.6 にも同じ条件で判定させて、速度・コスト・判定結果を並べて比べました。
先に結論を書いておくと、判定結果はほぼ一致し、処理時間は約6.5倍、コストは約150倍の差がつきました。以下、順番に見ていきます。
今回作ったデモ
題材は「会計ソフトのサポート窓口に届いた問い合わせメールを一次判定する」というものです。受信トレイに100件のメールが並んでいて、ボタンを押すと全件をAIが判定し、ダッシュボードに集計が出る、という画面をNode.jsで作りました。
判定させるのは次の3つです。
- 障害かどうか(0〜1の確率)
- 問い合わせ区分(障害 / 質問 / 要望 / その他)
- 対象製品・モジュール(財務会計、勤怠、給与……全20区分)
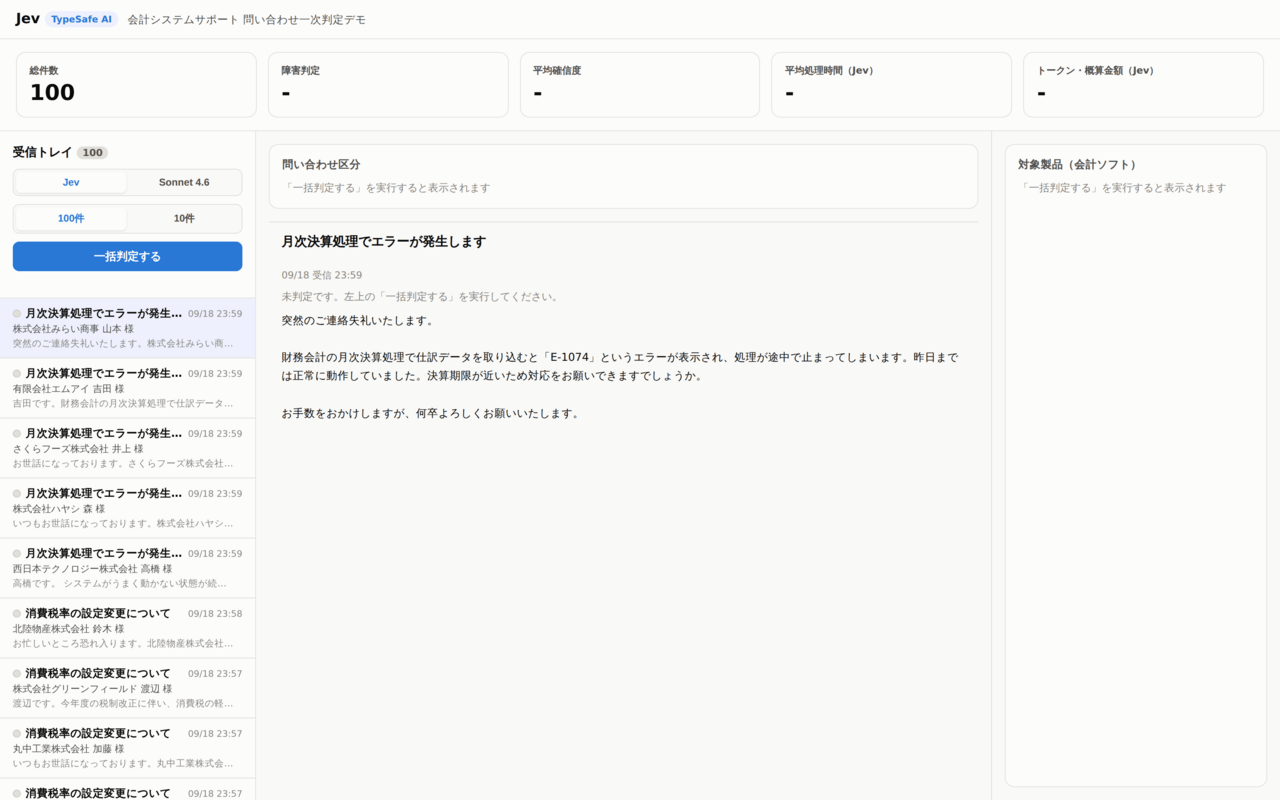
メール本文は実データではなく、会計・人事・勤怠・販売といった領域にばらけるように生成した架空のサンプル100件です。会社名・担当者名・メールアドレスもすべて架空のものを使っています。
Jevとは何か
TypeSafe AI が公開している「System One Model」の第一弾が Jev です。公式ドキュメントの言葉を借りると、人間と会話するためではなく「ソフトウェアの中で判断を下すため」に設計されたモデル、という位置づけになっています。
System One / System Two というのは、行動経済学でいう「速い思考 / 遅い思考」の比喩です。じっくり考えて文章を組み立てる仕事(System Two)はLLMが得意ですが、業務システムの中で毎秒発生する「これは障害か?」「どっちに振り分けるか?」という判断(System One)は、本来もっと速くて安くていいはずだ、という主張です。
技術的に見たときのLLMとの違いは、出力が文字列ではなく「型のついた決定値」である点です。結果として返ってくるのは、選択肢とその確率分布、そして「その判断にどれくらい自信があるか」という確信度です。
要するに「文章を書かないAI」です。だからこそ、出力をパースする必要も、フォーマットが崩れる心配もありません。
TypeSafeのAPIは「質問の型」で組み立てる
TypeSafeのAPIは、エンドポイントが1本だけという非常に素っ気ない作りです。
POST https://api.typesafe.ai/v1/systemone
Authorization: Bearer $TYPESAFE_API_KEY
Content-Type: application/json
リクエストに入れるのは3つだけです。
| 項目 | 説明 |
|---|---|
| state | 判定対象のコンテキスト(自由記述のテキスト)。例:「件名: 月次決算処理でエラーが発生します(以下、メール本文)」 |
| model | 使用するモデル名。今回はjev-latest |
| questions | 名前付きの質問マップ(詳細は後述) |
質問には次の3つの型(プリミティブ)が用意されていて、1回のコールに混在させられます。
| 型 | 用途 | 戻り値 |
|---|---|---|
| noul | Yes/Noの判定 | 0〜1の真偽度 |
| choice | 選択肢から1つ選ぶ | 選ばれた選択肢 + 全選択肢の確率分布 + 確信度 |
| score | 順序のある評価軸で採点する | 確率で重み付けされたスコア + 確信度 |
実際に投げているリクエスト
今回のデモが投げているリクエストはこうなります。3つの判定を1回のAPIコールにまとめています。
※scoreの実装は省略しています
{
  "model": "jev-latest",
  "state": "件名: 月次決算処理でエラーが発生します(以下、メール本文)",
  "questions": {
    "is_incident": {
      "type": "noul",
      "instructions": "この問い合わせは、システムが正しく動作しない・エラーが出る・異常終了するといった「障害」ですか?(操作方法の質問や機能追加の要望は含まない)"
    },
    "inquiry_type": {
      "type": "choice",
      "instructions": "この問い合わせの区分は何ですか?",
      "criteria": {
        "障害": "システムの不具合、エラー、動作しない、異常終了などの報告",
        "質問": "操作方法や仕様、設定についての質問",
        "要望": "機能追加や改善の要望",
        "その他": "上記のいずれにも該当しない問い合わせ"
      }
    },
    "product": {
      "type": "choice",
      "instructions": "この問い合わせは会計ソフトのどの製品・モジュールに関するものですか?",
      "criteria": {
        "財務会計": "会計 ・ 仕訳・決算・財務諸表",
        "勤怠": "人事・給与 ・ 勤怠管理(打刻・休暇・残業などの管理)",
        "…(全20区分)": "…"
      }
    }
  }
}questionsの中身は、質問ごとに名前を付けたオブジェクトです。inquiry_type(問い合わせ種別の判定)を例に、各項目の意味を整理するとこうなります。
"inquiry_type": {
  "type": "choice",
  "instructions": "この問い合わせの区分は何ですか?",
  "criteria": {
    "障害": "システムの不具合、エラー、動作しない、異常終了などの報告",
    "質問": "操作方法や仕様、設定についての質問",
    "要望": "機能追加や改善の要望",
    "その他": "上記のいずれにも該当しない問い合わせ"
  }
}| 項目 | 説明 |
|---|---|
| inquiry_type(キー名) | 質問の名前。自由に設定でき、そのままanswersのキーとして返ってくる |
| type | 質問の型。noul / choice / score のいずれか |
| instructions | 何を判定してほしいかを書く指示文 |
| criteria | choice型のときに使う、選択肢名と意味の定義。noul型では不要 |
注目してほしいのは、「あなたはサポート担当です」「JSON形式で出力してください」といったプロンプトが一行もないことです。書いているのは、聞きたいこととその選択肢の定義だけ。役割設定も出力形式の指定も要りません。
返ってくるレスポンス
上のリクエストに対する実際の戻りがこちらです(製品の確率分布は0のものを省略しています)。
{
  "model": "jev-1.13.0",
  "answers": {
    "is_incident": {
      "type": "noul",
      "noul": 0.97
    },
    "inquiry_type": {
      "type": "choice",
      "choice": "障害",
      "confidence": 1,
      "probabilities": { "障害": 1, "質問": 0, "要望": 0, "その他": 0 }
    },
    "product": {
      "type": "choice",
      "choice": "財務会計",
      "confidence": 1,
      "probabilities": { "財務会計": 1, "債権管理": 0, "管理会計": 0, "…": 0 }
    }
  },
  "usage": { "input_tokens": 1284, "output_tokens": 308 }
}
ポイントは3つあります。
| 用語 | 説明 |
|---|---|
| answers | リクエストのquestionsのキーが、そのままanswersのキーになります。何がどの順で返るかを心配する必要がなく、answers.inquiry_type.choiceで直接取り出せます。 |
| confidence | その判断自体の確信度です。「confidence 0.9未満は人間が確認する」といったルールを、後付けのヒューリスティックではなくモデルの出力そのもので書けます。 |
| probabilities | 選択肢ごとの確率分布です。分布が割れていなくても確信度が低いことはあり得ます。 |
アプリ側のコードも、その分だけ短くなります。questionsの中身をそのまま定数にしたのが、下のコードのQUESTIONSです(先ほどのis_incident / inquiry_type / productの3つが入っています)。
const res = await fetch('https://api.typesafe.ai/v1/systemone', {
  method: 'POST',
  headers: {
    Authorization: `Bearer ${process.env.TYPESAFE_API_KEY}`,
    'Content-Type': 'application/json',
  },
  body: JSON.stringify({ state, model: 'jev-latest', questions: QUESTIONS }),
});
const { answers } = await res.json();
エラーは 401(認証)、422(リクエストの検証エラー)、429 / 529(レート制限・過負荷)が定義されています。429 / 529だけリトライする、という素直な実装で足ります。
100件を一括判定してみる
デモ画面の「一括判定する」ボタンで、サンプル100件を並列6で処理します。
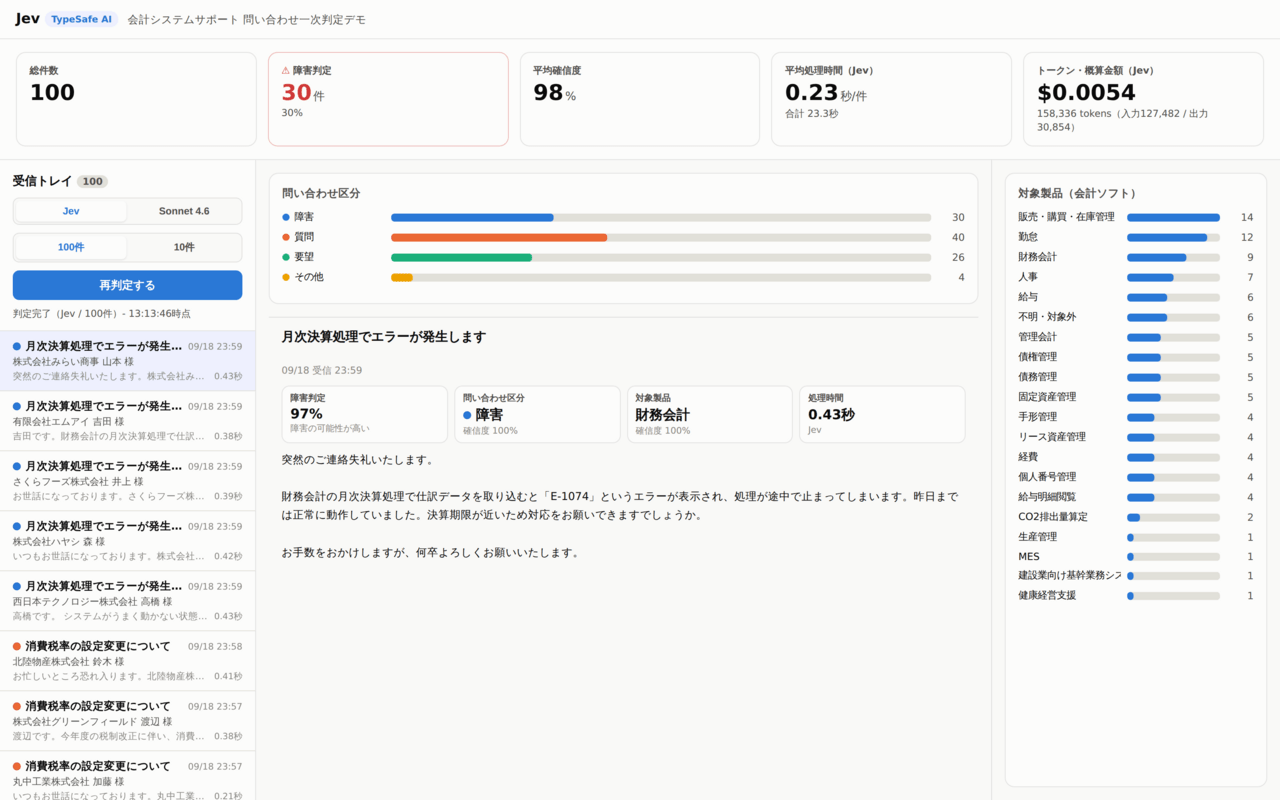
1件あたりの平均処理時間は0.23秒、100件分の処理時間を単純合計しても23.3秒。並列で流しているので、画面上の体感は「押したら出る」に近い速さです。
個別の判定結果はメールを選ぶと確認できます。障害である確率、区分、対象製品、そして確信度がそれぞれ表示されます。
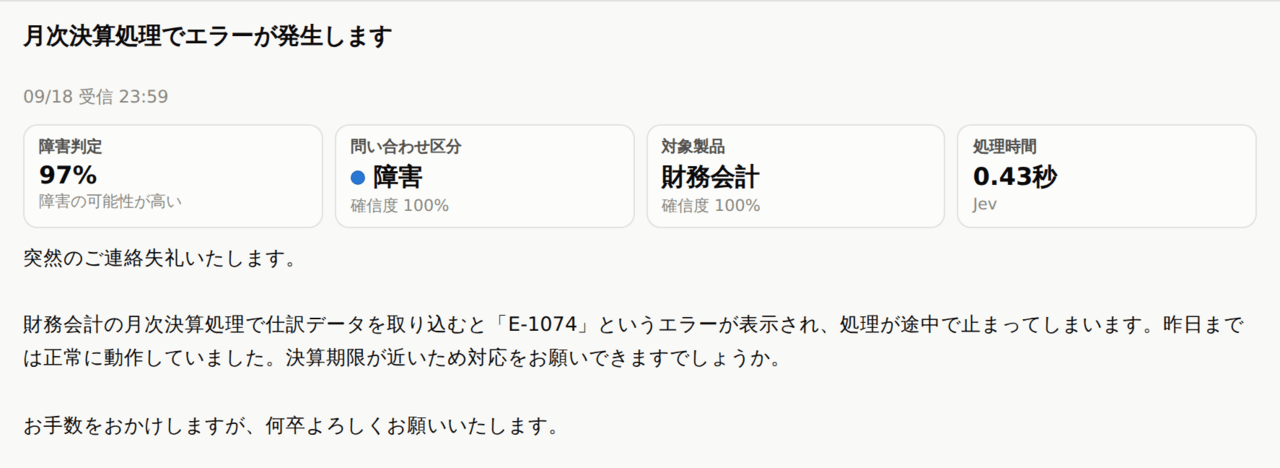
この確信度が実用上かなり効きます。今回の100件のうち、区分と製品のどちらかの確信度が0.9を下回ったのは13件でした。裏を返せば、残りの87件は機械的に振り分けてよく、人間が見るべきは13件に絞れる、ということです。「全件AIに任せるか、全件人間が見るか」ではなく、確信度を使ってその境界を引けます。
Jev vs LLM:同じ100件をSonnet 4.6でも判定する
比較相手は Amazon Bedrock 経由の Claude Sonnet 4.6(東京リージョン)です。フェアに比べるため、区分と製品の選択肢はJevとまったく同じ定義を共有し、LLM側は Converse API の tool use で出力スキーマを固定しました(toolChoiceでツール呼び出しを強制し、選択肢はenumで縛る)。つまりLLM側も、やろうと思えばできる範囲で一番きれいな「構造化出力」の形にしてあります。
とはいえ、そのために必要だったものがこれです。
- 役割と判定基準を書き下したシステムプロンプト(約700文字)
classify_inquiryというツールのJSON Schema定義- 確信度を「自己申告」させるための
inquiry_type_confidence/product_confidenceフィールド - レスポンスから
toolUseブロックを探して取り出す処理
Jev側がquestionsを書くだけだったのに対して、LLM側は「AIに正しく振る舞ってもらうための足場」をこれだけ組む必要がありました。ここは実装コストとして無視できない差です。
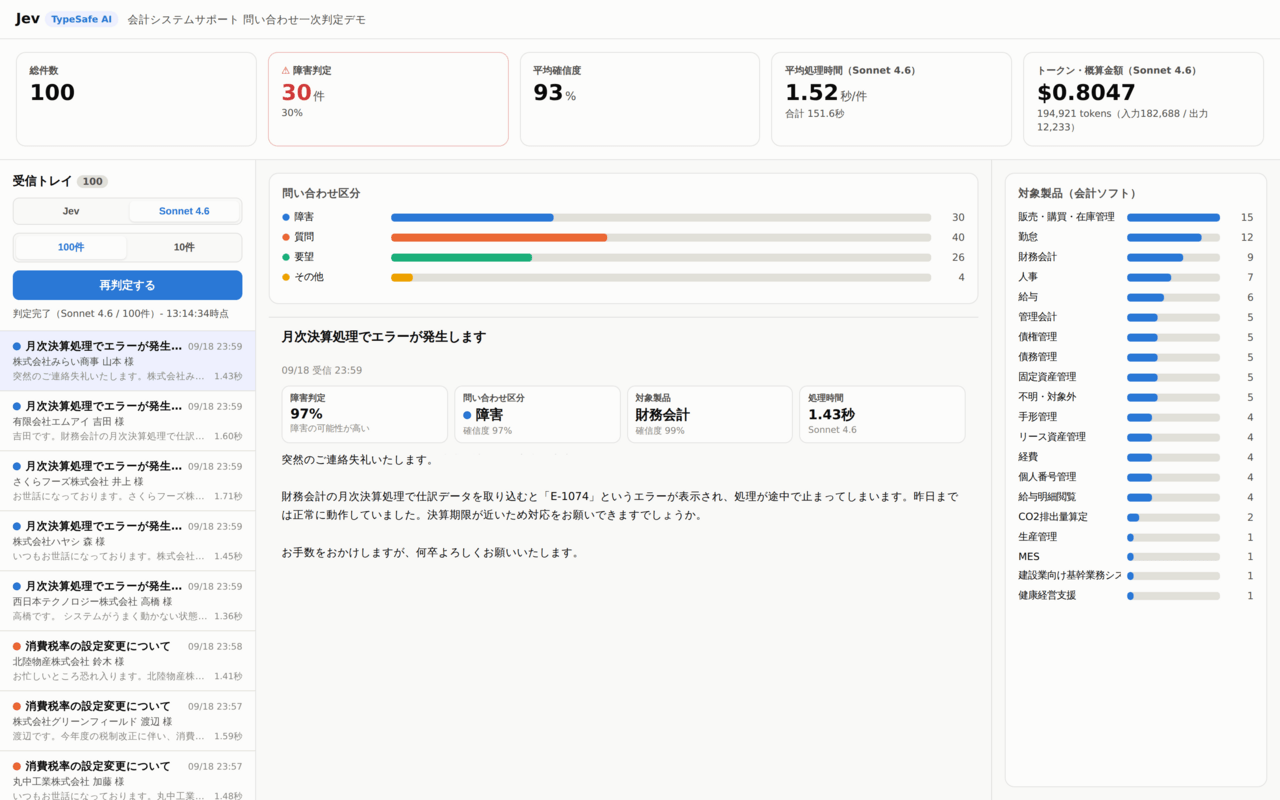
結果
| 項目 | Jev(jev-1.13.0) | Claude Sonnet 4.6(Bedrock) | 差 |
|---|---|---|---|
| 1件あたり平均処理時間 | 0.23秒 | 1.52秒 | 約6.5倍 |
| 100件の単純合計時間 | 約23.3秒 | 約151.6秒 | 約6.5倍 |
| 100件の実測所要時間 | 約4秒(並列6) | 約39秒(並列4) | 約10倍 |
| 入力トークン | 127.5K | 182.7K | — |
| 出力トークン | 30.9K | 12.2K | — |
| 100件の概算コスト | $0.0054(約0.9円) | $0.8047(約129円) | 約149倍 |
| 平均確信度 | 98% | 93% | — |
コストの単価は、Jevが入力100万トークンあたり$0.042(出力は無料)、Sonnet 4.6がBedrock東京リージョンで入力$3.30 / 出力$16.50です。1ドル160円で換算すると、100件の一次判定にかかるのはJevが約0.9円、Sonnet 4.6が約129円。月1万件なら約86円と約1.3万円の差になります。
肝心の「判定結果は合っているのか」
速くて安くても、答えが違っていては意味がありません。2つのエンジンの判定を1件ずつ突き合わせました。
| 判定項目 | 一致件数 |
|---|---|
| 障害かどうか(0.5を閾値) | 100 / 100 |
| 問い合わせ区分 | 100 / 100 |
| 対象製品(20区分) | 99 / 100 |
区分と障害判定は全件一致、20択の製品判定でも食い違ったのは1件だけでした。
比較にあたっての前提
- サンプル100件は生成した架空データで、正解ラベルはありません。したがって上の表は「両者の一致率」であって「正解率」ではありません。
- 並列数はJevが6並列、Sonnet 4.6が4並列です。
- いずれも同一VMからの実行で、ネットワーク条件は揃えています。
まとめ:LLMは「精緻な仕事」に取っておく
今回の結果を見て思ったのは、「LLMを使わない選択肢」ではなく「LLMをどこに使うかの選択肢」が増えたということです。
問い合わせ対応というひとつの業務の中にも、性質の違う仕事が混ざっています。
- 障害か質問か、どの製品か、急ぎか — 選択肢が決まっていて、速さと安さと安定性が効く仕事。ここはJevのような判定専用モデルの領域です。100件を4秒・1円弱でさばけて、確信度まで付いてきます。
- お客様への回答文を書く、過去事例を踏まえて原因を推定する、ナレッジ記事にまとめる — 文脈を読んで言葉を選ぶ、精緻な仕事。ここは間違いなくLLMの領域で、Jevには最初からできません。
現実的な構成は、たぶん両方を直列に並べる形になります。入口でJevが全件を高速に仕分けし、確信度が低いものだけ人間かLLMに回す。振り分けが済んだ案件について、LLMがじっくり回答を作る。 こうすると、LLMを呼ぶ回数そのものが減るので、コストも応答時間も効きます。
「とりあえず全部LLMに投げる」は、動くものを素早く作るには良い出発点です。ただ、件数が増えてきたときや、レスポンス速度が業務の質に直結する場面では、その処理が本当に文章生成を必要としているのかを一度分けて考えてみる価値はありそうです。少なくとも今回の一次判定については、答えは明確に「必要としていなかった」でした。
手元で試すのも簡単です。APIは1エンドポイント、リクエストも3項目だけなので、いま動いているLLMの分類処理を1つ選んで、questionsに書き換えて投げてみるだけで、この記事と同じ比較ができます。ぜひやってみてください。