こんにちは。SCSKの島村です。
本記事ではGoogle DeepMindの拡散モデルベースのLLM「DiffusionGemma-as-Jev(djev)」について検証・整理したいと思います。
DiffusionGemma-as-Jev(djev)は、Google DeepMindの拡散モデルベースのLLM「DiffusionGemma」をベースにして、本家Jevと同じ仕組み(型付きの判断と確率を返すAPI契約)で動くように作られたオープンソースです。
AIを実際のバックエンドシステムやRPAに組み込もうとしたとき、誰もが一度は次のような絶望感を味わったことがあるはずです。
- 「数秒待たされた挙句、出力されたJSONのスキーマが崩れてパースエラーを起こした」
- 「間違った回答なのに、まるで事実であるかのように自信満々に嘘(ハルシネーション)をつかれた」
- 「複雑な分岐ロジックを組みたいのに、確率の数値を信用してプログラムの閾値に組み込めない」
こうしたシステム連携における「AIの不確実性」と「構造的破綻」という根本的な課題に正面から挑み、業界にパラダイムシフトを起こしているのが、元OpenAIの研究者らが創業したTypeSafe AIが開発した「Jev (System One)」です。
本記事では、いまテック界隈で大きな話題を集めている「文章を書かないAI」の内部メカニズム、RLCDによる確率較正の秘密、API仕様、そして気になる料金体系やセルフホスト構築の全貌を私なりに整理してみました。
本家Jev(TypeSafe AI Jev)について
本検証のスタンス:なぜいま「Jev」を触るのか
本稿や筆者の検証環境におけるアプローチとして、現時点では TypeSafe社が提供する公式APIの利用を前提 としています。
また、関連するオープンソースモデル(例えば DiffusionGemma や各種オープンな判断モデルなど)やモデル自体は、エコシステム全体を見渡してもまだ発展途上であり、実務適用の面では未成熟な部分も多い可能性があります。
しかし、そうした過渡期にあえてその動向を注視し、実際に手を動かして検証・試行しているのは、「文章を書かないAI」というパラダイムシフトの先進的な動きや、システムアーキテクチャ上の可能性をいち早く確認するために他なりません。過度な楽観視をせず、今後の技術進化を見極めるための第一歩として、本検証の意義としてみていただければと思います。
1. 従来型AIの限界:なぜシステム連携で破綻するのか?
現代のシステム開発において、AIの活用はもはや不可欠ですが、アプローチによってそれぞれ深刻なジレンマを抱えています。
① 大規模言語モデル (LLM / 例: GPT-4等)
- スキーマ違反: 自由なテキスト生成に特化しているため、JSON出力が途中で崩れてシステム停止を誘発する。
- レイテンシ遅延: 自己回帰生成(1トークンずつ文字を紡ぐ仕組み)のため、応答に数秒〜数十秒を要する。
- 過信の傾向: ハルシネーションを堂々と出力する特性があり、信頼度が不透明。
② 従来型NLP (例: BERT等)
- 適応力の限界: ゼロショット性能(事前学習のみで未経験のタスクをこなす能力)が低く、動的な文脈に弱い。
- 大量の学習データ: タスクごとに膨大なラベル付けや微調整が必要となり、コストがかさむ。
- 汎用性の欠如: 複雑なマルチタスク判断への拡張が困難。
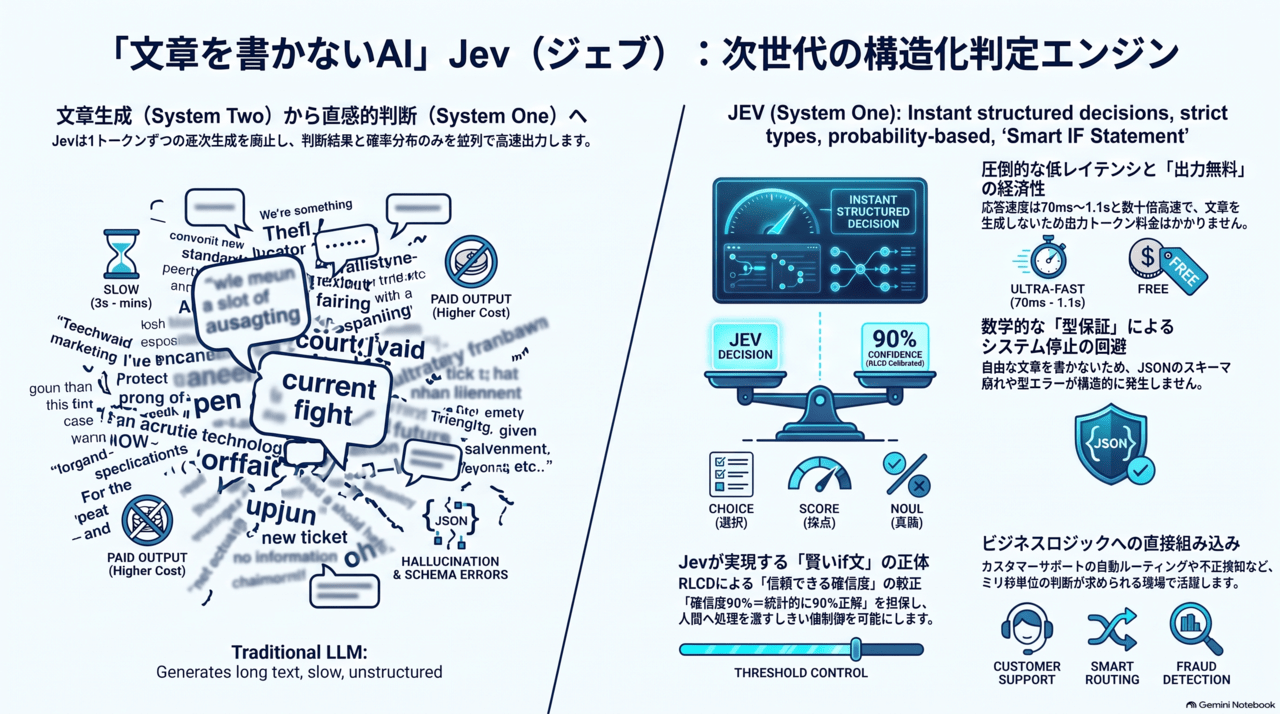
こうした背景から、「LLMの圧倒的な汎用性(賢さ)」と「従来型分類器の高速性・確実性」のいいとこ取りをした次世代のアーキテクチャとして登場したのが、Jev (System One) です。
2. Jev (System One) の設計思想:文章を書かないAI
Jevの核心は、心理学者ダニエル・カーネマンの提唱する「システム1(速く直感的な思考)」に由来しています。その設計思想は極めてシンプルかつラジカルです。
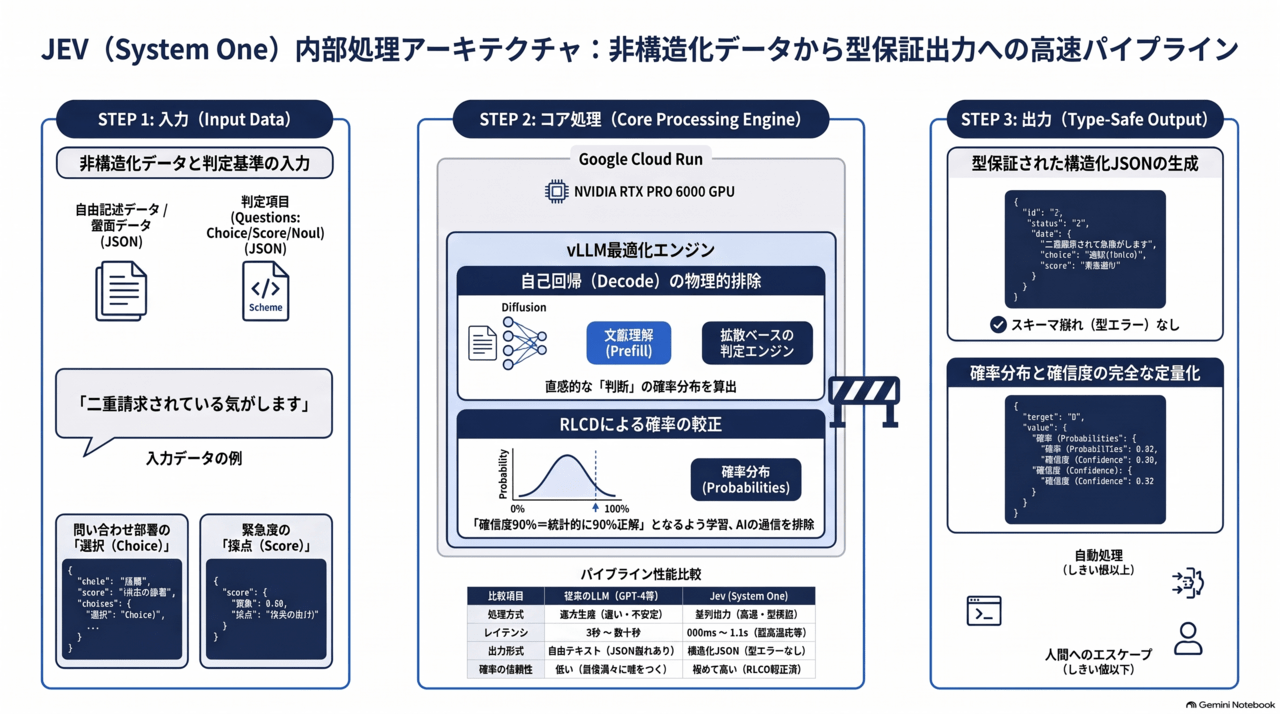
- 生成プロセスの完全排除: 自然言語テキストを1文字ずつ自己回帰で生成するプロセスを一切廃し、選択肢やスコアに対する確率分布の算出のみに特化。
- 数学的な型保証 (Type-Safe): フォーマット崩れが構造的に発生しないため、RPAやバックエンドシステムの条件分岐、APIへ直接安全に組み込み可能。
- 不確実性の完全な定量化: 全選択肢に対する確率を算出し、AIの迷いや確信度(Confidence)を数値として把握。自動処理と人間の判定を完全に切り分けることができます。
3. 主要モデル比較マトリクス
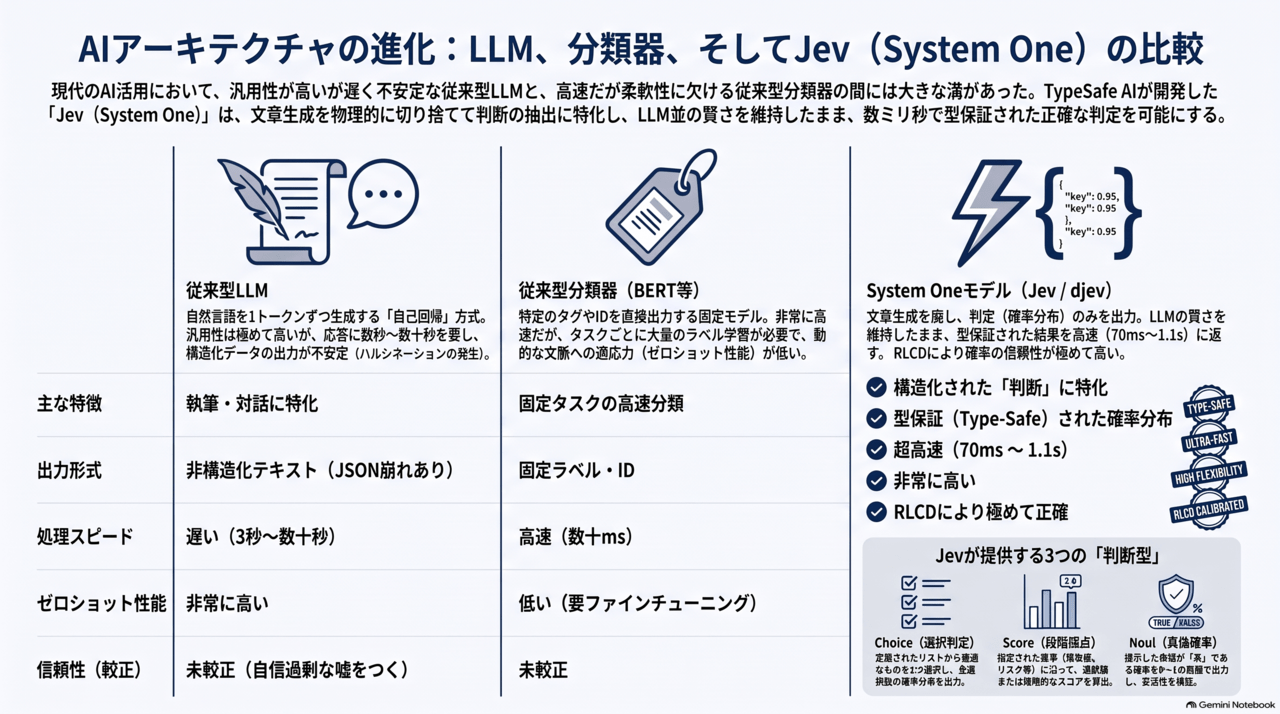
それぞれのモデルがどのような特徴を持つのか、比較表で整理します。
4. Jevを構成する3つの評価プリミティブ
Jevは、文章を作成する代わりに、以下の3つの「プリミティブ(基本要素)」を組み合わせてあらゆる判定を瞬時に実行します。
- Choice(選択判定): 定義された複数の選択肢リストの中から、入力文脈に最も合致するものを1つ選択し、全選択肢の確率分布を出力。
- Score(段階採点): 指定された評価尺度・基準に沿って、連続値または離散値としてのスコアを算出。意味を表する凡例(legend)を付与。
- Noul(真偽確率): 提示した記述や命題が真である確率を0〜1の数値で正確に算出。事実確認や主張の妥当性検証を完全に自動化。
5. なぜ確率が信頼できるのか?(RLCDの仕組み)
従来のLLMが持つ最大の欠点は、RLHF(人間からのフィードバックによる強化学習)の影響によって「間違った回答であっても自信満々に嘘をつく(未較正)」という性質でした。そのため、「確率90%」と言われても、プログラムの閾値として信用して使うことができませんでした。
Jevは、RLCD(較正された判断のための強化学習:Reinforcement Learning for Calibrated Decisions)という独自手法を採用しています。これにより、出力された確率値(例: 90%)が、実際の正解率と完全に一致するように厳密に最適化されています。
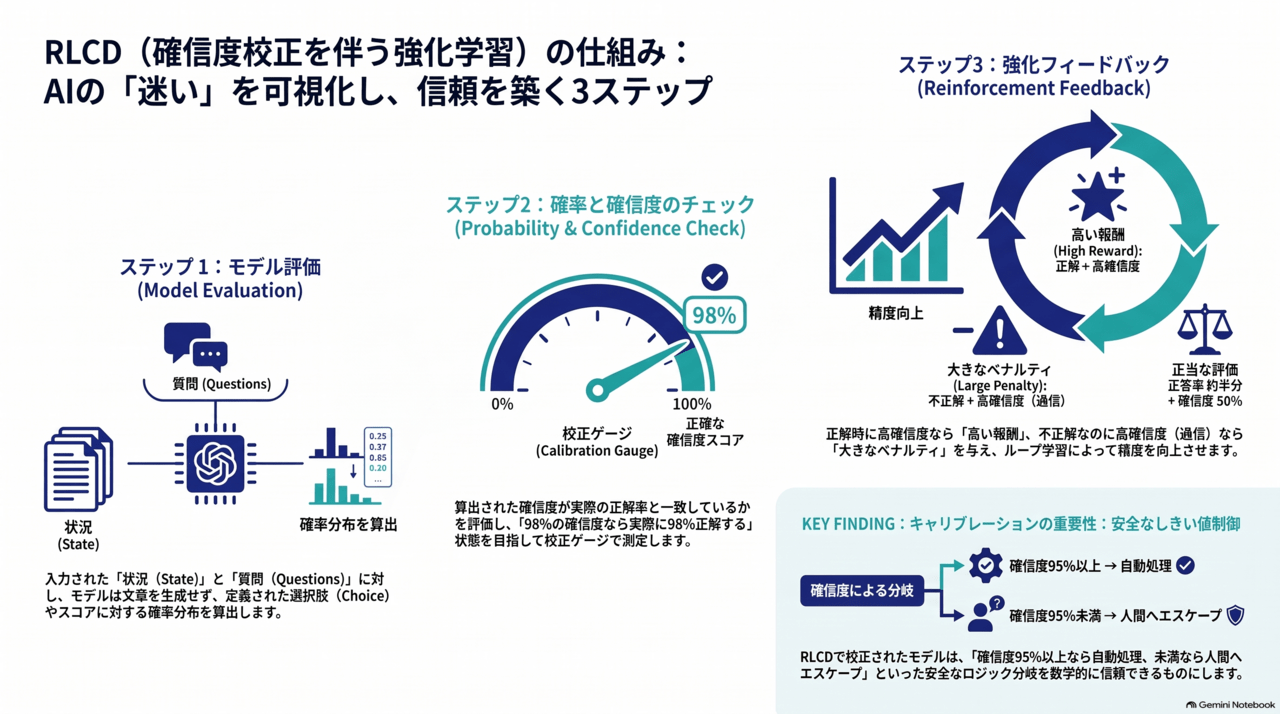
この結果、エンジニアは以下のような安全な自動化しきい値制御をコードに実装できるようになります。
確率の較正(RLCD)と、それがなぜ重要なのか
Jevがシステム開発において革命的なのは、「確率が較正されている(Calibrated)」という点です。これは天気予報の「降水確率90%」の日に実際に約90%の確率で雨が降るのと同じで、Jevが「確信度90%」と出力した場合、統計的に「90%の確率で本当に正しい」ことを意味します。
従来のLLMはRLHF(人間からのフィードバックによる強化学習)の影響で、間違っていても「自信満々に嘘をつく」傾向がありました。JevはRLCD(較正された判断のための強化学習:Reinforcement Learning for Calibrated Decisions)という独自手法で最適化されており、自分自身の不確実性を正確に把握しています。
これにより、エンジニアは「確信度95%以上なら自動実行、それ未満なら人間のレビューに回す(Human-in-the-loop)」といった安全なif文(閾値)をコード上で明確に設定できるようになります。
アーキテクチャの核心:Decodeの切り捨てというパラダイムシフト
TypeSafe AIから技術論文は公開されていませんが、Jevの挙動からアーキテクチャの核心を推察することができます。
Jevの最大の発明は「新しいTransformerをゼロから作った」ことではなく、「既存のLLMの推論プロセスから、文章生成(Decode)フェーズを完全に切り捨てた」点にあると考えられます。
従来のLLMは、入力文章を理解する段階(Prefill)の後、答えを1単語ずつ予測して書き出す段階(Decode)に入ります。Jevはこの高度な文脈理解能力(Prefill)を持つLLMのアーキテクチャをベースとしつつ、自己回帰による文章生成を無効化し、分類タスクに特化させるような特殊な学習(完全な合成データとRLCDなどを用いた、ある種の極端なファインチューニングに近いアプローチ)を行ったと推測されます。
この「生成させない」という割り切りにより、LLMの持つゼロショットの推論能力(賢さ)を維持したまま、推論時間を数十倍高速化し、かつプロンプトエンジニアリングをいくら頑張ってもゼロにならなかった「AIがJSONの型を破るリスク」を数学的に消滅させることに成功しています。
6. TypeSafe AIのAPI料金と利用体系に関する詳細
Jevのビジネス的なインパクトや運用コストを語る上で欠かせないのが、その独特な料金体系と圧倒的なコストパフォーマンスです。
料金モデルの構造
入力トークン料金:
Jev (例: `jev-1.13`) の標準的なAPI料金は、入力100万トークンあたり $0.042 と極めて安価に設定されています(10億トークンあたり約42ドル)。
出力トークン料金(無料):
驚くべきことに、出力トークンは「無料 ($0.00 / 1M tokens)」 です。これは比喩ではなく、Jev自体が「文章を1文字ずつ自己回帰で生成する仕組み」をそもそも持たず、確率分布と選択されたキーのみを返すため、課金対象となる生成フェーズのデータ量が発生しない構造になっているためです。
既存LLMとの比較によるコストパフォーマンス
従来のフロンティアLLM(一般的なテキスト生成モデル)と比較すると、入力あたりのコストは数分の一から場合によっては数百分の一という高い経済性を誇ります。リアルタイムのゲームループや、毎秒数千件に及ぶログのトリアージ、大量のドキュメントの自動分類など、従来のLLM APIをそのまま使うとコストが破綻してしまうユースケースであっても、Jevであれば現実的な予算内で運用を回すことが可能です。
7. API仕様:リクエストと確率分布レスポンス
実際のAPIがどのようにやり取りを行うのか、具体的なペイロードの例を見てみましょう。
【リクエスト例】
{
  "state": {
    "message": "二重請求されている気がします。領収書を再発行してください。"
  },
  "questions": {
    "department": {
      "type": "choice",
      "criteria": {
        "billing": "請求・返金に関する内容",
        "support": "不具合に関する内容"
      }
    }
  }
}
【レスポンス例 (確率分布)】
{
  "answers": {
    "department": {
      "choice": "billing",
      "probabilities": {
        "billing": 0.9879,
        "support": 0.0121
      },
      "confidence": 0.9879
    }
  }
}
このように、最も確率の高い選択肢だけでなく、すべての選択肢に対する確率分布と確信度が返されるため、システムの自動判定において極めて高い信頼性を担保できます。
8. 実際のビジネスユースケース
JEVの特性を活かすことで、これまでのLLMではコストや安全性の面で難しかった領域を一気に自動化できます。
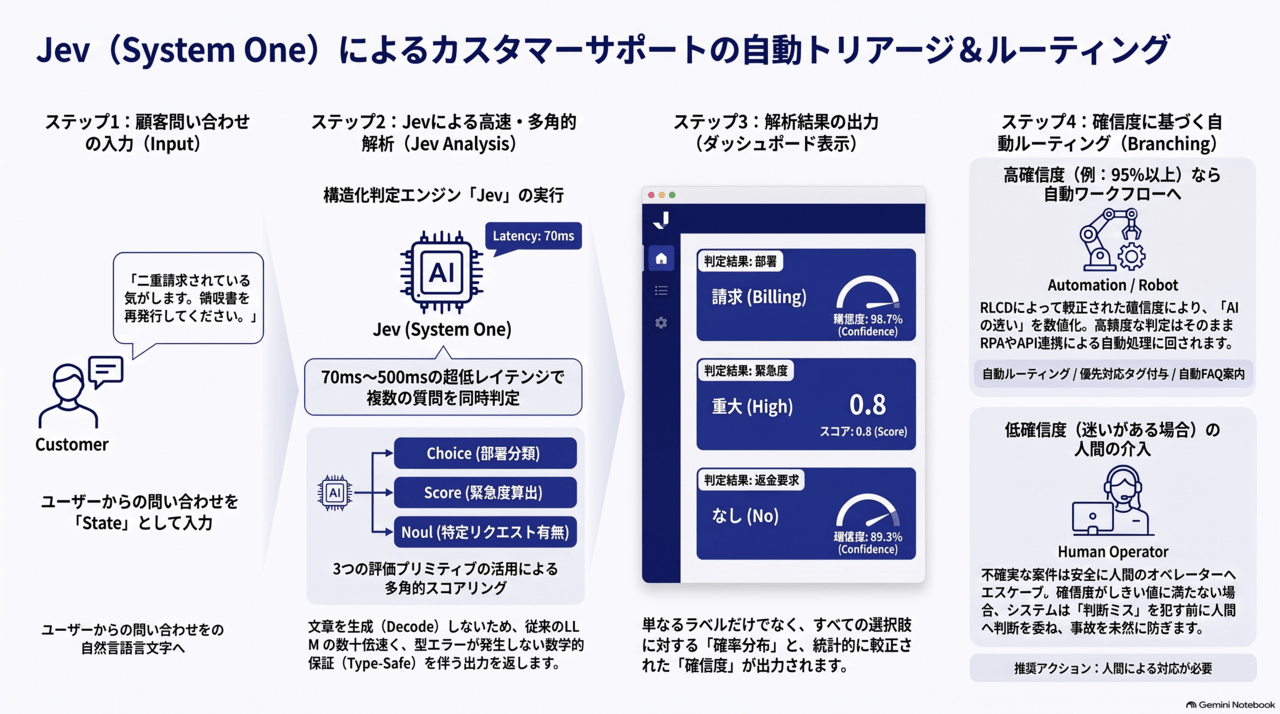
- カスタマーサポートの自動トリアージ&ルーティング:
問い合わせ内容に対し、部署・緊急度・返金要求をミリ秒単位で同時判定。確信度の低い案件のみを人間のオペレーターへエスケープ。 - 金融・ECの不正検知とリスクスコアリング:
ユーザー行動や注文情報を入力し、根拠となる確率分布付きの信頼性の高いスコアを算出。 - 複雑な社内ワークフローの自動承認分岐:
規定の条文と申請内容を照らし合わせ、型保証された正確な選択肢で自動判定を効率化。
9. 現行モデルの限界と注意点
万能に見えるJevですが、公式が公開している通り、実運用にあたってはいくつかの注意点(Jaggedness)が存在します。
- 計算・カウントの不向き: 電卓ではないため、数学的計算や厳密な数え上げには誤差が生じます。計算ロジックはコード側で実装すべきです。
- コンテキストの劣化:無関係な情報を `state` に詰め込みすぎると精度が下がります。LLMのような「とりあえず全情報を渡す」アプローチではなく、事前の情報絞り込みが必須です。
- 敵対的入力への対策: 入力データを既定で敵対的とみなさないため、プロンプトインジェクションによる判定ブレの検証が必要です。
DiffusionGemma-as-Jev をGoogle Cloudで試す
本章では、Google Cloud上の Vertex AI Workbench および Cloud Run (GPU環境) を用いて、オープンソースの構造化判定モデルである Jev (System One / DiffusionGemma-26B) のセルフホスト環境を構築し、型保証された推論APIを検証してみました。
DiffusionGemma-as-Jevとは?
DiffusionGemma-as-Jev(通称 djev や OpenJev と呼ばれるオープンソースの仕組み)は、Google DeepMindが開発した拡散型LLM「DiffusionGemma」を、TypeSafe AIが提唱する「Jev(System Oneモデル)」と互換性のある型付き判断APIとして動かすための自己ホスト型サーバー(ラッパー)です。
一言で言えば、
OSSエコシステム:DiffusionGemma-as-Jev (djev)
Jevの登場を受け、OSSコミュニティではオープンモデルでJevの挙動を模倣・拡張する動き(通称: OpenJev)が急拡大しています。
代表格である djev(DiffusionGemmaベース)には以下の特徴があります。
- 完全なAPI互換: 本家Jevのコード(Choice/Score等)を変更せずにセルフホスト可能。
- マルチモーダル対応(本家超え)**: 本家Jevがテキストのみ対応であるのに対し、djevはGemmaの画像認識能力を引き継いでいるため、「画像(領収書や請求書)を入力して直接型付き分類・採点を行う」ことが可能です。
レスポンス仕様の各項目に関する詳細解説
1. 全体構造 (`model`, `answers`, `usage`)
- `model`: 使用された推論モデル名(例: `”dgemma”`)が返されます。
- `answers`: リクエストで定義した質問キー(`department`, `severity` など)ごとの判定結果が格納されるオブジェクトです。
- `usage`: トークン消費量(`input_tokens` と `output_tokens`)を返し、APIコストや負荷の計測に利用できます。
2. choice型(選択肢判定)の構造 (`department`, `requestsRefund`)
- `type`: `”choice”` が返され、選択式で判定されたことを示します。
- `choice`: モデルが選んだ最も確率の高い選択肢のキー(例: `”billing”`, `”no”`)です。この値をそのままアプリケーションの条件分岐に利用できます。
- `probabilities`: 定義したすべての選択肢に対する確率の分布(合計が約 1.0)です。これにより、「単にどれが選ばれたか」だけでなく「他の選択肢との差がどれくらいあるか(モデルの迷いの度合い)」を定量的に把握できます。
- `confidence`: 選択された結果の確率そのもの(確率分布の最大値)であり、判定の信頼度(確信度)として扱えます。
3. score型(段階・深刻度判定)の構造 (`severity`)
- `type`: `”score”` が返されます。
- `score`: 連続値または離散値として算出されたスコア(例: `0.7998`)です。単なる整数ではなく細かなグラデーション(確率的期待値)として表現されます。
- `legend`: リクエスト時に渡した配列のインデックス(`”0″`, `”1″`, `”2″`)と、対応するラベル文字列のマッピング(辞書)です。スコアがどの意味に属するかを自動で紐づけます。
- `probabilities`: 各スコア段階(0, 1, 2)に割り当てられた確率分布です。例えば上記の例では、「軽微 (0)」が約24.3%、一番確率の高い「回避策あり (1)」が約71.3%のように、判定の傾向を詳細に読み取ることができます。
- `confidence`: 最も確率が高かったスコア段階における確率の高さが、信頼度として格納されます。
Cloud Runにデプロイしてみる
実際にCloud RunにDiffusionGemma-as-Jevを展開してみました。コードも併せて共有します。
1. 環境変数の設定
export PROJECT_ID=$(gcloud config get-value project)
export REGION="us-central1"
export BUCKET="djev-model-bucket-${PROJECT_ID}"

2. GCSバケットの作成
gcloud storage buckets create "gs://${BUCKET}" --location="${REGION}"

3. モデル重みのダウンロードとGCSへのアップロード
pip install -q -U "huggingface_hub[cli]"
hf download nvidia/diffusiongemma-26B-A4B-it-NVFP4 --local-dir /tmp/dgemma
gcloud storage cp -r /tmp/dgemma/* "gs://${BUCKET}/dgemma/"
rm -rf /tmp/dgemma

4. Cloud Runへのデプロイ(最適化設定の適用)
gcloud beta run deploy djev-dgemma \\
--region="${REGION}" \\
--image=ghcr.io/taeold/djev-run:latest \\
--gpu=1 \\
--gpu-type=nvidia-rtx-pro-6000 \\
--no-gpu-zonal-redundancy \\
--cpu=20 \\
--memory=80Gi \\
--no-cpu-throttling \\
--concurrency=32 \\
--min-instances=0 \\
--max-instances=1 \\
--port=8080 \\
--network=default \\
--subnet=default \\
--vpc-egress=all-traffic \\
--add-volume="name=weights,type=cloud-storage,bucket=${BUCKET},readonly=false,mount-options=enable-buffered-read=true" \\
--add-volume-mount="volume=weights,mount-path=/mnt/gcs" \\
--startup-probe="httpGet.path=/health,httpGet.port=8080,initialDelaySeconds=5,periodSeconds=2,timeoutSeconds=2,failureThreshold=120" \\
--set-env-vars="MODEL=/mnt/gcs/dgemma,CANVAS=128,MAX_SEQS=32,MAX_MODEL_LEN=4096,GPU_UTIL=0.40,KV_CACHE_GB=2,ATTN=TRITON_ATTN,TEST_PAGE=1,COPY_TO_SHM=1,ENFORCE_EAGER=1,DISABLE_MM=1,TORCH_COMPILE_DISABLE=1,VLLM_WORKER_MULTIPROC_METHOD=fork,VLLM_UF_EAGER_ALL=1,VLLM_FLASHINFER_MOE_BACKEND=masked_gemm,CUDA_MODULE_LOADING=LAZY"
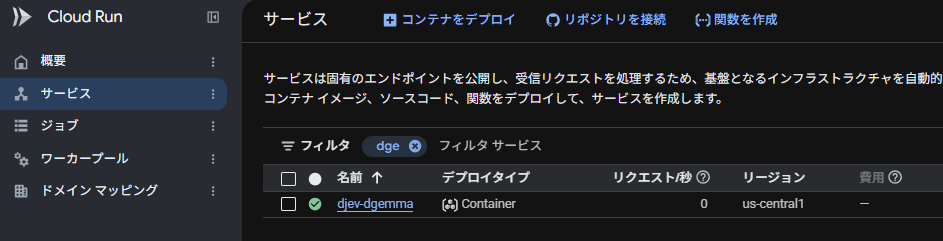
問題なくデプロイが完了するとCloud Run上にも表示されます。
動作確認:リクエストしてみる
実際に作成したCloud Runに対して、リクエストを投げてみます。結果は以下です。
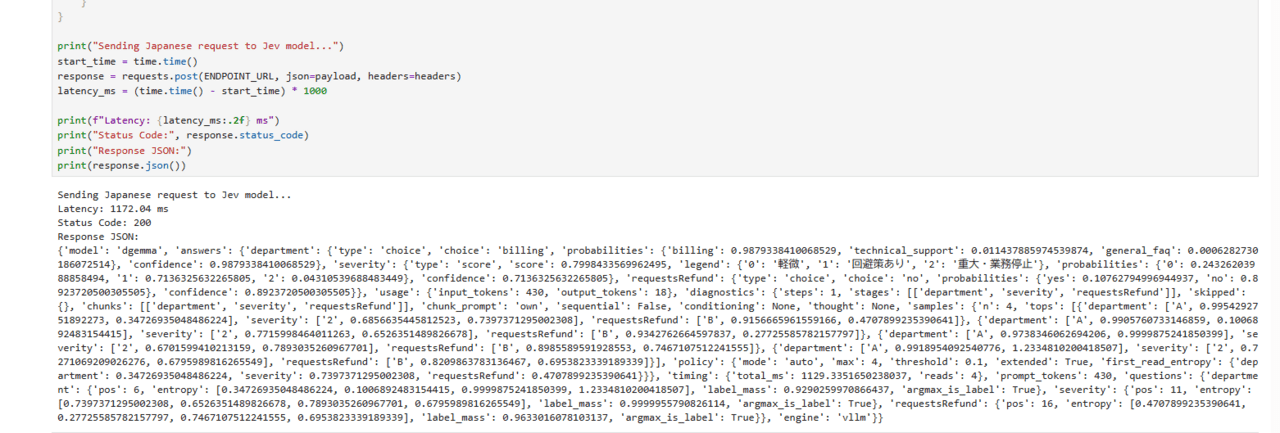
もう少しレスポンスを見やすくしてみました。
==================================================
 📤 [入力] 送信ペイロード・質問内容
==================================================
【 顧客メッセージ 】
  "昨日の注文の領収書をPDFで再発行してほしいです。二重に請求されている気がします。"

【 設定した質問・選択肢一覧 】
・ 質問キー: [department] (タイプ: choice)
  指示文: どの部署がこの問い合わせに対応すべきですか?
  基準/選択肢:
    - billing: 請求、支払い、返金、領収書に関する内容
    - technical_support: システムの不具合や操作方法に関する内容
    - general_faq: 一般的な質問や会社情報

・ 質問キー: [severity] (タイプ: score)
  指示文: 問題の緊急度・深刻度はどの程度ですか?
  基準/選択肢:
    - スコア [0]: 軽微
    - スコア [1]: 回避策あり
    - スコア [2]: 重大・業務停止

・ 質問キー: [requestsRefund] (タイプ: choice)
  指示文: 顧客はお金の返金を求めていますか?
  基準/選択肢:
    - yes: 返金を求めている
    - no: 求めていない

==================================================
 🔄 サーバーへリクエスト送信中...
==================================================

==================================================
 📥 [出力] モデルの判定結果
==================================================
Latency  : 603.13 ms
Status   : 200
Model    : dgemma
--------------------------------------------------
【 質問ごとの判定結果・確率分布 】

■ 質問: [department]
  指示: どの部署がこの問い合わせに対応すべきですか?
  ➔ 判定結果: 【 billing 】 (確信度: 98.60%)
    確率分布:
      - billing           :  98.60% ███████████████████
      - technical_support :   1.33%
      - general_faq       :   0.07%

■ 質問: [severity]
  指示: 問題の緊急度・深刻度はどの程度ですか?
  ➔ 判定結果: 【 スコア 0.798 = 回避策あり 】 (確信度: 70.43%)
    確率分布:
      - スコア 0 (軽微):  24.87% ████
      - スコア 1 (回避策あり):  70.43% ██████████████
      - スコア 2 (重大・業務停止):   4.70%

■ 質問: [requestsRefund]
  指示: 顧客はお金の返金を求めていますか?
  ➔ 判定結果: 【 no 】 (確信度: 89.09%)
    確率分布:
      - yes               :  10.91% ██
      - no                :  89.09% █████████████████

--------------------------------------------------
使用トークン数: 入力 430 / 出力 18
==================================================
いかがだったでしょうか?Google Cloudの環境でも「Jev」を試してみることができました!!
まとめ
本記事ではTypeSafe社のJev並びにGoogleが提供しているオープンソースとしてDiffusionGemma-as-Jevについて整理・検証してみました。
Jev (System One) は、AIに「文章を書かせる」というこれまでの常識を覆し、「正確な確率に基づく構造化された判断」だけをシステムに提供するという、新しいパラダイムを提示しました。
現時点ではTypeSafe社のAPIを利用しつつ、発展途上の部分も含めてその実力を検証している段階ではありますが、LLMの持つ圧倒的なゼロショットの知性を保ちながら、システムが求める「型保証」と「圧倒的なコストパフォーマンス(出力無料)」を手に入れたこのアプローチは、今後のAIエージェントや業務システムの自動化において、なくてはならないインフラになっていくに違いありません。
ぜひ、お手元のシステムやAPI検証環境でも、この「文章を書かないAI」の圧倒的なスピードと確実性を体験してみてください。