こんにちは、関根です。
Snowflakeで複数の顧客のデータを預かるとき、「顧客ごとにテーブルを分けるべきか、1つのテーブルにまとめるべきか」という話になりがちです。ただ、Snowflakeで取れる選択肢はこの二択に収まりません。WHERE customer_id = ? だけのものから、通常View、Secure View、Row Access Policy、顧客別のTable / Schema / Database / Account、さらに外部に提供するためのSecure Data Sharingまであります。
この記事では、それぞれの方式を機能の一覧として並べるのではなく、「セキュリティ境界をどこに置いているか」という観点で、実際に手を動かしながら比べてみます。
顧客分離は「テーブルを分けるか」という問題ではなく、
どこにセキュリティ境界を置くかというアーキテクチャ設計である。
3つの境界で考える
先に、この記事で使う言葉を整理しておきます。「顧客データを分離する」と言うとき、実際には次の3つの境界を分けて考える必要があります。
| 境界 | 問い | 主な手段 |
|---|---|---|
| 保存境界 | データを物理的・論理的にどこに置くか | 共有Table / 顧客別Table・Schema・Database・Account |
| アクセス境界 | 誰がどの行を見られるか | WHERE / View / Row Access Policy |
| 提供境界 | 何を、どの形で、どこまで内部を見せて渡すか | Secure View / Secure Data Sharing |
そのうえで、各方式を次の軸で評価します。
| 評価軸 | 内容 |
|---|---|
| 分離強度 | 論理分離〜物理分離のどのあたりか |
| 誤操作耐性 | WHERE句の書き忘れなどに耐えられるか |
| 定義秘匿性 | SQLや基底構造をどこまで隠せるか |
| 外部共有 | Data Sharingとの相性 |
| Edition | 必要なEdition |
検証環境
検証には次のSnowflakeアカウントを使いました。
| 項目 | 内容 |
|---|---|
| Edition | Enterprise Edition |
| クラウド | AWS |
| リージョン | 東京(ap-northeast-1) |
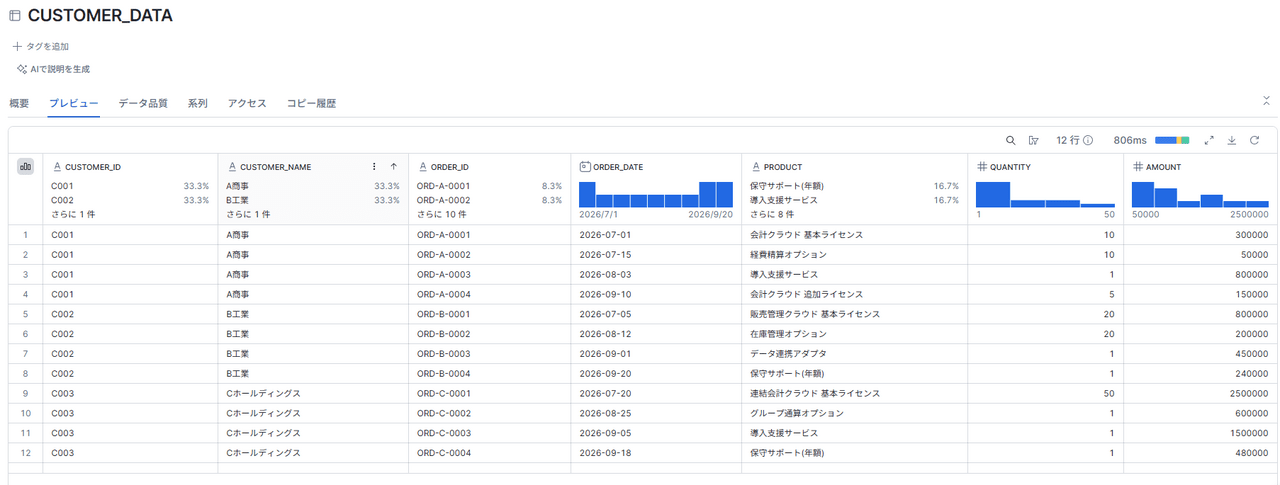
データは、架空の3顧客(C001〜C003)の受注データを4件ずつ、合計12件入れた共有テーブルを使います。
CREATE OR REPLACE TABLE customer_data (
  customer_id    VARCHAR(10)   NOT NULL,
  customer_name  VARCHAR(50)   NOT NULL,
  order_id       VARCHAR(20)   NOT NULL,
  order_date     DATE          NOT NULL,
  product        VARCHAR(50)   NOT NULL,
  quantity       NUMBER(5,0)   NOT NULL,
  amount         NUMBER(12,0)  NOT NULL
);

INSERT INTO customer_data VALUES
  ('C001', 'A商事', 'ORD-A-0001', '2026-07-01', '会計クラウド 基本ライセンス', 10, 300000),
  -- …(C001〜C003 各4件、計12件)
  ('C003', 'Cホールディングス', 'ORD-C-0004', '2026-09-18', '保守サポート(年額)', 1, 480000);
投入後のテーブルをSnowsightでプレビューすると、次のように3顧客分・12件のデータが入っていることを確認できます。
ロールは、顧客の利用者を想定した customer_a_role / customer_b_role / customer_c_role の3つを用意しました。
1. テーブル+WHERE句
SELECT *
FROM customer_data
WHERE customer_id = 'C001';最もシンプルな方式で、この記事ではほかの方式と比べるときの基準にします。論点は1つだけで、SQLを書く人が正しくWHERE句を書くことが前提になっているという点です。
WHERE句を付け忘れれば、当然ながら全顧客分のデータが返ってきます。つまりこの方式では、セキュリティ境界はSnowflakeの中ではなく、SQLを書く人やアプリケーションのコードの側にあります。
2. テーブル+通常View
CREATE VIEW customer_a_view AS
SELECT *
FROM customer_data
WHERE customer_id = 'C001';

-- Viewだけを参照できるロールを作り、基底テーブルへの直接SELECTは付与しない
GRANT SELECT ON VIEW customer_a_view TO ROLE customer_a_role;利用者からWHERE句を隠し、「この入口からしか見られない」状態を作れます。その代わり、顧客の数だけSnowflakeのViewオブジェクトが増えていくというトレードオフがあります。
たとえば顧客が3社なら、次のように顧客ごとにViewを1つずつ作ることになります。
customer_a_view
customer_b_view
customer_c_view顧客が100社になればViewも100個になり、顧客を追加・削除するたびにViewの作成・削除と権限付与の作業が発生します。
3. テーブル+Secure View
CREATE SECURE VIEW customer_a_secure_view AS
SELECT *
FROM customer_data
WHERE customer_id = 'C001';
ここで確かめたいのは、返ってくるデータの違いではありません。同じSELECT結果を返す通常ViewとSecure Viewを作って、View定義や内部構造がどう見えるかを比べます。
比較は、Viewを作ったロール(SYSADMIN)ではなく、SELECT権限だけを持つ利用者ロール customer_a_role の目線で行います。
USE SECONDARY ROLES NONE;   -- 所有ロール(SYSADMIN)の権限が効かないようにする
USE ROLE customer_a_role;
SHOW VIEWS LIKE 'CUSTOMER_A%' IN SCHEMA mt_demo_db.shared;
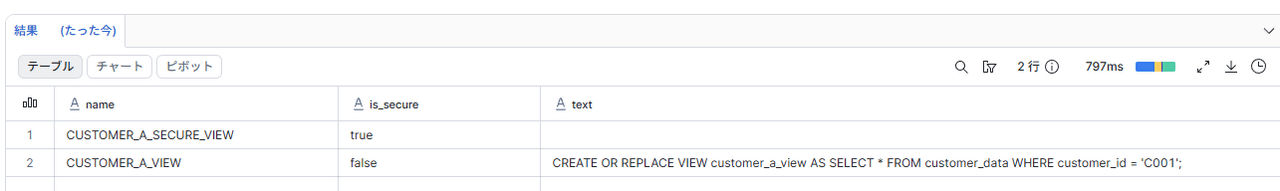
通常Viewは text 列にCREATE文がそのまま出ていますが、Secure Viewは空欄になりました。同じデータを返すViewでも、利用者から見える情報はこれだけ違います。
次に GET_DDL でDDLを取り出してみます。
SELECT GET_DDL('VIEW', 'mt_demo_db.shared.customer_a_view');
SELECT GET_DDL('VIEW', 'mt_demo_db.shared.customer_a_secure_view');
通常Viewは、列名まで補完されたCREATE文が返ってきます。

一方Secure Viewは、エラーになりました。
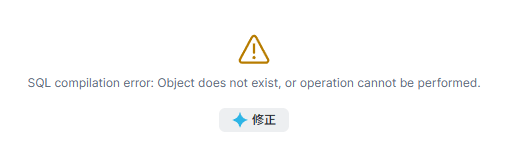
注目したいのはエラーの文言で、「権限がない」ではなく「オブジェクトが存在しないか、操作を実行できない」と返ってきます。SELECTはできるViewなのに、定義を取り出そうとすると存在すら曖昧にされる、という挙動です。
最後に、両方のViewをSELECTしてSnowsightのクエリプロファイルを比べます。結果キャッシュが効くとプロファイルが出ないので、先にセッションで切っておきます。
ALTER SESSION SET USE_CACHED_RESULT = FALSE;

SELECT * FROM customer_a_view;
SELECT * FROM customer_a_secure_view;
通常Viewのプロファイルです。
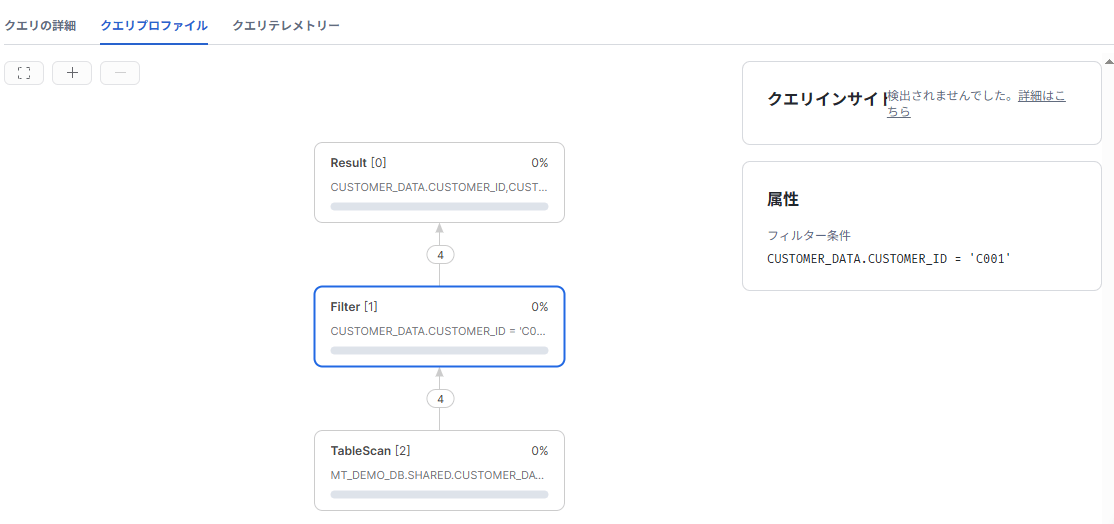
TableScan に基底テーブル名 MT_DEMO_DB.SHARED.CUSTOMER_DATA が、Filter の属性には CUSTOMER_DATA.CUSTOMER_ID = 'C001' という絞り込み条件がそのまま出ています。定義を直接見られなくても、プロファイルから「どのテーブルを、どんな条件で読んでいるか」が分かってしまいます。
次にSecure Viewのプロファイルです。
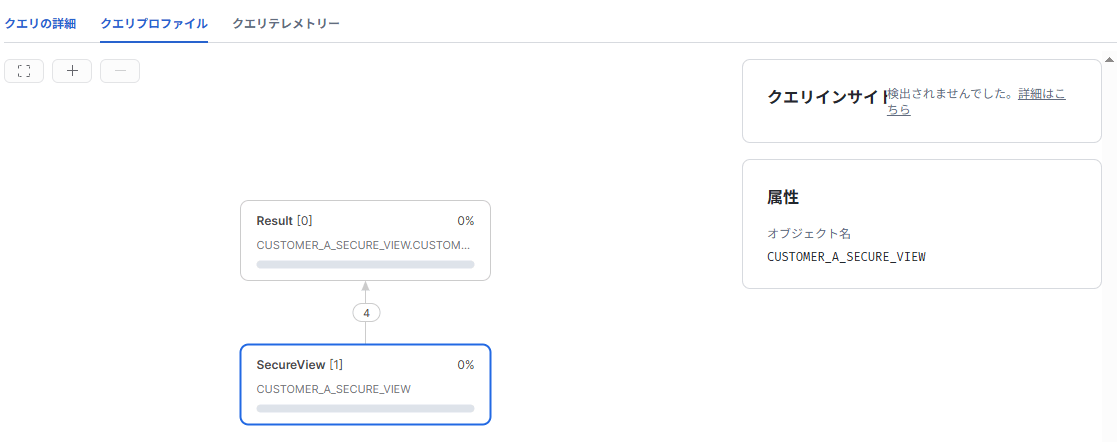
ノードは SecureView の1つにまとめられ、属性に出るのはオブジェクト名 CUSTOMER_A_SECURE_VIEW だけです。基底テーブル名も絞り込み条件も見えません。
| 確認方法 | 通常View | Secure View |
|---|---|---|
| SHOW VIEWS(text列) | CREATE文が見える | 空欄(見えない) |
| GET_DDL | CREATE文が返る | エラー(Object does not exist) |
| クエリプロファイル | 基底テーブル名・絞り込み条件が見える | SecureViewノードのみ(内部は見えない) |
Secure Viewは「顧客ごとに行を分けるための機能」そのものではありません。Viewの中身や基底オブジェクトの情報を外の利用者から隠し、安全にデータを渡す境界を作るための機能と整理できます。
通常View    = SQLの入口を固定する
Secure View = SQLの入口を固定しつつ、内部実装も隠す
4. テーブル+Row Access Policy
Row Access Policy(以下RAP)は、テーブルに行単位のアクセス制御を付ける機能です。条件を満たさない行は、SQLにWHERE句を書かなくても結果から除外されます。
※ RAPはEnterprise Edition以上の機能です。
-- 顧客とロールの対応表
CREATE TABLE tenant_role_mapping (
  role_name    VARCHAR(100) NOT NULL,
  customer_id  VARCHAR(10)  NOT NULL
);

-- どのロールがどの顧客の行を見られるかを登録
--   ロール名は CURRENT_ROLE() の戻り値に合わせて大文字で入れる
INSERT INTO tenant_role_mapping (role_name, customer_id) VALUES
  ('CUSTOMER_A_ROLE', 'C001'),
  ('CUSTOMER_B_ROLE', 'C002'),
  ('CUSTOMER_C_ROLE', 'C003');

-- 行アクセスポリシーの定義
--   評価する行の customer_id が引数 cid に渡され、
--   今のロールにその顧客が割り当てられていれば TRUE(その行が見える)
CREATE ROW ACCESS POLICY customer_rap
AS (cid VARCHAR) RETURNS BOOLEAN ->
  EXISTS (
    SELECT 1 FROM tenant_role_mapping m
    WHERE m.customer_id = cid
      AND m.role_name   = CURRENT_ROLE()
  );

-- テーブルにポリシーを付与
--   customer_id 列の値をポリシーの引数 cid に渡して、行ごとに判定させる
ALTER TABLE customer_data
ADD ROW ACCESS POLICY customer_rap ON (customer_id);検証の中心は、次のSQLをWHERE句を付けずに、ロールだけ切り替えて実行することです。
SELECT *
FROM customer_data;
まず customer_a_role で実行します。
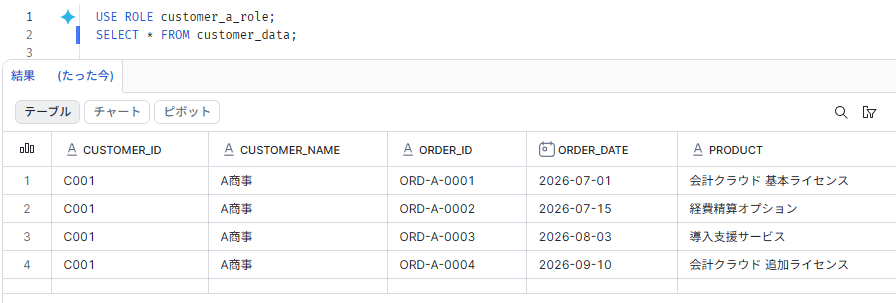
WHERE句を書いていないのに、返ってくるのはC001(A商事)の4件だけです。次に、ロールだけを customer_b_role に切り替えて、まったく同じSQLを実行します。
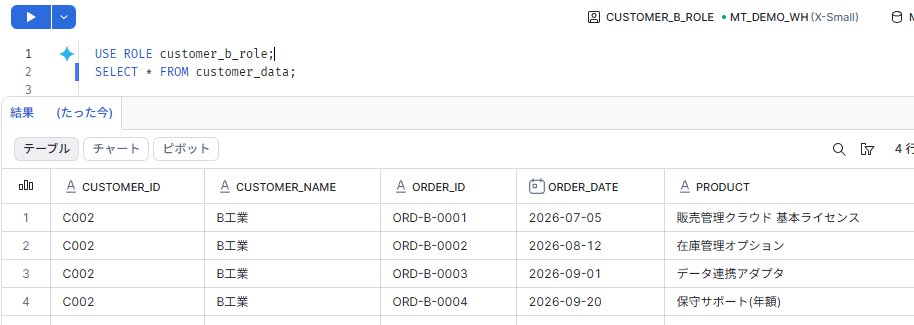
今度はC002(B工業)の4件だけが返ってきました。どちらもViewではなくテーブルを直接SELECTしている点がポイントです。検証のため、各ロールにはテーブルへのSELECT権限をあえて付与していますが、それでも他の顧客の行は見えません。
ちなみに、テーブルの所有者であるSYSADMINで実行すると、結果は0件でした。マッピングにSYSADMINの行が無いためで、所有者であってもポリシーの対象になることが分かります。
USE ROLE SYSADMIN;
SELECT COUNT(*) FROM customer_data;   -- 0
RAPがやっていることを普通のSQLで書くと、次のようになります。
SELECT c.*
FROM mt_demo_db.shared.customer_data c
WHERE EXISTS (
  SELECT 1
  FROM mt_demo_db.shared.tenant_role_mapping m
  WHERE m.customer_id = c.customer_id
    AND m.role_name   = CURRENT_ROLE()
);
本来はこのクエリを毎回書かなければいけないところが、RAPを付けておけば SELECT * FROM customer_data; の1行で済みます。
RAPの本質は便利さではありません。セキュリティ制御を、アプリケーションや利用者の注意力に頼る状態からSnowflake側に移せるところにあります。
5. Secure View+Row Access Policy
customer_data にRAPを付け、さらにその上にSecure Viewを作ることで、見せる行はRAPで絞り込みつつ、クエリの中身はSecure Viewで利用者からは完全に隠すことができます。
View側にはWHERE句を書きません。行の絞り込みはRAPに任せ、View側は見せる列を決めるだけです。
CREATE OR REPLACE SECURE VIEW customer_secure_view AS
SELECT customer_id, customer_name, order_id, order_date, product, quantity, amount
FROM customer_data;
customer_a_role でこのViewを参照します。
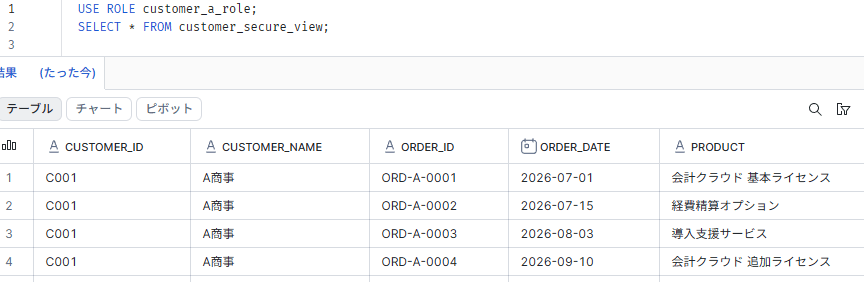
View側に条件を書いていなくても、返ってくるのはC001の4件だけです。テーブルに付いたRAPが、View経由のアクセスにもそのまま効いています。
同じロールで SHOW VIEWS を実行すると、Viewの定義は隠れたままです。
行の制御はRAP、定義の秘匿はSecure Viewと、それぞれが自分の役割を果たしたまま、1つのViewの中で両立しています。
6. 顧客別Table / Schema / Database
ここからは物理的にオブジェクトを分ける方式です。挙動としては想像どおりなので、実機検証はせず、運用面の違いを机上で整理します。
6-1. 顧客別Table
CUSTOMER_A_DATA
CUSTOMER_B_DATA
CUSTOMER_C_DATA分離ははっきりしますが、Schema DriftやDDLの横展開にかかるコストが増えます。
列を1つ追加するだけでも、顧客の数だけALTERが必要です。1社でも漏れると、その顧客だけテーブル定義がずれていきます。
ALTER TABLE customer_a_data ADD COLUMN discount NUMBER;
ALTER TABLE customer_b_data ADD COLUMN discount NUMBER;
ALTER TABLE customer_c_data ADD COLUMN discount NUMBER;
-- …顧客の数だけ続く
全顧客を横断して集計したいときも、テーブルを並べてUNION ALLする必要があり、顧客を追加するたびにこのSQLも直すことになります。
SELECT * FROM customer_a_data
UNION ALL SELECT * FROM customer_b_data
UNION ALL SELECT * FROM customer_c_data;
6-2. 顧客別Schema
CUSTOMER_A.DATA
CUSTOMER_B.DATA
SnowflakeのRBACと相性が良く、テーブル単位よりも管理しやすくなります。Future Grantsを使えば、後からスキーマ内に作ったテーブルにも自動で権限が付きます。
GRANT USAGE ON SCHEMA customer_a TO ROLE customer_a_role;
GRANT SELECT ON FUTURE TABLES IN SCHEMA customer_a TO ROLE customer_a_role;
新しい顧客は、ひな型のスキーマをゼロコピークローンすれば、テーブル一式をまとめて立ち上げられます。
CREATE SCHEMA customer_d CLONE customer_template;ただし、スキーマ内のテーブル定義を変えるときに顧客の数だけALTERが必要になる点は、顧客別Tableと変わりません。
6-3. 顧客別Database
CUSTOMER_A_DB
CUSTOMER_B_DB
論理的にはかなり強い分離になります。Clone、Time Travelのデータ保持期間(DATA_RETENTION_TIME_IN_DAYS)、Data Sharingの単位を、顧客ごとに独立して設定できるのが利点です。
CREATE DATABASE customer_d_db CLONE customer_template_db;
ALTER DATABASE customer_a_db SET DATA_RETENTION_TIME_IN_DAYS = 30;一方で、共通処理・DDL変更・横断分析はさらに複雑になります。横断集計は、Databaseをまたいだクエリになります。
SELECT * FROM customer_a_db.public.data
UNION ALL SELECT * FROM customer_b_db.public.data;
7. 顧客別Snowflake Account
実際の検証はせず、設計上の比較にとどめます。最も強い分離ですが、運用の負荷も最も高くなります。
| 観点 | 内容 |
|---|---|
| セキュリティ / 障害 / 管理 / 課金の境界 | すべてアカウント単位で独立する |
| リージョン / クラウド / ネットワーク | 顧客ごとに選べる |
| ID管理 / 運用コスト | アカウントの数だけ増える |
8. Data Sharingで外部に提供する
8-1. Secure View+Secure Data Sharing
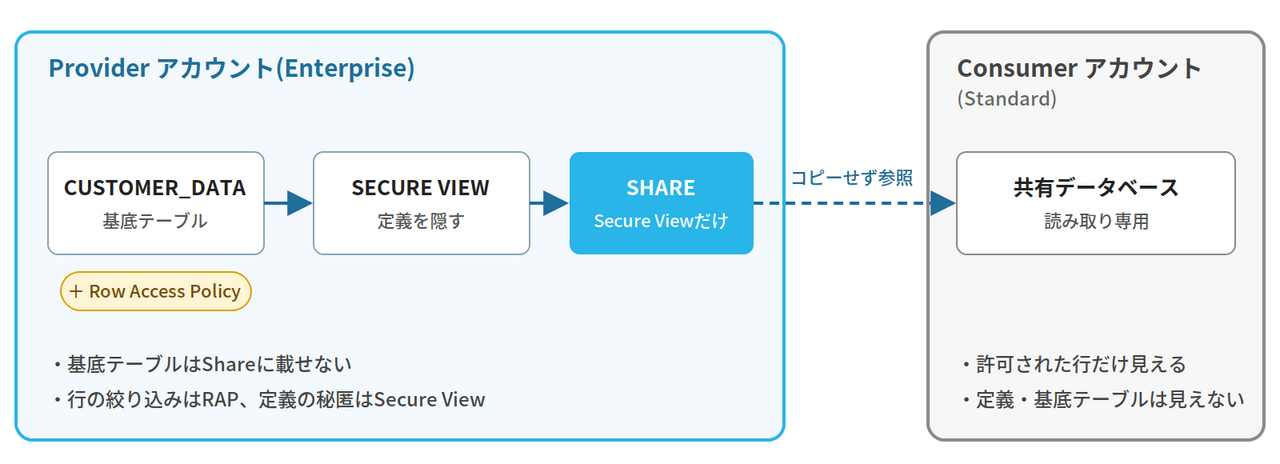
Providerはデータを共有するが、データを作るロジックや内部構造までは共有しない。
Provider側では、Shareを作ってSecure Viewを載せ、共有先のアカウントを追加します。載せるのは5章で作った customer_secure_view(WHERE句なし・行の絞り込みはRAP任せ)です。
-- Shareを作成
CREATE OR REPLACE SHARE mt_customer_share;

-- Shareに載せるオブジェクトを指定(DB → スキーマ → View の順に権限を付与)
GRANT USAGE  ON DATABASE mt_demo_db                             TO SHARE mt_customer_share;
GRANT USAGE  ON SCHEMA   mt_demo_db.shared                      TO SHARE mt_customer_share;
GRANT SELECT ON VIEW     mt_demo_db.shared.customer_secure_view TO SHARE mt_customer_share;

-- 共有先のアカウントを追加(組織名.アカウント名)
ALTER SHARE mt_customer_share ADD ACCOUNTS = <Consumerの組織名>.<Consumerのアカウント名>;
基底テーブルの customer_data はShareに載せていない点がポイントです。Consumerに渡るのはSecure Viewだけです。
まず、通常ViewをShareに載せようとするとどうなるかを確認します。
GRANT SELECT ON VIEW mt_demo_db.shared.customer_a_view TO SHARE mt_customer_share;▼ 実行結果(エラー)
エラーになりました。Shareは既定で SECURE_OBJECTS_ONLY = TRUE になっていて、通常ViewのようなセキュアでないViewは、そのままでは載せられません。Shareの作成時に SECURE_OBJECTS_ONLY = FALSE を指定すれば通常Viewも共有できますが、一度FALSEにすると元には戻せません。Snowflakeもドキュメントで、共有にはSecure Viewを使うことを強く推奨しています。
8-2. Row Access Policy+Secure View+Data Sharing
社内で使う場合と外部に共有する場合とでは、「誰を識別しているか」が変わります。
| 識別する単位 | 使う関数の例 | |
|---|---|---|
| 社内利用 | ロール | CURRENT_ROLE() |
| 外部共有 | アカウント | CURRENT_ACCOUNT() |
8-1で共有した customer_secure_view を、Consumer側から参照してみます。Consumer側では、共有されたデータベースがそのまま見えているので、直接SELECTします。
SELECT * FROM <共有されたデータベース>.SHARED.CUSTOMER_SECURE_VIEW;
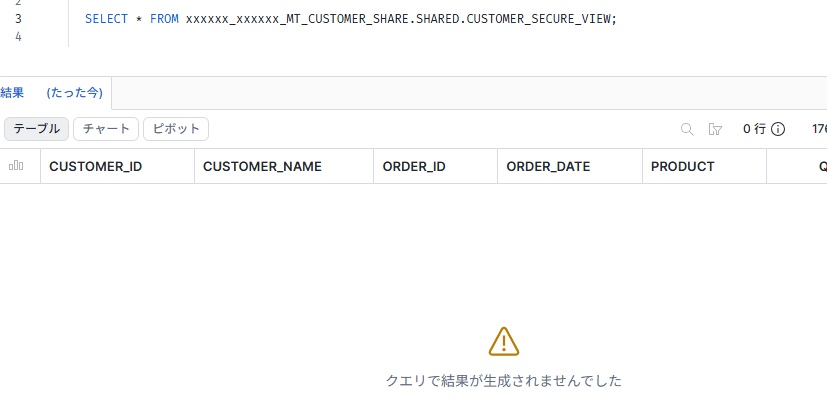
エラーにはならず、列も見えていますが、結果は0件でした。Viewは届いているのに、中身が1行も返ってきません。
原因はRAPの判定条件です。4章で作ったポリシーは CURRENT_ROLE() とマッピングを照合していました。ところが、Consumer側で使っているのはConsumerアカウントのロールで、Providerのマッピングには登録されていません。社内向けに「ロール」で書いたポリシーは、外部の相手を識別できないわけです。
そこで、マッピングにConsumerのアカウントロケーター(CURRENT_ACCOUNT() の戻り値)を登録し、ポリシーを「ロールまたはアカウント」で判定するように変更します。
-- Consumerのアカウントロケーターを、C001の閲覧者として登録
INSERT INTO tenant_role_mapping (role_name, customer_id) VALUES
  ('<Consumerのアカウントロケーター>', 'C001');

-- ポリシー本体だけを差し替える(テーブルから外す必要はない)
ALTER ROW ACCESS POLICY customer_rap SET BODY ->
  EXISTS (
    SELECT 1
    FROM mt_demo_db.shared.tenant_role_mapping m
    WHERE m.customer_id = cid
      AND m.role_name IN (
            CURRENT_ROLE(),     -- 社内:ロールで判定
            CURRENT_ACCOUNT()   -- 外部共有:アカウントで判定
          )
  );
Consumer側で、同じSELECTをもう一度実行します。
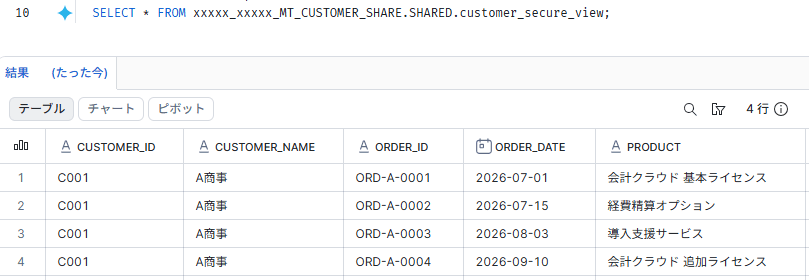
今度はC001の4件だけが返ってきました。Consumer側では何も変えていません。Provider側でマッピングに1行足し、ポリシーの判定条件を広げただけです。
Consumer側から SHOW VIEWS を実行しても、定義は見えません。
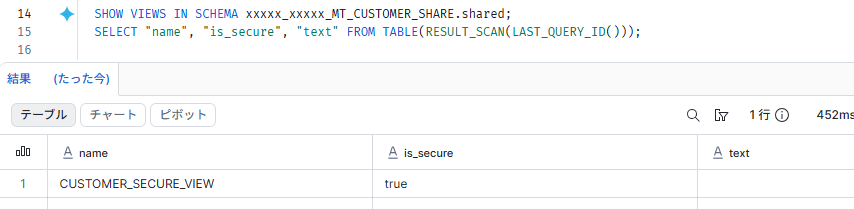
Consumerに届くのは、RAPで絞り込まれた行と、定義が隠されたSecure Viewだけです。社内では「ロール」で、外部では「アカウント」で相手を識別しながら、同じテーブル・同じポリシー・同じSecure Viewで両方に対応できています。
比較まとめ
ここまで見てきたように、顧客データの分離は「テーブルを分けるか、まとめるか」という二択ではありません。
重要なのは、どこにセキュリティ境界を置くかです。
今回確認した方式を整理すると、それぞれが担当している境界は次のように異なります。
- WHERE句 / 通常View:SQLやViewを入口として利用者側で制御する
- Row Access Policy:行単位のアクセス制御をSnowflake側に固定する
- Secure View:View定義や基底オブジェクトを利用者から隠し、提供する境界を作る
- 顧客別Table / Schema / Database:保存するオブジェクトそのものを分ける
- 顧客別Account:セキュリティ、障害、管理、課金まで含めてアカウント単位で分ける
- Secure Data Sharing:Snowflakeアカウント間で、Provider側の内部構造を直接公開せずにデータを提供する
つまり、これらは単純な「強い・弱い」の関係ではなく、
保存境界、アクセス境界、提供境界のどこを分離したいかによって選ぶものです。
基本形として考えやすい構成
物理的に顧客データを分離しなければならない理由がない場合は、
共有テーブルにデータを保持し、Row Access Policyで行のアクセス境界を作る構成が扱いやすくなります。
これに加えて、利用者へView定義や基底テーブルの情報を見せたくない場合は、
Secure Viewを重ねて提供境界を作ることができます。
今回の検証では、この構成をそのままSecure Data Sharingまで拡張できました。
Row Access Policyは「誰がどの行を見られるか」を制御し、Secure Viewは「内部をどこまで見せるか」を制御する。
両者は似たセキュリティ機能に見えますが、担当している境界は異なります。
物理分離を選ぶ理由
一方、顧客別Table / Schema / Database / Accountは、顧客ごとに保存先そのものを分ける方式です。
分離は明確になりますが、顧客が増えるほどDDL変更や権限管理、横断分析などの運用コストも増えていきます。
そのため、単に「顧客ごとに分けた方が安全そうだから」という理由だけで物理分離を選ぶのではなく、
どこまで独立させる必要があるのかを先に決めた方が設計しやすくなります。
- Table / Schema:顧客ごとにオブジェクトや権限管理を分けたい
- Database:Clone、Time Travelの保持期間、Data Sharingなども顧客単位で独立させたい
- Account:リージョン、クラウド、ID管理、障害、管理、課金まで独立させたい
方式を選ぶときの考え方
設計時には、「どの方式が最も強いか」ではなく、次の順番で考えると整理しやすくなります。
- 保存境界:同じTable / Schema / Databaseに置いてよいか
- アクセス境界:誰がどの行を見られるべきか
- 提供境界:内部構造をどこまで隠して渡す必要があるか
- 外部共有:Snowflake外部アカウントへ提供する必要があるか
今回の検証から、特に物理分離の要件がなければ、
共有Table+Row Access Policyをアクセス制御の基本とし、必要に応じてSecure Viewを重ねる
という構成は、運用とセキュリティのバランスを取りやすい選択肢だと考えられます。
逆に、契約や運用上の理由からデータ保持、障害、リージョン、管理単位まで分ける必要がある場合は、
DatabaseやAccountへ境界を広げていくことになります。
総評
| 章 | 方式 | 分離強度 | 誤操作耐性 | 定義秘匿性 | 運用 | 外部共有 | Edition |
|---|---|---|---|---|---|---|---|
| 1 | テーブル+WHERE句 | × | × | × | ○ | × | Std |
| 2 | テーブル+通常View | △ | △ | × | × | × | Std |
| 3 | テーブル+Secure View | △ | △ | ○ | × | ○ | Std |
| 4 | テーブル+Row Access Policy | △ | ○ | × | ○ | △ | Ent |
| 5 | Secure View+Row Access Policy | △ | ○ | ○ | ○ | ○ | Ent |
| 6 | 顧客別Table / Schema / Database | ○ | ○ | △ | × | ○ | Std |
| 7 | 顧客別Account | ○ | ○ | △ | × | ○ | Std |
※「運用」は評価軸には含めていない参考項目です。顧客の追加・変更・削除やDDLの横展開のしやすさを表しています。
顧客データ分離で最初に決めるべきなのは、「テーブルを分けるか」ではありません。
どの境界をSnowflakeに持たせ、どの境界をアプリケーションや運用側に残すのかです。
その境界が決まれば、WHERE句、View、Secure View、Row Access Policy、Database、Accountといった個々の機能は、
目的に応じて選ぶ手段として整理できるようになります。