はじめに
お疲れ様です。SCSKの大原です。
以前、CloudWatch Agentを使用してプロセスを監視していると、気になる事象が発生しました。
CloudWatch Agent自身を停止した場合、通常の監視対象プロセスを停止した場合よりも、CloudWatch アラームがALARM状態になるまでに時間がかかったことです。
この違いは、アラームの判定方法によるものではないかと考えました。
そこで今回は、停止対象や監視メトリクス、アラームの評価条件を変えながら、検知時間と判定理由を比較しました。
CloudWatch Agentによるプロセス監視
CloudWatch Agentのprocstatプラグインでは、指定したプロセスのメトリクスを収集できます。
例えば、procstat_lookup_pid_countは、指定した条件に一致するプロセスの個数を表すメトリクスです。
このメトリクスに対して、想定するプロセス数より下回った場合にALARMとなるよう設定することで、プロセスの停止を監視できます。
CloudWatch Agentプロセスが停止した場合は、その他、メトリクスの収集・送信も停止します。
今回は、通常のプロセス停止とCloudWatch Agentの停止で、アラームの検知時間や判定理由に違いがあるのかを確認しました。
参考:AWS公式:procstatプラグインによるプロセスメトリクスの収集
検証内容
検証環境
検証用EC2インスタンスにCloudWatch Agentを導入し、監視対象となるプロセスを2種類用意しました。
| 項目 | 設定 |
|---|---|
| OS | RHEL 9.6 |
| CloudWatch Agent | 1.300073.2b1889 |
| メトリクス収集間隔 | 60秒 |
| アラームPeriod | 60秒 |
| 欠落データの扱い | breaching |
| 測定回数 | 各条件4回 |
監視対象には、以下のプロセスを使用しました。
プロセスA:sleepで動作するプロセス
プロセスB:Pythonで動作するプロセス
検証方法
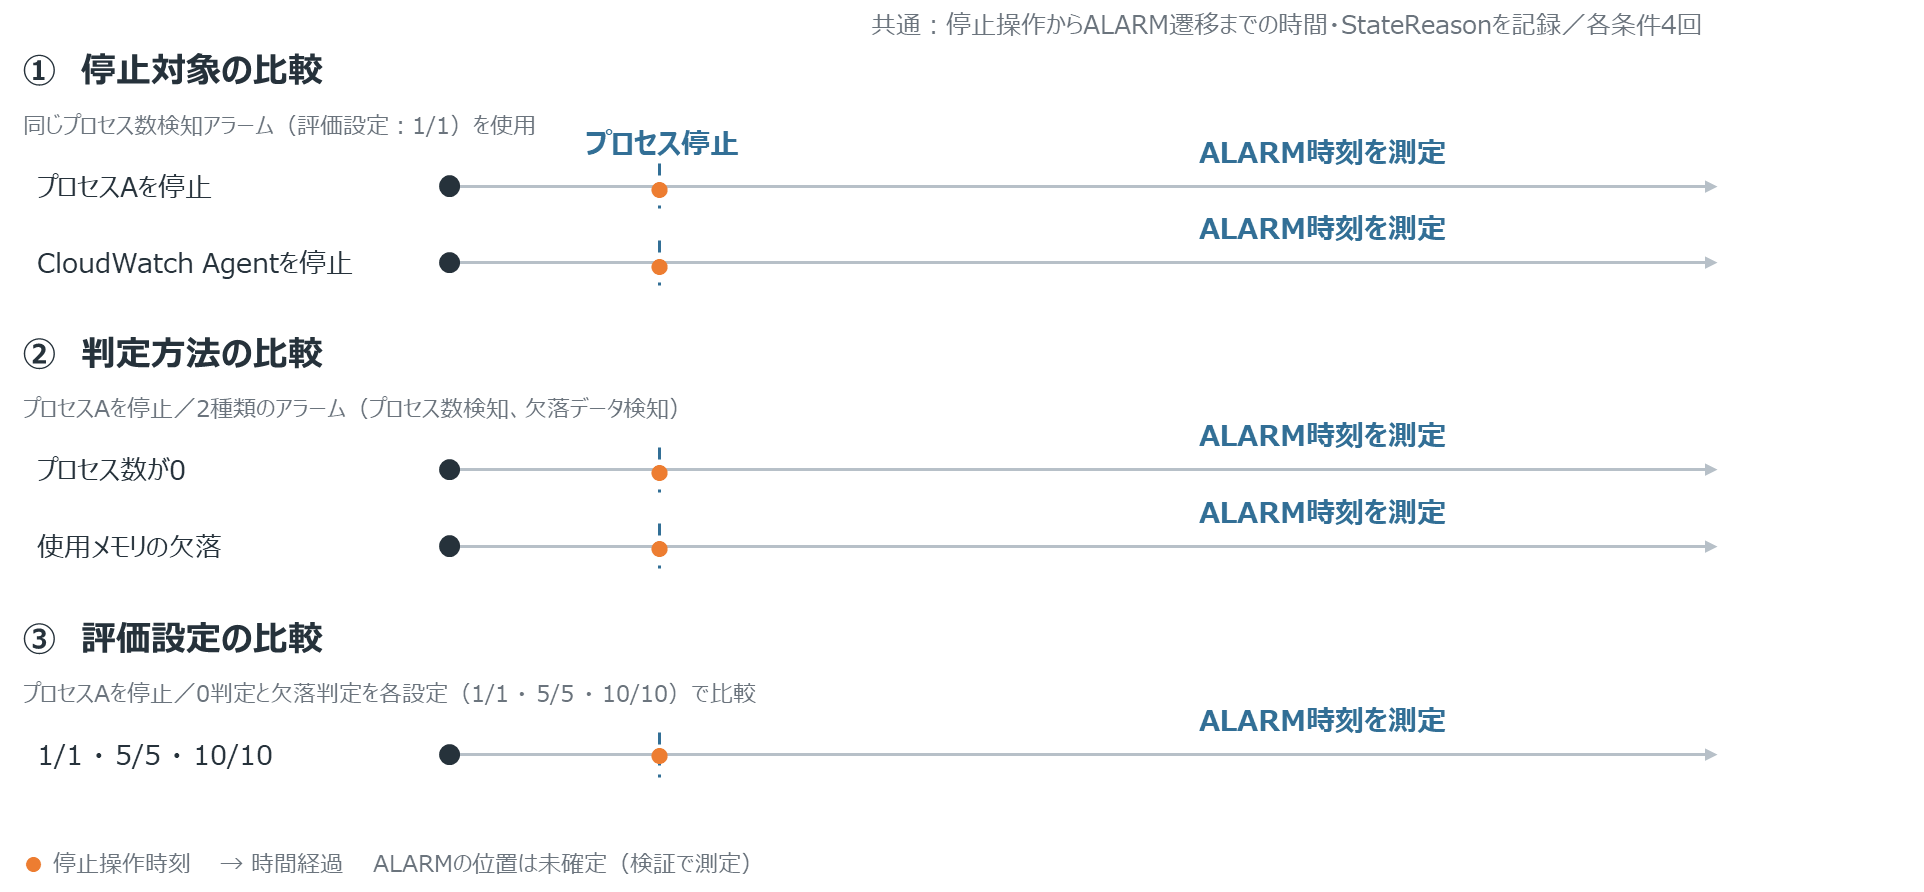
今回、以下の3つの比較を実施しました。
1. 通常のプロセス停止とAgent停止の比較
systemctl stopで監視対象プロセスを停止した場合と、CloudWatch Agentを停止した場合の検知時間を比較しました。
どちらもプロセスAのプロセス数を監視するprocstat_lookup_pid_countのアラームを使用しています。
2. プロセス数が0になる場合とデータが欠落する場合の比較
検証1の要因を調べるため、同じプロセスに対して2種類のメトリクスを使用しました。
| メトリクス | 選定理由 |
|---|---|
procstat_lookup_pid_count |
プロセス数が0になった場合の検知時間を確認するため |
procstat_memory_rss |
データが欠落した場合の検知時間を確認するため |
procstat_memory_rssはプロセスのメモリ使用量を取得するメトリクスです。
今回は欠落による判定を確認するため、しきい値を0未満、欠落データの扱いをbreachingに設定しました。
メモリ使用量は負の値にならないため、しきい値を「0未満」に設定することで、プロセス起動時はALARMにならないようにしました。
一方、データが欠落した場合は、異常として評価されます。
これにより、同じプロセスを停止した際に、プロセス数が0になった場合と、データが欠落した場合の検知時間を比較しました。
3. 評価期間数による比較
アラームの評価期間数を変更し、検知時間がどのように変化するか確認しました。
| 評価設定 | 評価条件 |
|---|---|
| 1/1 | 1分間隔のデータポイント1個で判定 |
| 5/5 | 5分間隔のデータポイント5個で判定 |
| 10/10 | 10分間隔のデータポイント10個で判定 |
※ 全てperiodは60秒。
全ての測定では、停止操作の時刻とALARM発生時刻に加え、アラーム履歴のStateReasonも記録しました。
検証結果
Agent停止時は、通常のプロセス停止より検知が遅かった
プロセスAのprocstat_lookup_pid_count アラームで、通常のプロセス停止とCloudWatch Agent停止の検知時間を比較しました。
| 停止したプロセス | 平均検知時間 | ALARMの判定理由 |
|---|---|---|
| プロセスA | 約104秒 (約1分24秒) | プロセス数0 |
| CloudWatch Agent | 約350秒 (約5分50秒) | データの欠落 |
※1/1設定。各4回の平均。
同じ procstat_lookup_pid_countアラームでも、CloudWatch Agent停止時は約4分長くかかりました。
StateReasonを見ると、通常のプロセス停止ではプロセス数0、CloudWatch Agent停止では欠落データで判定されていました。
同じプロセスでも「0」と「欠落」で差が出た
同じ停止操作に対し、 procstat_lookup_pid_countアラームとprocstat_memory_rssアラームを同時に測定しました。
| 対象 | プロセス数が0で判定 |
欠落データで判定 | 差 |
|---|---|---|---|
| プロセスA | 平均104秒 (約1分24秒) | 平均383秒 (約6分23秒) | 約279秒 (約4分39秒) |
| プロセスB | 平均136秒 (約2分16秒) | 平均402秒 (約6分42秒) | 約266秒 (約4分26秒) |
※1/1設定。各4回の平均。
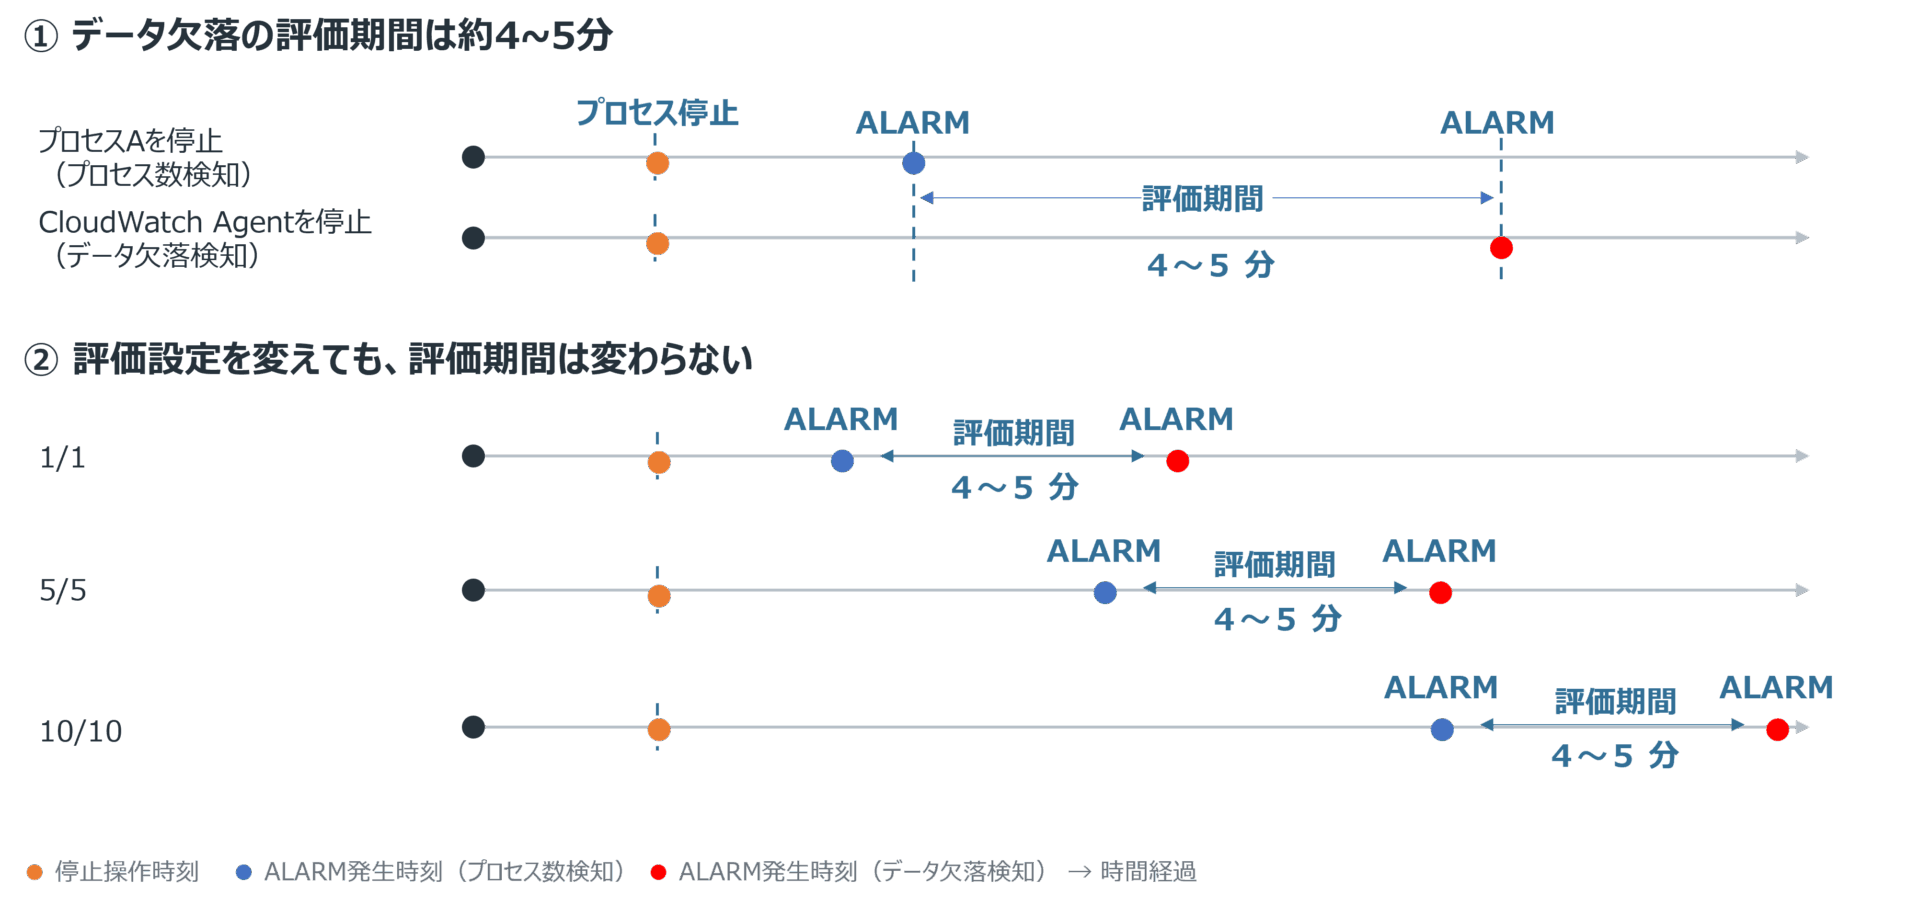
欠落データ側は約4~5分遅く、検証1のCloudWatch Agent停止時の検知時間に近い結果になりました。
判定理由にも違いが表れています。
# プロセス数が0になった場合
... [0.0 (...)] was less than the threshold (1.0)

# データが欠落した場合
no datapoints were received for 1 period
and 1 missing datapoint was treated as [Breaching].
今回の条件では、同じプロセスを停止しても、プロセス数か欠落データでALARMと判断するかで検知時間が大きく変わりました。
5/5・10/10でも欠落による判定が遅かった
プロセスAを停止し、1/1・5/5・10/10を同時に比較しました。
| 評価設定 | プロセス数の0で判定 |
欠落データで判定 | 差 |
|---|---|---|---|
| 1/1 | 約2分28秒 | 約6分46秒 | 約4分18秒 |
| 5/5 | 約5分58秒 | 約11分03秒 | 約5分05秒 |
| 10/10 | 約11分32秒 | 約16分08秒 | 約4分36秒 |
※各4回の平均。
どの評価設定でも欠落側が約4~5分遅くなりました。
また、今回の検証では、欠落による検知時間が設定上の評価時間より約6分長くなる傾向が見られました。
考察:なぜデータの欠落による検知は遅くなるのか
今回の検証では、CloudWatch Agentを停止するとメトリクスが欠落し、ALARMになるまで約6分かかりました。
では、なぜデータが届かなくなっても、すぐにALARMにならないのでしょうか。
CloudWatchは過去のデータも使って評価する
AWS公式の「CloudWatch アラームの欠落データの処理の設定」では、CloudWatchが欠落データを評価する仕組みについて説明されています。
このデータ取得範囲を評価範囲(Evaluation Range)と呼びます。
例えば、評価期間を1/1に設定していても、直近の1データポイントだけで評価されるとは限りません。
CloudWatchは、評価範囲内に十分な実データが残っている場合、そのデータを使ってアラームを評価します。
そのため、TreatMissingData=breachingに設定していても、評価範囲内にデータが残っている場合、データが途切れた瞬間にALARMになるとは限りません。
この挙動は、「CloudWatch Alarmは「評価範囲」に基づいて状態遷移する」でも紹介されています。
こちらはALARMからOKへの復帰を扱った記事ですが、過去のデータが状態遷移に影響する点は今回の検証と共通しています。
参考:
今回の検証結果との関係
今回のアラーム履歴には、次の判定理由が記録されていました。
no datapoints were received for 1 period
and 1 missing datapoint was treated as [Breaching].
つまり、CloudWatch Agent停止時に、データ欠落により、ALARMが発生しています。
一方、ALARMになるまで約6分かかった理由については、前述したようにCloudWatchの評価範囲の仕組みが関係していると考えられます。
CloudWatch Agentが停止して新しいメトリクスが届かなくなっても、過去のデータが評価範囲に残っているため、そのデータがアラームの評価に使用されます。
これが、CloudWatch Agent停止時の検知がすぐに行われない理由の一つと考えられます。
また、今回の結果は、評価範囲が約6分であることを示唆しています。
ただし、検知時間にはメトリクスの収集・送信タイミングや、アラームの評価タイミングも関係します。
AWS re:Postの「Understanding CloudWatch Alarm Evaluation: Why Alarms Delay, Fire Unexpectedly, or Get Stuck」でも、これらを分けて考える重要性が説明されています。
参考 :Understanding CloudWatch Alarm Evaluation: Why Alarms Delay, Fire Unexpectedly, or Get Stuck
まとめ
今回の検証では、CloudWatch Agent自身の停止時に検知が遅れる原因として、アラームの判定方法の違いが関係していることが分かりました。
特に、メトリクスの欠落による検知は、プロセス数0による検知より約4~5分遅れる結果となりました。
監視する側が止まると、異常に気づくのも一苦労のようです。
今回の検証が、監視設計の参考になれば幸いです!