LifeKeeperの『困った』を『できた!』に変える!サポート事例から学ぶトラブルシューティング&再発防止策
こんにちは、SCSKの前田です。
いつも TechHarmony をご覧いただきありがとうございます。
連載「日常運用・障害試験で役立つ!監視・通知・トラブルシューティング術」の第一弾では、システムの異常を察知する「目と声」である監視・通知を、第二弾では、状況を正しく把握するための「窓」であるGUIと管理ツールについて解説してきました。
これで、異常に気づき、状況を確認する準備は整いました。しかし、運用担当者にとって最も緊張が走る瞬間は、その先にあります。それは、「実際に障害が起きたときに、本当にシステムが切り替わるのか?」という確認、そして「万が一、両系が破損したときに、確実に元に戻せるのか?」という復旧への備えです。
設計・構築が完璧に見えても、いざ本番環境で試験をしてみると「想定通りにフェイルオーバーしない」「OSが再起動を繰り返して止まらない」といった予期せぬ挙動に直面することがあります。また、バックアップについても「いざ戻そうと思ったら、LifeKeeperの設定が最新ではなかった」という事態は絶対に避けなければなりません。
シリーズ第一弾(Season 1)の締めくくりとなる今回は、運用フェーズの要である「障害試験」と「バックアップ・リストア」に焦点を当てます。AWS/Azure特有の試験のコツから、意外と知られていないバックアップの仕様まで、サポート事例を元に「確実に動く、確実に直せる」ためのポイントを徹底解説します。
💡 前回の記事(カテゴリ6 第二弾)はこちら!
▶【日常運用・障害試験で役立つ!監視・通知・トラブルシューティング術 #2】「画面が開かない・重い」を打破!GUIトラブル脱出への道と次世代WMC運用の勘所 – TechHarmony
はじめに
本記事のテーマは、「実環境に即した障害試験の実施」と「確実なリカバリのためのバックアップ設計」です。
LifeKeeperを導入したシステムのゴールは「止まらないこと」ですが、その信頼性を支えるのは、泥臭いまでの試験と、万全なバックアップです。しかし、特にクラウド環境や複雑なストレージ構成においては、OSコマンド一つ、あるいはバックアップソフトの設定一つで、LifeKeeperの挙動が大きく左右されることがあります。
今回の記事を通じて、以下の「できた!」をゴールに解説を進めていきます。
- 「できた!①」:クラウド環境(AWS/Azure)で、迷わず確実な障害試験ができるようになる。
- 「できた!②」:試験時の思わぬ挙動(OS再起動ループなど)の原因と回避策がわかる。
- 「できた!③」:LifeKeeper/DataKeeperの仕様に基づいた、正しいバックアップ・リストア計画が立てられる。
それでは、実際のサポート事例から、現場で役立つトラブルシューティングと再発防止策を見ていきましょう。
今回の「困った!」事例
本番運用を目前に控えたお客様から寄せられた、切実な「困った!」をご紹介します。一見するとスムーズにいくはずの試験やバックアップですが、そこにはクラウドの特性や製品の仕様にまつわる「落とし穴」が潜んでいました。
【エピソード1:障害試験編】
「AWS/Azureで試験をしてもフェイルオーバーしない!? & 恐怖のOS再起動ループ」
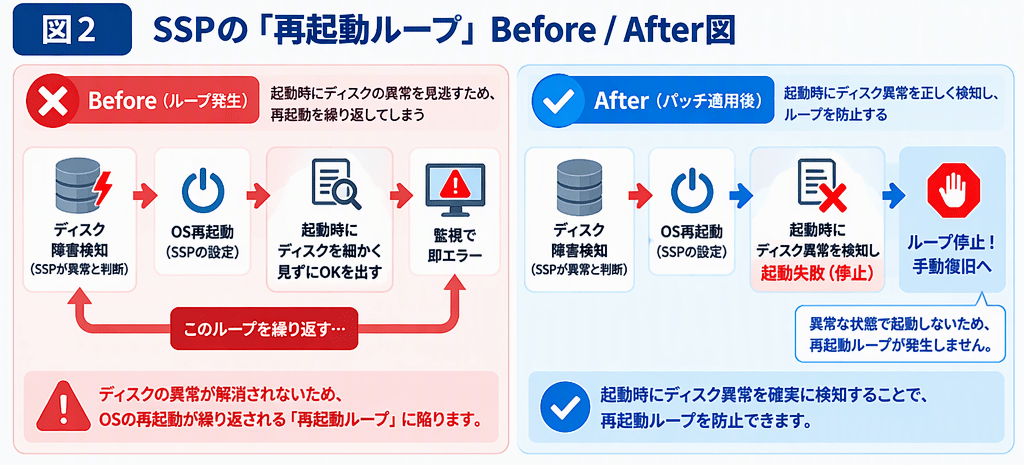
● 事象の概要: AWSやAzure環境で、システムの可用性を確認するためにネットワーク遮断試験を行ったところ、「通信は切れているはずなのにフェイルオーバーが発生しない」という相談が寄せられました。また、WindowsのSSP(Single Server Protection)環境では、ディスク障害を模した試験を行ったところ、OSが再起動を繰り返す無限ループに陥るという事態が発生しました。
● 発生時の状況:
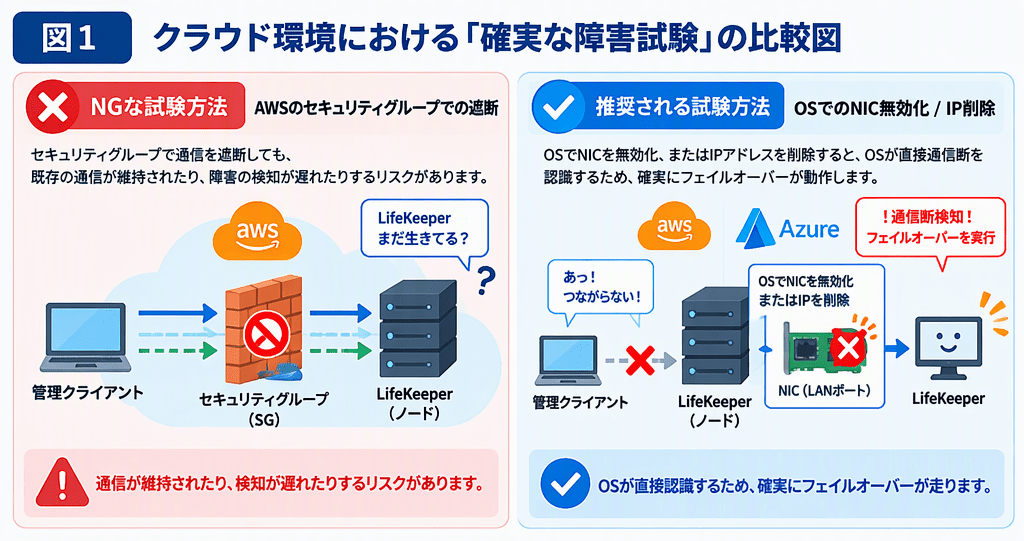
- AWSのお客様: AZ(アベイラビリティゾーン)障害を想定し、セキュリティグループ(SG)で全通信を遮断して擬似障害を起こそうとしたが、LifeKeeperが正常と判断し続け、切り替わらなかった。
- Azureのお客様: 正常性プローブ(LBHC)の試験をしたいが、Linuxのようにプロセスを強制終了(いわゆる「キル」)しようとしても、Windows版では該当するプロセスが見当たらない。
- SSPのお客様: ディスクをオフラインにして障害を検知させたところ、OS再起動が走った。しかし、再起動後もディスクが障害状態のため、LifeKeeperの起動処理直後に再びエラーとなり、再起動を繰り返してしまった。
● 原因究明のプロセスと判明した根本原因: サポートチームとの連携により、以下の事実が判明しました。
- クラウドの仕様: AWSのセキュリティグループによる遮断は、既存の通信セッションが維持されたり、AWS側の反映にタイムラグが生じたりすることがあり、LifeKeeperの「コミュニケーションパス断」として即座に認識されないケースがある。
- Quorumの盲点: S3 Quorum/Witnessを利用している場合、ノード間の通信が切れても、各ノードがS3へのアクセスを維持できている限り、フェイルオーバーは抑止される(仕様通りの挙動)。
- SSPの起動仕様: 旧来のWindows版SSPでは、ボリュームリソースの「起動処理」自体はディスクの状態を詳細にチェックせず完了させていたため、その後の「監視処理」で即エラーとなり、OS再起動のトリガーを引いていた。
● 具体的な解決策:
- 試験手法の変更: AWSではSG遮断ではなく、OS上のNICを無効化する、あるいはIPアドレスを削除するといった「OSから見て確実にリソースが利用不可になる方法」を推奨。
- LBHCの試験: Azureではプロセス停止ではなく、Azureポータル側でバックエンドプールからノードを一時的に外すことで、確実にプローブを失敗させる手法を提示。
- SSPの改善: 修正パッチを適用することで、リソース起動時にディスクの状態を厳密にチェックし、異常があれば「起動失敗」として扱う(OS再起動を繰り返さない)よう改善。
【エピソード2:バックアップ・リストア編】
「VSSが切り替えを邪魔する? & バックアップデータが他ノードで使えない謎」
● 事象の概要: 「障害復旧のためにバックアップを運用に組み込みたい」というご相談の中で、WindowsのVSS(ボリューム・シャドウ・コピー)との干渉や、バックアップデータの持ち運びに関する誤解が見つかりました。
● 発生時の状況:
- DataKeeper利用中のお客様: 障害復旧用にVSSでスナップショットを取得しているが、これがLifeKeeperのリソース切り替えに悪影響を及ぼさないか不安。
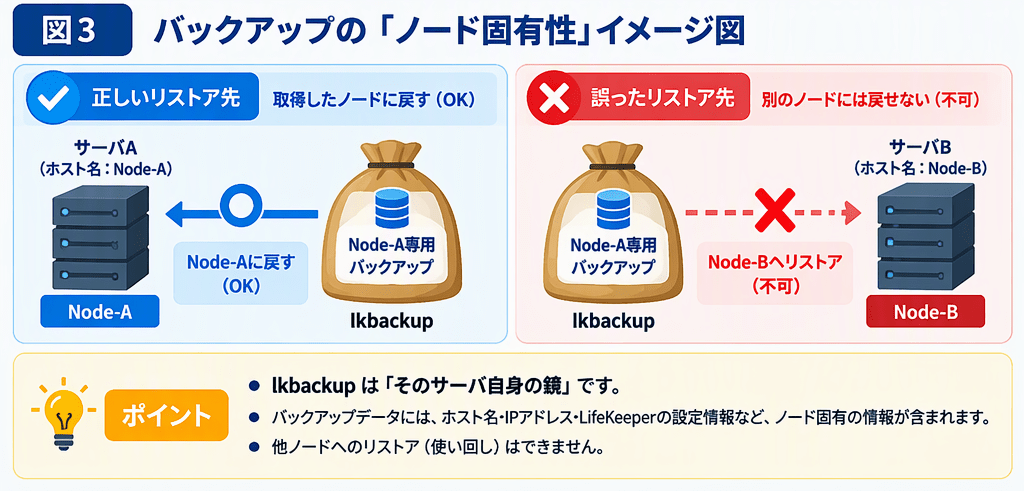
- Linux版のお客様: 「万が一のために片方のノードで取った
lkbackupデータを、もう片方のノードのリストアに使いたいが、問題ないか?」という確認。
● 原因究明のプロセスと判明した根本原因:
- VSSの残留問題: DataKeeperでミラーリングしているボリューム上にVSSのスナップショットが残留していると、LifeKeeperがリソースを停止(アンマウント)しようとした際に、VSSがボリュームを掴んでいるため処理が拒否され、フェイルオーバーが失敗する可能性がある。
- バックアップのノード固有性: LifeKeeperのバックアップデータ(
lkbackup)には、そのサーバ固有のホスト名や内部IDが含まれているため、別のサーバにそのままリストアすることはできない。
● 具体的な解決策:
- VSSの管理: スイッチオーバー実行前に、
vssadminコマンドを使用してミラーボリューム上にスナップショットが残留していないか確認する運用、あるいはスナップショットの保存先を非ミラーボリュームにする設計を推奨。 - バックアップ運用の確立: バックアップは「各ノード」で個別に取得・保存することを鉄則とし、自動バックアップ機能(毎日午前3時)を有効活用して、常に最新の設定を各サーバに保持するよう案内。
「再発させない!」ための対応策と学び
障害試験の失敗やバックアップの不備は、本番稼働後の「命取り」になります。事例から得られた教訓を整理し、明日から使えるチェックリストとベストプラクティスにまとめました。
● 具体的な解決策:トラブル発生時のアクション
もし試験中や運用中に同様の事象が起きたら、以下の手順で切り分け・対応を行ってください。
- 想定通りにフェイルオーバーしない場合: まずは「コミュニケーションパス」と「Quorum」の状態を確認してください。クラウドのSG遮断で試験をしている場合、セッションが維持されている可能性があります。OSレベルでNICを無効化し、物理的な切断に近い状態を作り出すことが確実な解決策です。
- OS再起動ループに陥った場合(SSP): 原因は「障害が継続しているリソースの自動起動成功」にあります。まずはパラメータ(
SSP_NOTIFICATION_ONLY=1)を設定して再起動を一時停止させ、根本原因であるディスク障害の復旧、または最新パッチの適用を行ってください。 - リソース停止がエラーになる場合(DataKeeper): VSSスナップショットが残っていないか、
vssadmin list shadowstorageコマンドで確認してください。もし残留していれば削除することで、リソースの停止(アンマウント)が可能になります。
● 再発防止策:運用準備チェックリスト
本番移行前に、以下の項目がクリアされているか確認しましょう。
| 確認項目 | チェックポイント |
|---|---|
| 障害試験の手法 | [ ] AWS/Azureの仕様に依存する「SG遮断」ではなく、OSコマンドによるNIC無効化やIP削除を試験手順としているか? |
| Quorumの考慮 | [ ] Quorum先(S3等)への通信遮断試験を行う際、フェイルオーバー先まで道連れにしない設定(試験ノード側のみ遮断)になっているか? |
| バックアップの網羅性 | [ ] lkbackup を「全ノード」で取得する運用になっているか?(片系のみでは不足) |
| VSSの配置設計 | [ ] VSSスナップショットの保存先が、DataKeeperのミラーボリューム以外に設定されているか? |
| 最新パッチの確認 | [ ] 特にWindows/SSP環境において、ディスク障害時の挙動に関する最新パッチが適用されているか? |
● ベストプラクティス:LifeKeeperをより安全に運用するために
- 「擬似障害」は物理に近いレイヤーで実施する クラウド環境では、ネットワークの論理的な遮断(SGなど)よりも、OSから見たデバイスの消失(NIC無効化やシャットダウン)の方が、LifeKeeperの検知ロジックと確実に合致し、信頼性の高い試験結果が得られます。
- リカバリキットの追加は「オンライン」を活用する 「EC2リカバリキットを後から入れたい」といった場合も、LifeKeeperサービスや既存リソース(QSPなど)を止める必要はありません。サービスを稼働させたままセットアップできる仕様を理解しておくことで、メンテナンスのハードルを下げられます。
- バックアップは「同一ノード・同一構成」が鉄則 LifeKeeperの構成情報は、各ノードのホスト名やIDと密接に紐付いています。万が一の際は「バックアップを取ったそのサーバ自身に戻す」のが大原則です。他ノードへの使い回しはできないため、必ず全台分(毎日3時の自動バックアップ等)を管理対象に含めてください。
関連ドキュメント:
- [Windows] LifeKeeper/DataKeeper の構成情報のバックアップおよびリストアについて
- LifeKeeper for Linuxのlkbackupコマンドで取得したバックアップ情報の利用条件について
まとめ
全3回にわたってお届けしてきたカテゴリ6「日常運用・障害試験で役立つ!監視・通知・トラブルシューティング術」の締めくくりとして、今回は障害試験とバックアップ・リストアについて解説しました。
監視(目)と通知(声)を整え、管理画面(窓)を確保し、そして今回の「試験とバックアップ」というアクションを完遂することで、LifeKeeperを中心とした高可用性システムの運用サイクルは初めて完成します。
「日々の運用でここを意識すれば防げます!」
- 試験は「リアル」を追求する: クラウドの論理的な設定に頼りすぎず、OSレベルで確実に「異常」を認識させる手法を選びましょう。
- バックアップは「各ノードの個性」を認める: 共通のデータとして扱うのではなく、各ノードが持つ固有の設定情報を大切に保管してください。
連載「LifeKeeperの『困った』を『できた!』に変える!サポート事例から学ぶトラブルシューティング&再発防止策」のSeason 1は、これにて完結です。 これまでご紹介してきた数々のトラブル事例は、いずれも現場の担当者の皆様が、システムの安定稼働を願う中で直面した「壁」でした。その壁を一つひとつ乗り越えてきたサポートの知恵が、この記事を通じて皆様の運用を支える一助となれば幸いです。
日々の運用、本当にお疲れ様です。皆様のシステムが、今日も、そして明日も「何事もなく」動き続けることを願っております。
次回予告
これまで全6カテゴリにわたってお届けしてきた連載企画「LifeKeeperの『困った』を『できた!』に変える! サポート事例から学ぶトラブルシューティング&再発防止策」。
今回をもちまして、障害対応の最前線を凝縮した「トラブルシューティング編(Season 1)」は完結となります。最後までお読みいただき、本当にありがとうございました。
しかし、LifeKeeperをより安全・快適に使いこなすための旅は、まだ終わりません。 次回からは、装いも新たに Season 2 がスタートします!
Season 2 連載企画タイトル
「LifeKeeperの『困った』を『できた!』に変える! Season 2 サポート事例から学ぶ設計・運用ベストプラクティス」
Season 1では「起きてしまった障害への対応」をメインに扱ってきましたが、Season 2では、寄せられる相談事例の傾向から導き出した「障害を未然に防ぐための設計・運用」に焦点を当てます。
AWSやAzureなどの最新クラウドアーキテクチャ、セキュリティ対策、自動化など、今の時代の運用管理者が本当に知りたい「失敗しないためのベストプラクティス」を、具体的な構成案とともにご紹介していきます。
記念すべき Season 2 第1回は……
カテゴリ1:AWS・クラウドアーキテクチャ設計編 「Route53?Route Table?NLB? AWSで失敗しないLifeKeeper構成選定術」
を投稿予定です。「そもそもどの構成が自分たちに最適なのか?」という最初の壁を、サポートの知見をフル活用して突破します。
待望の新シリーズ、どうぞご期待ください!
📚 本連載のバックナンバー
過去のトラブル事例と解決策もぜひあわせてご覧ください!
カテゴリ1:リソース起動・フェイルオーバー失敗の深層
▶【リソース起動・フェイルオーバー失敗の深層 #1】EC2リソースが起動しない!クラウド連携の盲点とデバッグ術 – TechHarmony
▶【リソース起動・フェイルオーバー失敗の深層 #2】ファイルシステムの思わぬ落とし穴:エラーコードから原因を読み解く – TechHarmony
▶【リソース起動・フェイルオーバー失敗の深層 #3】設定ミス・通信障害・バージョン違いの深層と再発防止策 – TechHarmony
カテゴリ2:OS・LKバージョンアップで泣かないために
▶【OS・LKバージョンアップで泣かないために #1】OSバージョンは変えていないのに!?カーネル更新の「落とし穴」と互換性の真実 – TechHarmony
▶【OS・LKバージョンアップで泣かないために #2】「設定が消えた!?」「亡霊IPが警告!?」を防ぐロードマップ:単純な上書き更新に潜む落とし穴と回避策 – TechHarmony
カテゴリ3:クラウド環境特有の落とし穴
▶【クラウド環境特有の落とし穴 #1】良かれと思った自動復旧が仇に!?AWS環境(EC2/Route53/S3)でハマる構成と回避策 – TechHarmony
▶【クラウド環境特有の落とし穴 #2】オンプレ感覚の「同一サブネット」はNG!?Azure環境のネットワーク要件とQuorum設計の最適解 – TechHarmony
カテゴリ4:DataKeeper:ミラー同期とデータ保護の核心
▶【DataKeeper:ミラー同期とデータ保護の核心 #1】同期中だから切り替わらない!?フェイルオーバーの「絶対条件」と性能評価の罠 – TechHarmony
▶【DataKeeper:ミラー同期とデータ保護の核心 #2】スナップショットから戻したのに動かない!?リストア後の「整合性」確保とバックアップ連携の盲点 – TechHarmony
カテゴリ5:クラスタ健全性維持の要
▶【クラスタ健全性維持の要 #1】クラスタの番人Quorum/Witness:その設定、本当に必要? 正しく選んで正しく守る設計術 – TechHarmony
▶【クラスタ健全性維持の要 #2】途絶えた命綱が「分離」を招く。コミュニケーションパス設計の定石とAWS環境の最適解 – TechHarmony
カテゴリ6:日常運用・障害試験で役立つ!監視・通知・トラブルシューティング術
▶【日常運用・障害試験で役立つ!監視・通知・トラブルシューティング術 #1】異変を逃さない!メール通知の「落とし穴」と、原因を読み解くログ監視の極意 – TechHarmony
▶【日常運用・障害試験で役立つ!監視・通知・トラブルシューティング術 #2】「画面が開かない・重い」を打破!GUIトラブル脱出への道と次世代WMC運用の勘所 – TechHarmony
▶【日常運用・障害試験で役立つ!監視・通知・トラブルシューティング術 #3】これで安心!LifeKeeperの障害試験とバックアップ・リストア手順:実例から学ぶ確実な復旧への道