はじめに
こんにちは、関根です。
ここ最近Snowflakeの記事をいくつか書いてきましたが、使えば使うほど「Snowflake一つでだいたい何でもできるな」と感じます。データをためるのも、加工するのも、AIに読ませるのも、Snowflakeの中で完結します。
ただ、その「何でも」は基本的にSQLで書くのが前提です。特に面倒なのが、運用まわりです。
- フロー設計:取込・加工・公開といったパイプラインの順番をSQLでつないで組み立てる
- スケジュール・リトライ:毎朝何時に動かすか、失敗したら何回やり直すかを、SQLでスケジューリングする
- 通知処理:完了・失敗したときにSlackやメールを飛ばす仕組みを作る
最近はCortex Code(CoCo)のように、頼めばSQLを書いてくれる仕組みもあり、「書く」手間はだいぶ減りました。でも、運用の手間は減りません。ジョブが失敗したら原因を調べて再実行する、処理を1つ足したらフローとスケジュールを見直す。このあたりは、SQLをどのように作ったかに関係なく、ずっとついて回ります。
そこで今回使ってみたのがTROCCOです。データの取り込みや加工、処理フロー、スケジュール、通知までを画面で設定できるので、Snowflakeへのデータの出し入れがかなり楽になります。
ちょうど2026年10月15日に、TROCCOに「ファイル転送」という機能が追加されました。PDFや画像などの非構造化ファイルをそのまま転送してくれる機能です。このファイル転送とSnowflakeのAI機能(Cortex Search)を組み合わせて、手元のPDFにAIで質問できる仕組み(RAG)をどこまで簡単に作れるか試してみました。
題材は、自分がこれまでTechHarmonyに書いたブログ記事9本をPDFにしたものです。自分の記事なので、AIの答えが合っているかもすぐ分かります。
TROCCOとは
TROCCOは株式会社primeNumberが提供するクラウド型のデータ統合(ETL/ELT)サービスです。ブラウザ上で転送元と転送先を選ぶだけでデータ転送のジョブを作れます。
データを運ぶだけでなく、運んだあとの加工や、処理の順番・スケジュール管理まで一通りそろっています。主な機能を、公式の機能一覧からざっくり紹介します。
| 機能 | ざっくり言うと | 今回 |
|---|---|---|
| データ転送(ETL) | SaaS・データベース・ストレージなどからDWHへデータを運ぶ、TROCCOの基本機能。 転送元と転送先を選んで設定するだけで、転送のパイプラインを作れる。 |
― |
| データマート生成(ELT) | DWHに入れたデータを、SQLで分析しやすい形に加工する。 今回はここにSnowflakeのSQLを書いて、PDFのテキスト化やチャンク分割を動かしている。 |
使用 |
| ワークフロー(ジョブ管理) | 転送やデータマートを、決まった順番で動かす仕組み。 画面上で処理をつないで、スケジュールや失敗時の通知・再実行もここで設定する。 |
使用 |
| ファイル転送(新機能) | PDFや画像などのファイルを、中身を加工せずにそのまま運ぶ。 | 使用 |
| 運用支援・API連携 | 通知や再実行を画面から行えるほか、設定のコード管理やCI/CDとの連携にも対応している。 | 一部 |
このほかにも、独自のコネクタを作れる「カスタムコネクタ」、社内ネットワークの中でジョブを動かせる「Self-Hosted Runner」、データの品質チェックなどの機能があります。
TROCCOの新機能「ファイル転送」
ファイル転送は、2026年10月15日に追加された機能です。ポイントは次のとおりです。
| 項目 | 内容 |
|---|---|
| 転送元 | SFTPサーバー/ローカルファイル(Self-Hosted Runner経由) |
| 転送先 | Amazon S3/Google Cloud Storage |
| 転送の仕方 | PDFや画像などのファイルを、中身を変換せずそのまま運ぶ |
| 差分転送 | 前回から更新されていないファイルはスキップし、変わったファイルだけを運ぶ |
| 転送完了ファイル | 有効にすると、転送が成功したときに転送先へ空の ENDFILE を置いてくれる |
※ 2026年10月時点の情報です。ファイル転送はAdvancedプラン以上で利用できます。
※ 定期実行や失敗時の通知は、ファイル転送単体ではなくワークフロー側で設定します。
参考:ファイル転送(primeNumber公式)
検証の目的と構成
今回作るのは、SFTPサーバーに置いてあるPDFをAWS S3に転送して、Snowflakeに取り込み、AIで検索できるようにする仕組みです。
手順書や仕様書のようなPDFは、ファイルサーバーに置いたきりで、探すときはファイル名頼み……ということが多いと思います。そういうファイルを集めてAIで使える形にし、毎日の運用まで含めて作ります。
PDFの解析や検索の処理はSnowflakeのSQLで書きますが、その運用の部分(スケジュール・処理フロー・完了通知)をSQLを書かずに画面で設定できるかどうかが、今回の見どころです。
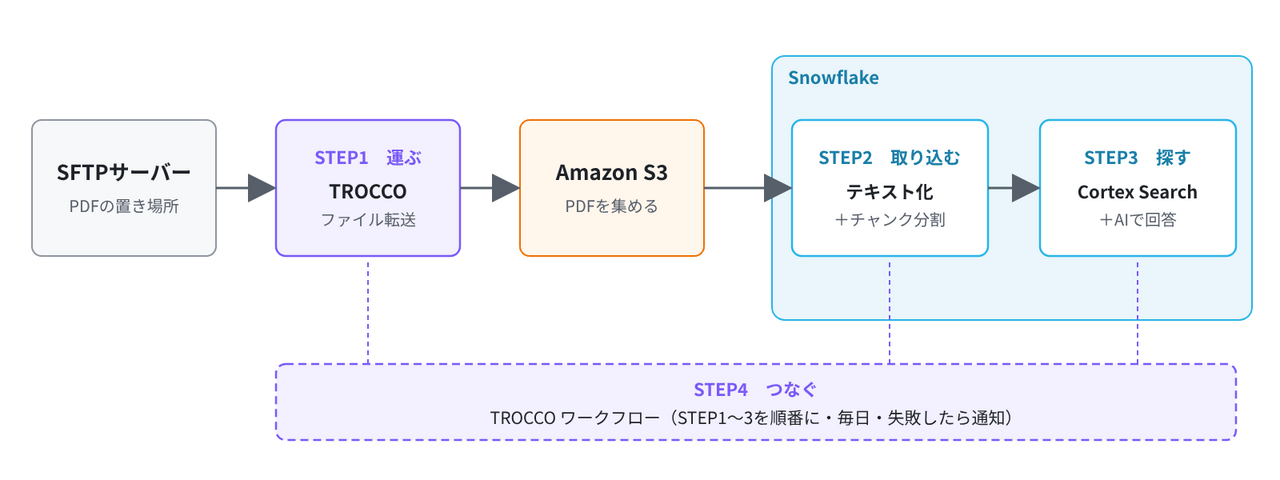
STEP1 運ぶ:SFTPサーバーのPDFをS3へ(TROCCO ファイル転送)
まずは、SFTPサーバー上にあるPDFをTROCCOのファイル転送でS3にコピーします。
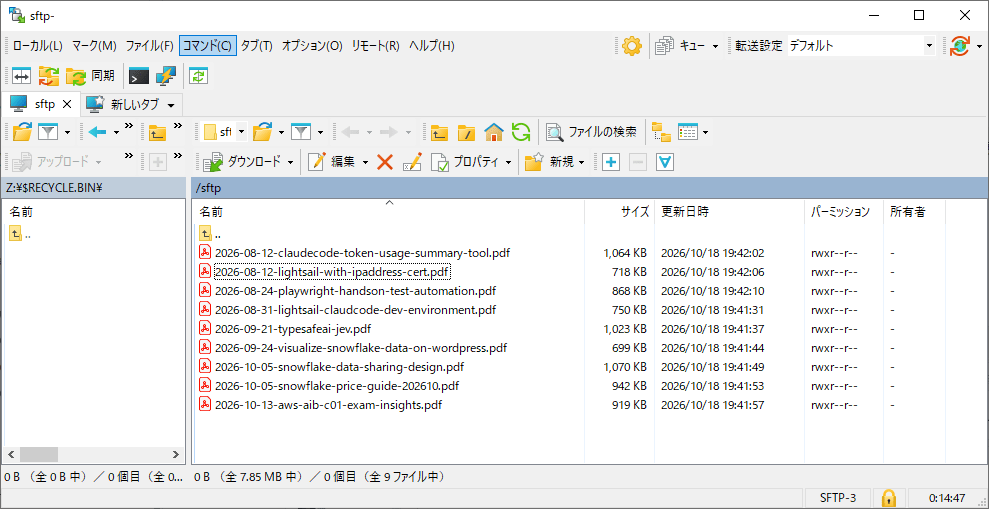
SFTPサーバーには、題材にする9本のPDFを置いてあります。
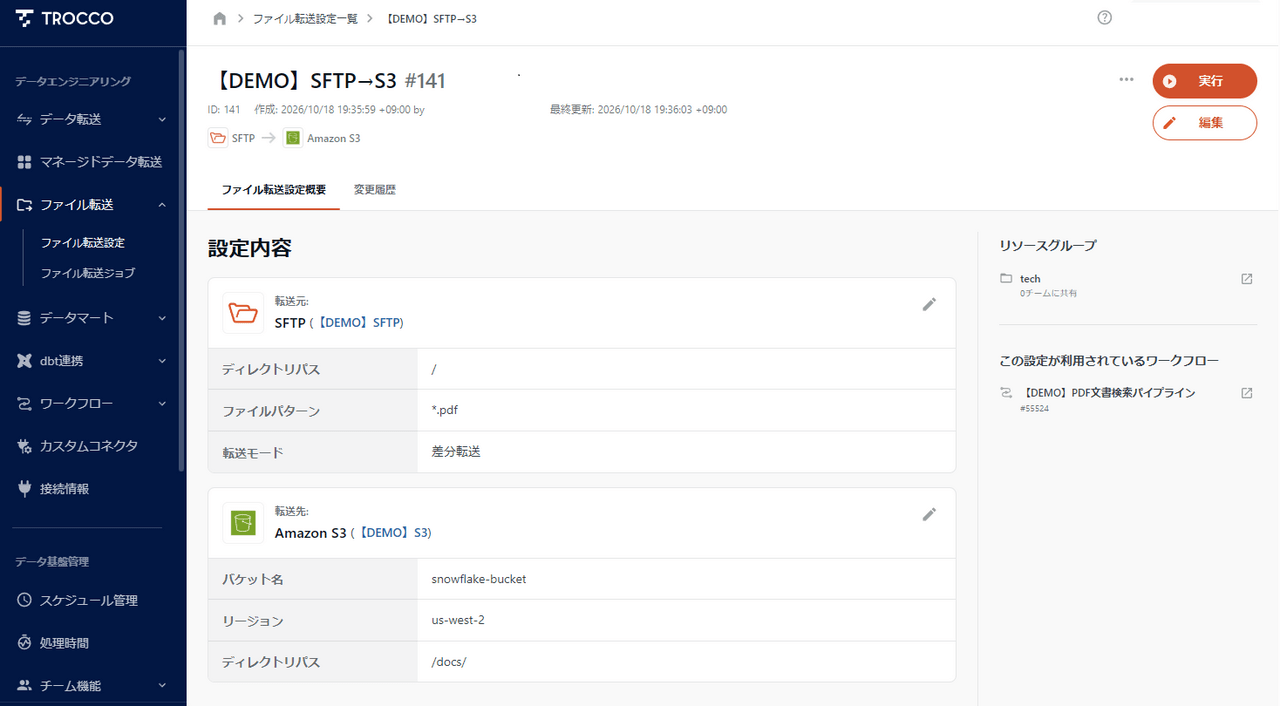
TROCCOでは、先に「SFTP」と「Amazon S3」の接続情報を作っておき、ファイル転送の設定で転送元・転送先として選ぶだけです。今回は転送元のファイルパターンを *.pdf、転送モードを「差分転送」にしています。
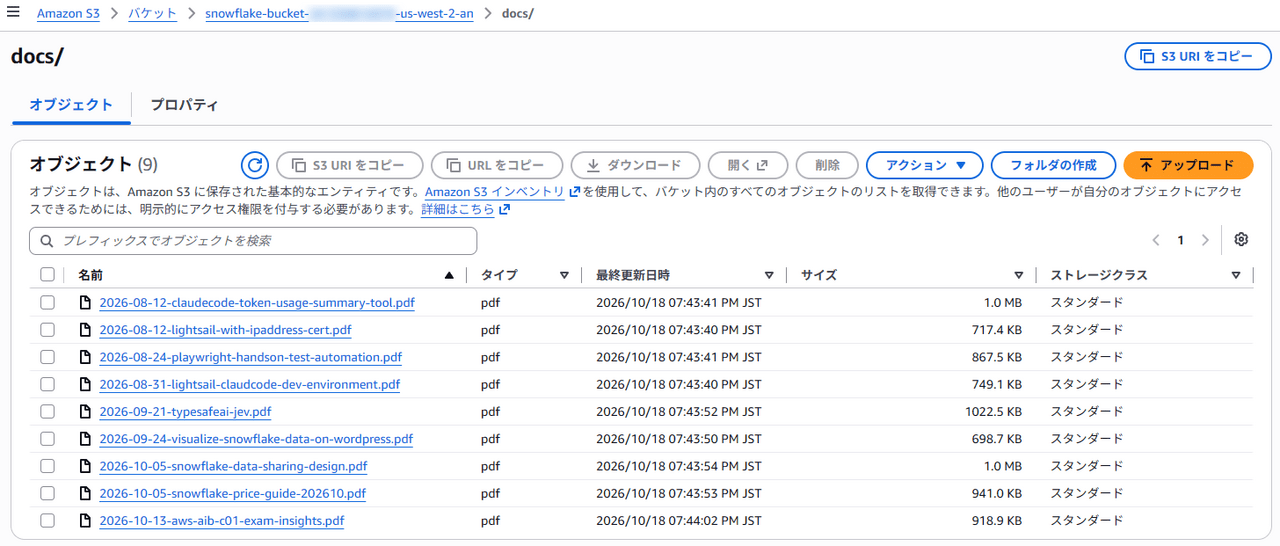
実行すると、S3の docs/ にPDFがそのままコピーされました。
現時点(2026年10月)の対応範囲と制約
・転送元:SFTP/ローカルファイル(Self-Hosted Runner経由)
・転送先:Amazon S3/Google Cloud Storage
・SFTPはパスワード認証が使えません(鍵認証のみ)。また、秘密鍵のパスフレーズには対応していません。
参考:ファイル転送(TROCCOドキュメント)
STEP2 取り込む:PDFをテキストにしてチャンクに分ける(TROCCO データマート)
S3に届いたPDFを、Snowflakeで文字に起こして、検索しやすい大きさ(チャンク)に分けます。
事前準備:ステージの作成(Snowflake)
ここだけは最初に1回、Snowflake上で作っておきます。S3を読むためのストレージ統合と、S3の docs/ をSnowflakeから見えるようにする外部ステージです。
CREATE STAGE DOC_DEMO.DOCS.DOC_STAGE
  URL = 's3://<バケット>/docs/'
  STORAGE_INTEGRATION = S3_DOCS_INT   -- 事前に作成したストレージ統合
  DIRECTORY = (ENABLE = TRUE);        -- ファイル一覧を使えるようにする
TROCCOのデータマートで取り込む
あとのクエリは、すべてTROCCOのデータマート定義で実行します。こうしておくと、S3からテーブルへの格納までをTROCCO側でスケジュール実行できます。処理は次の3つに分けました。
| データマート | 機能 | クエリ実行モード |
|---|---|---|
| 01_ステージ更新 | S3のファイル一覧をSnowflakeに反映する | 自由記述モード |
| 02_PDFテキスト化 | PDFを文字に起こして RAW_TEXT に格納 |
データ転送モード(全件洗い替え) |
| 03_チャンク分割 | テキストをチャンクに分けて DOC_CHUNKS に格納 |
データ転送モード(全件洗い替え) |
なお、STEP1のファイル転送は差分転送ですが、ここから先のSnowflake側は毎回全件を処理しています。つまり、S3に運ばれるのは変わったファイルだけでも、PDFのテキスト化は全ファイル分が毎回走ります。今回は9本だけなので、仕組みを単純にするために全件洗い替えにしました。ファイルが増えてくると、テキスト化の時間とAI関数の利用料がそのまま増えるので、更新されたファイルだけを処理する差分方式に変えた方がよさそうです。
01_ステージ更新
S3に置かれたファイルの一覧は、Snowflake側で自動では更新されません。そのため毎回いちばん最初に REFRESH を流しておきます。
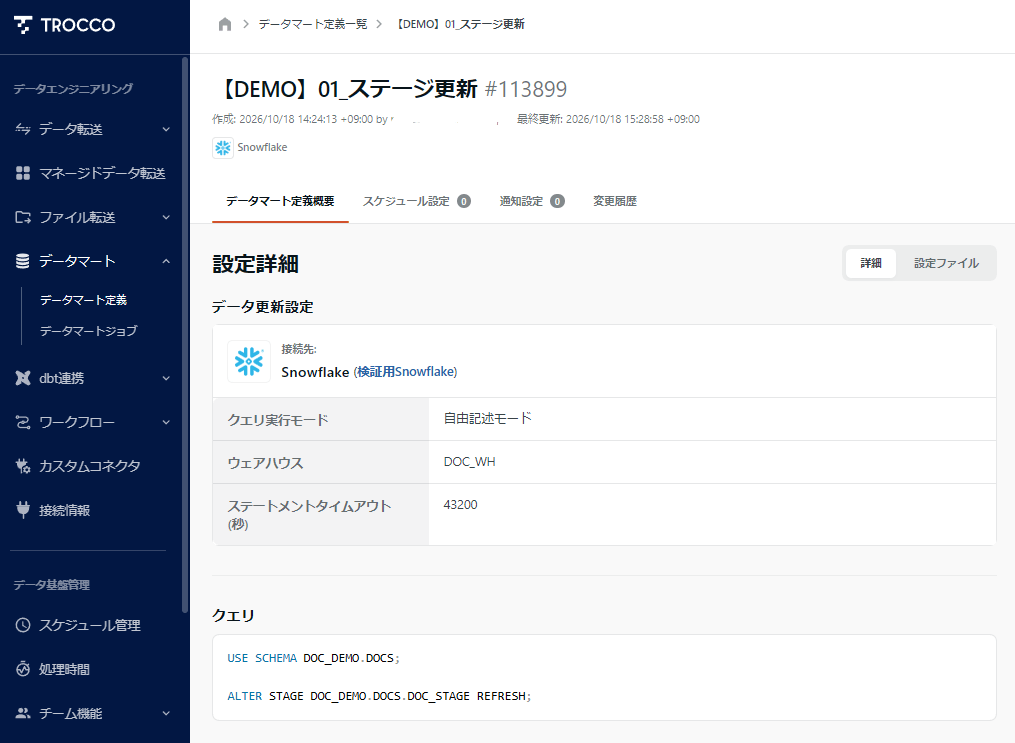
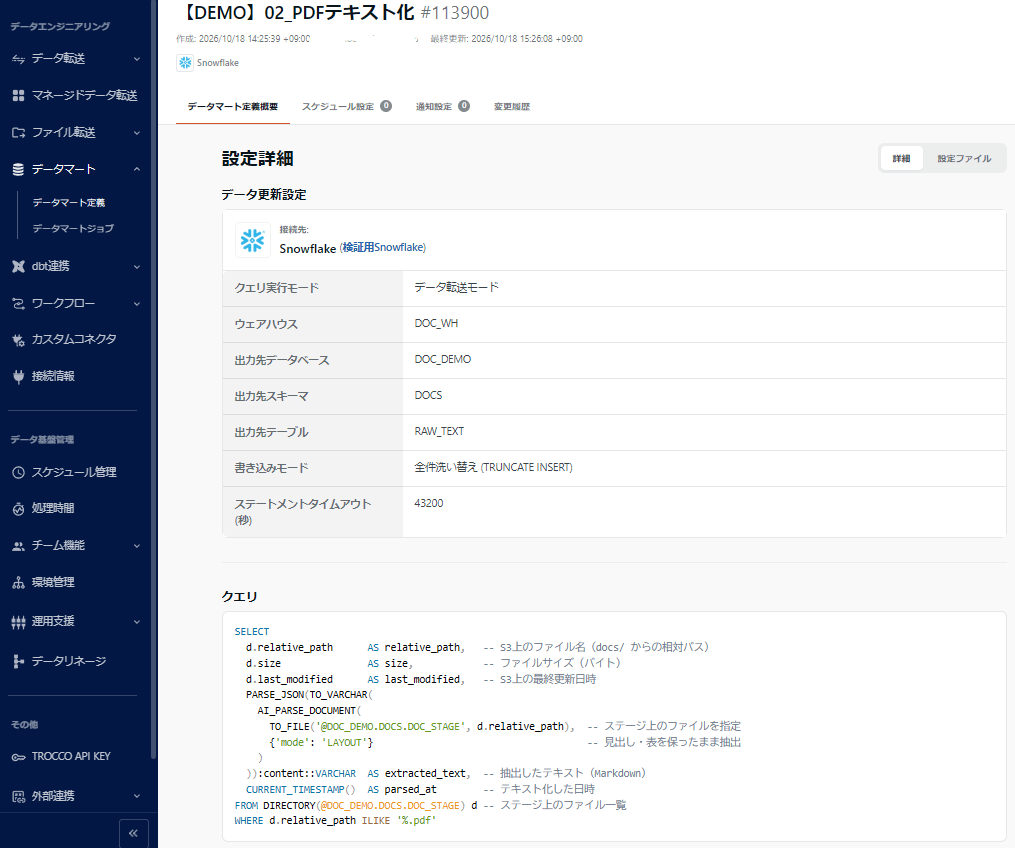
02_PDFテキスト化
AI_PARSE_DOCUMENT でPDFを文字に起こします。LAYOUTモードにすると、見出しや表をMarkdownの形で残してくれます。データ転送モードで出力先を RAW_TEXT、書き込みモードを全件洗い替えにしておくと、テーブルもTROCCOが作ってくれます。
03_チャンク分割
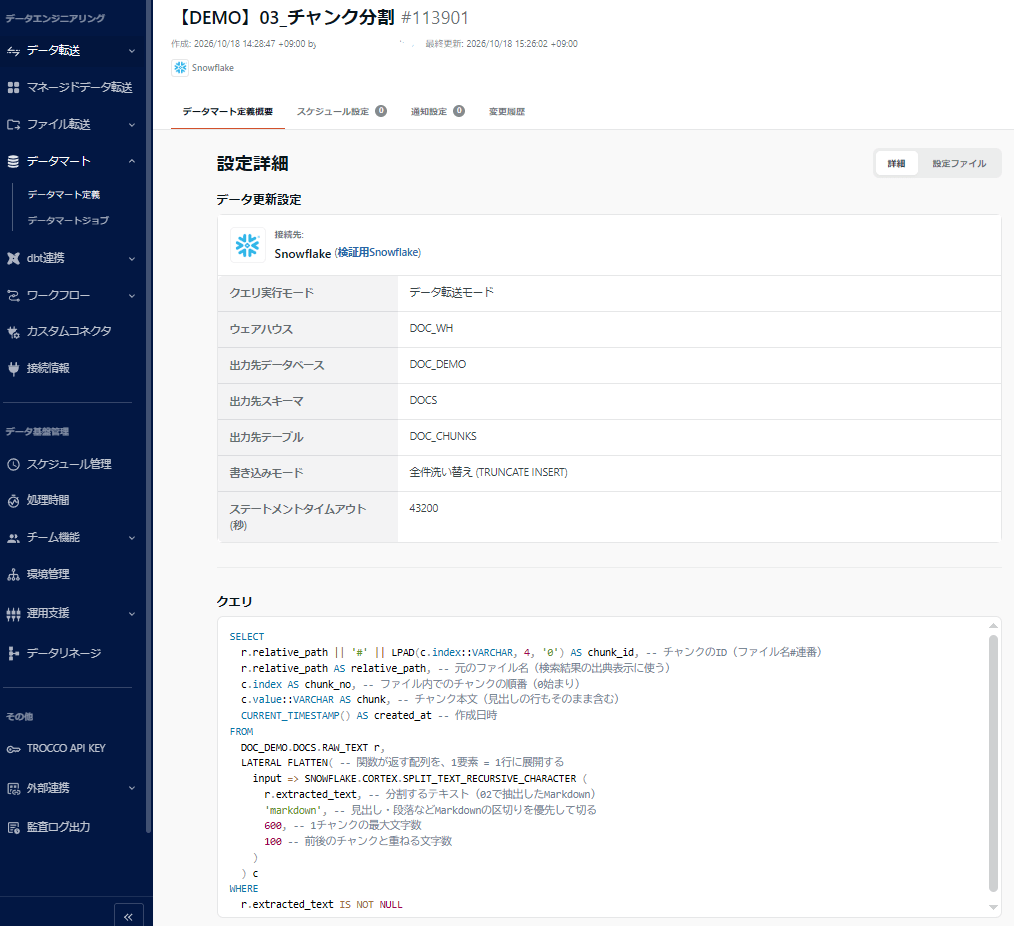
テキストを600文字ずつ(前後100文字は重ねて)に分けて、DOC_CHUNKS に格納します。検索に使う埋め込みモデルが一度に読める量には限りがあるので、長い文章のままだと後ろのほうが検索に効かなくなるためです。
参考:STEP2で使ったSQL
01_ステージ更新(自由記述モード)
USE SCHEMA DOC_DEMO.DOCS;
ALTER STAGE DOC_DEMO.DOCS.DOC_STAGE REFRESH;02_PDFテキスト化(データ転送モード/出力先 DOC_DEMO.DOCS.RAW_TEXT/全件洗い替え)
SELECT
  d.relative_path      AS relative_path,   -- S3上のファイル名(docs/ からの相対パス)
  d.size               AS size,            -- ファイルサイズ
  d.last_modified      AS last_modified,   -- S3上の最終更新日時
  PARSE_JSON(TO_VARCHAR(
    AI_PARSE_DOCUMENT(
      TO_FILE('@DOC_DEMO.DOCS.DOC_STAGE', d.relative_path),  -- ステージ上のファイルを指定
      {'mode': 'LAYOUT'}                                     -- 見出し・表を保ったまま抽出
    )
  )):content::VARCHAR  AS extracted_text,  -- 抽出したテキスト(Markdown形式)
  CURRENT_TIMESTAMP()  AS parsed_at        -- テキスト化した日時
FROM DIRECTORY(@DOC_DEMO.DOCS.DOC_STAGE) d -- ステージ上のファイル一覧
WHERE d.relative_path ILIKE '%.pdf'03_チャンク分割(データ転送モード/出力先 DOC_DEMO.DOCS.DOC_CHUNKS/全件洗い替え)
SELECT
  r.relative_path || '#' || LPAD(c.index::VARCHAR, 4, '0') AS chunk_id, -- チャンクのID(ファイル名#連番)
  r.relative_path AS relative_path, -- 元のファイル名
  c.index AS chunk_no,              -- ファイル内でのチャンクの順番
  c.value::VARCHAR AS chunk,        -- チャンク本文
  CURRENT_TIMESTAMP() AS created_at -- 作成日時
FROM
  DOC_DEMO.DOCS.RAW_TEXT r,
  LATERAL FLATTEN(
    input => SNOWFLAKE.CORTEX.SPLIT_TEXT_RECURSIVE_CHARACTER (
      r.extracted_text,             -- 分割するテキスト
      'markdown',                   -- 見出し・段落などMarkdownの区切りを優先して切る
      600,                          -- 1チャンクの最大文字数
      100                           -- 前後のチャンクと重ねる文字数
    )
  ) c
WHERE
  r.extracted_text IS NOT NULL
STEP3 探す:Cortex Searchで検索して、AIに答えてもらう
チャンクができたら、Cortex Searchで検索できるようにします。検索サービスの作成と更新も、TROCCOのデータマートから実行しています。
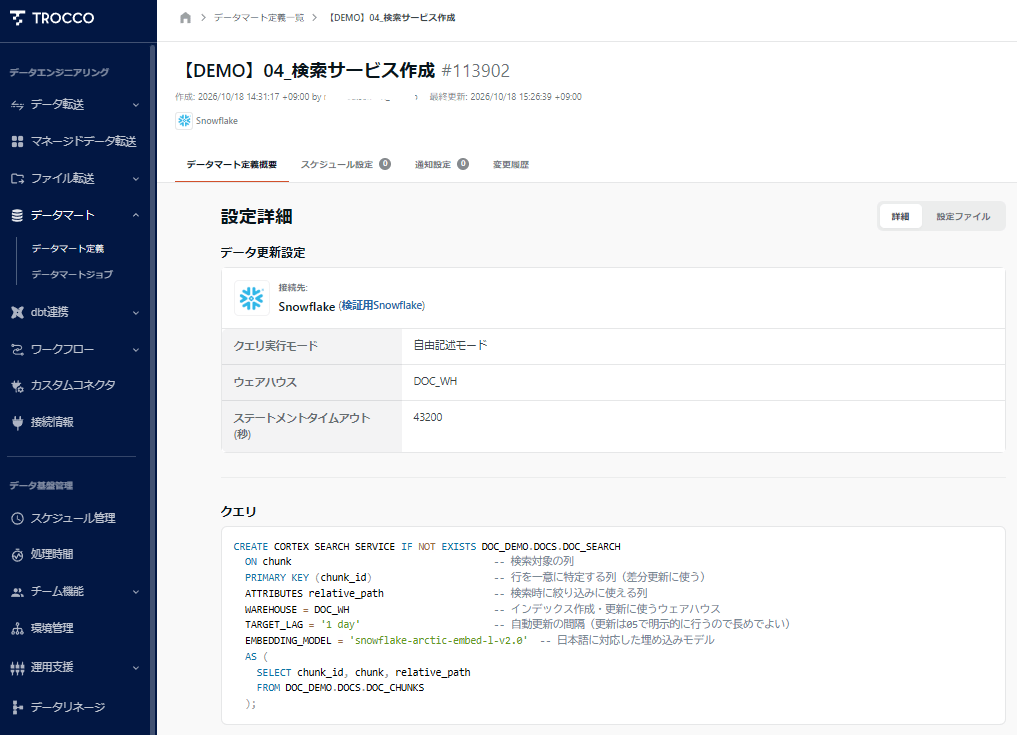
04_検索サービス作成
DOC_CHUNKS を元に検索サービスを作ります。日本語のPDFを扱うので、埋め込みモデルは多言語対応のものを指定しています。
05_検索インデックス更新
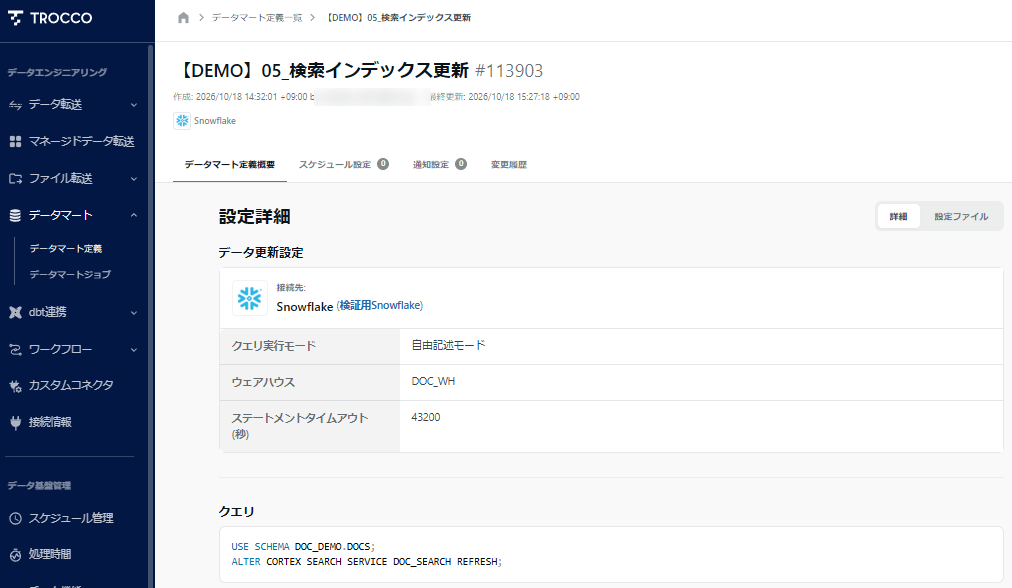
チャンクを入れ替えたあと、検索側にもすぐ反映させるために REFRESH を流します。自動更新を待たなくて済みます。
実際に聞いてみる
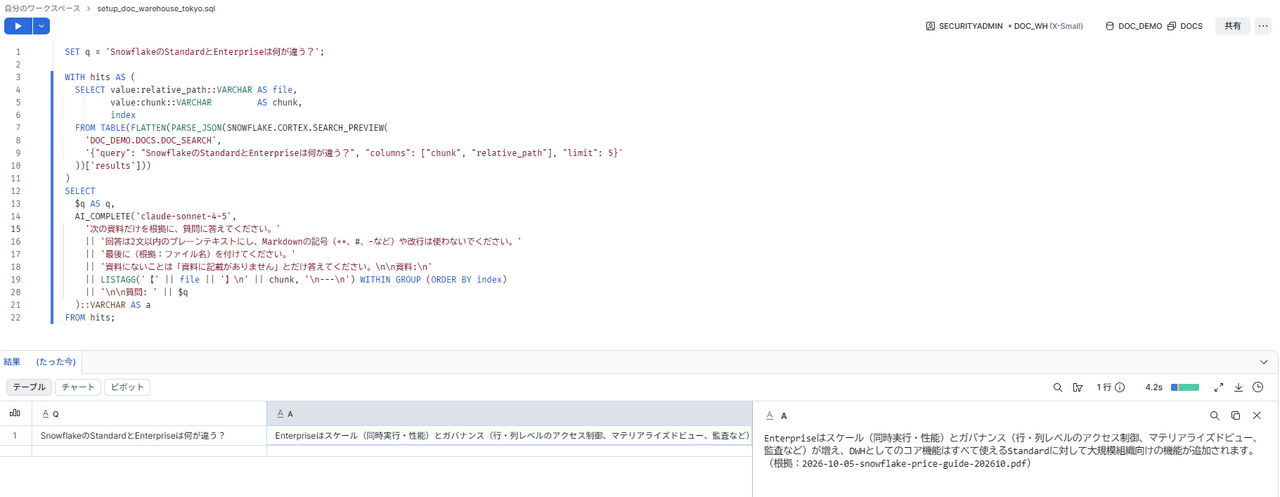
ここはSnowsightから確認しました。やっていることは単純で、Cortex Searchで質問に関係しそうなチャンクを5件取ってきて、それを資料としてAIに渡し、答えてもらうだけです。SQL1本で書けます(SQLは下の「参考」に載せています)。
「SnowflakeのStandardとEnterpriseは何が違う?」と聞いてみると、料金ガイドの記事をもとに、根拠のファイル名つきで答えが返ってきました。応答は4秒ほどです。
参考:STEP3で使ったSQL
04_検索サービス作成(自由記述モード)
CREATE CORTEX SEARCH SERVICE IF NOT EXISTS DOC_DEMO.DOCS.DOC_SEARCH
  ON chunk                                   -- 検索対象の列
  PRIMARY KEY (chunk_id)                     -- 行を一意に特定する列
  ATTRIBUTES relative_path                   -- 検索時に絞り込みに使える列
  WAREHOUSE = DOC_WH                         -- インデックス作成・更新に使うウェアハウス
  TARGET_LAG = '1 day'                       -- 自動更新の間隔
  EMBEDDING_MODEL = 'snowflake-arctic-embed-l-v2.0'  -- 埋め込みモデル
  AS (
    SELECT chunk_id, chunk, relative_path
    FROM DOC_DEMO.DOCS.DOC_CHUNKS
);05_検索インデックス更新(自由記述モード)
USE SCHEMA DOC_DEMO.DOCS;
ALTER CORTEX SEARCH SERVICE DOC_SEARCH REFRESH;
実際に聞いてみる
SET q = 'SnowflakeのStandardとEnterpriseは何が違う?';

WITH hits AS (
  -- Cortex Searchで、質問に近いチャンクを5件取ってくる
  SELECT value:relative_path::VARCHAR AS file,
         value:chunk::VARCHAR         AS chunk,
         index
  FROM TABLE(FLATTEN(PARSE_JSON(SNOWFLAKE.CORTEX.SEARCH_PREVIEW(
    'DOC_DEMO.DOCS.DOC_SEARCH',
    '{"query": "SnowflakeのStandardとEnterpriseは何が違う?", "columns": ["chunk", "relative_path"], "limit": 5}'
  ))['results']))
)
SELECT
  $q AS q,
  -- 取ってきたチャンクを資料としてAIに渡し、答えてもらう
  AI_COMPLETE('claude-sonnet-4-5',
    '次の資料だけを根拠に、質問に答えてください。'
    || '回答は2文以内のプレーンテキストにし、Markdownの記号(**、#、-など)や改行は使わないでください。'
    || '最後に(根拠:ファイル名)を付けてください。'
    || '資料にないことは「資料に記載がありません」とだけ答えてください。\n\n資料:\n'
    || LISTAGG('【' || file || '】\n' || chunk, '\n---\n') WITHIN GROUP (ORDER BY index)
    || '\n\n質問: ' || $q
  )::VARCHAR AS a
FROM hits;
STEP4 つなぐ:ワークフローでスケジュール実行する
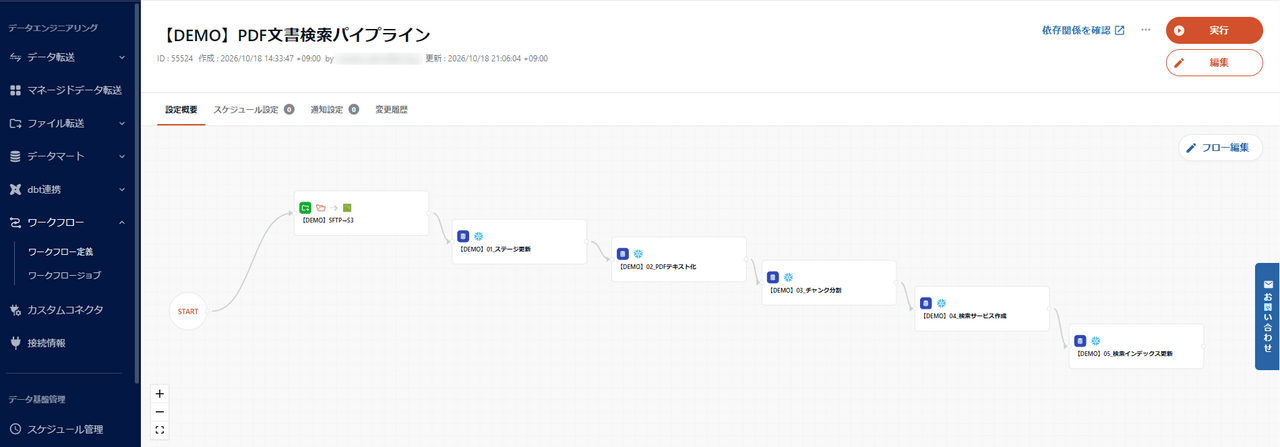
最後に、ここまでのファイル転送とデータマートをTROCCOのワークフローでつなぎます。これもブラウザから、処理を並べて線でつなぐだけで設定できます。
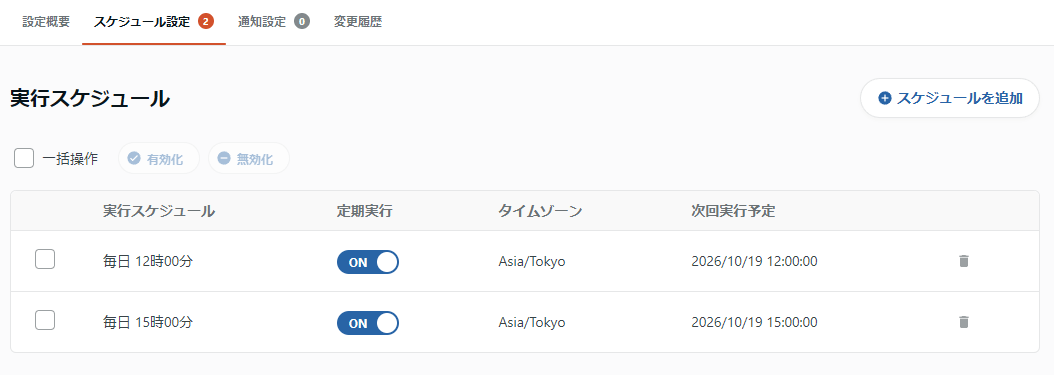
スケジュールは複数登録できます。今回は毎日12時と15時の2回にしました。タイムゾーンもここで選べるので、日本時間で指定できます。
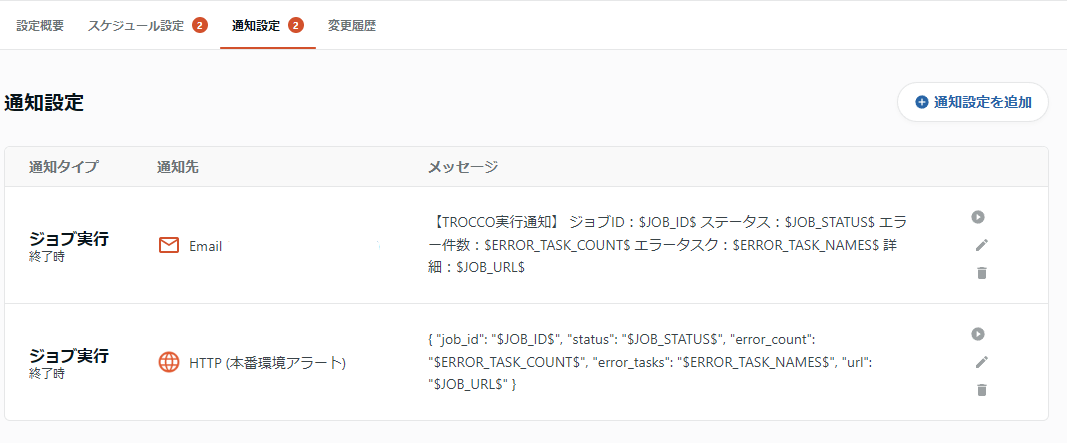
通知先はメール、Slack、HTTPなどから選べます。今回はジョブ終了時にメールとHTTPの両方へ通知するようにしています。メッセージにはジョブIDやステータス、エラーになったタスク名などを差し込めます。
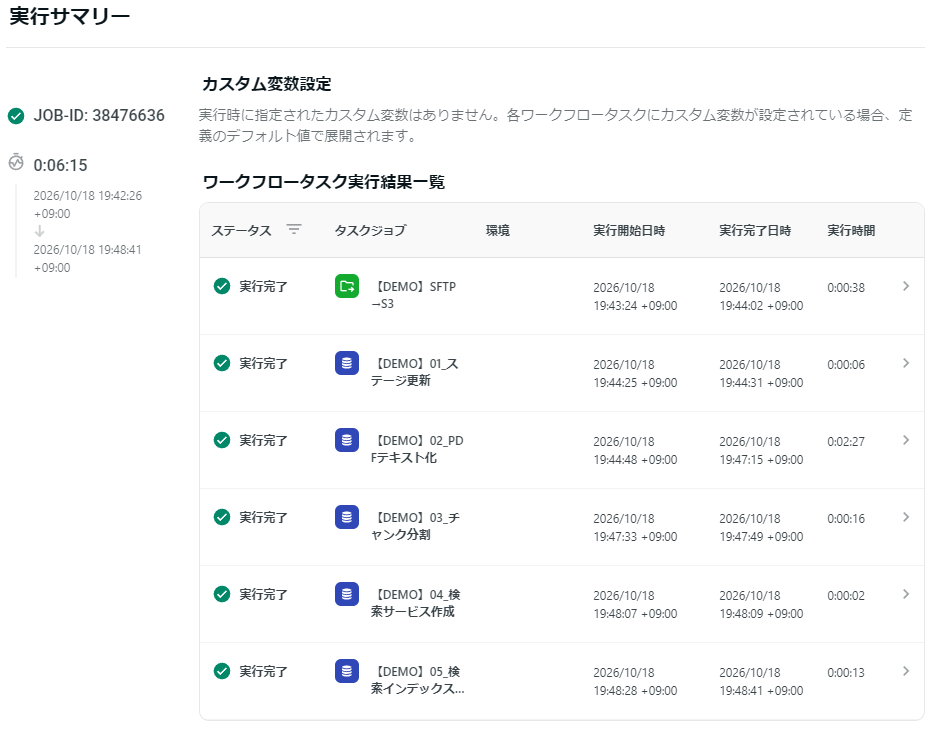
実行すると、ファイル転送から検索インデックスの更新まで、6つのタスクが上から順番に流れます。今回の9本で全体は約6分。いちばん時間がかかったのはPDFのテキスト化(約2分半)で、ほかはどれも数秒〜数十秒でした。
まとめ
TROCCOの新機能「ファイル転送」を使って、SFTPサーバー上のPDFをSnowflakeのAI検索に取り込んでみました。9本のPDFでワークフロー全体は約6分。Cortex Searchで検索してAIに答えさせるところまで、一通り動きました。
Snowflakeだけでも同じことはできますが、スケジュールや処理フロー、通知までまとめて管理するなら、TROCCOを使った方が運用は楽だと感じました。特に、ワークフローを画面で組み立てられるのは便利です。
一方、今回はPDFが9本だけなので、Snowflake側は毎回全件洗い替えにしています。ファイルが増えれば、差分処理やコストも考える必要がありそうです。また、最初からS3にファイルがあるなら、ファイル転送は使わなくてもSnowflakeから直接読めます。SFTPサーバーや社内ネットワークなど複数に分散しているファイルを集めて、その後の処理までまとめて運用したいときが、TROCCOが威力を発揮すると思います。
今回は自分のブログ記事で試しましたが、次は実際の手順書や仕様書を流してみたいところです。