 本記事は 夏休みクラウド自由研究2026 8/30付の記事です。 |
こんにちは、SCSKの木澤です。
当サイトも記事数が約1,800に達し、全文検索でお目当ての記事が表示されるまでに手間がかかることが増えてきました。
最近はWebサイトにAIチャットボットが搭載されるケースが増えているため、当サイトへも検索を補助するチャットボットを設置できないか検討を開始しました。
今回は、レスポンスのストリーミング化や多層防御などのアップデートを加えた最新のアーキテクチャとそのポイントをご紹介します。
要件
本システムはWordPress既存環境への外付けが容易にできるよう、以下のポイントで設計を行いました。
- WordPressへのネイティブ統合
インストールが容易なように、WordPressプラグインで導入できるようにする。
また、記事の更新・削除が速やかに反映されるようにする。 - 可能な限りコストを安く
サーバレス構成やAWSのマネージドサービスを採用し、コストは限りなく抑える - セキュリティは最大限配慮する
プロンプトインジェクションなどの不正利用が無いよう、WAFやガードレールを組み合わせた多層防御で最大限の配慮を行う。
アーキテクチャ
全体構成
AIコーディングエージェント(Kiro)と壁打ちしながら検討を重ね、最終的に以下の構成となりました。
ストリーミング配信とセキュリティを備えた以下のアーキテクチャになっています。
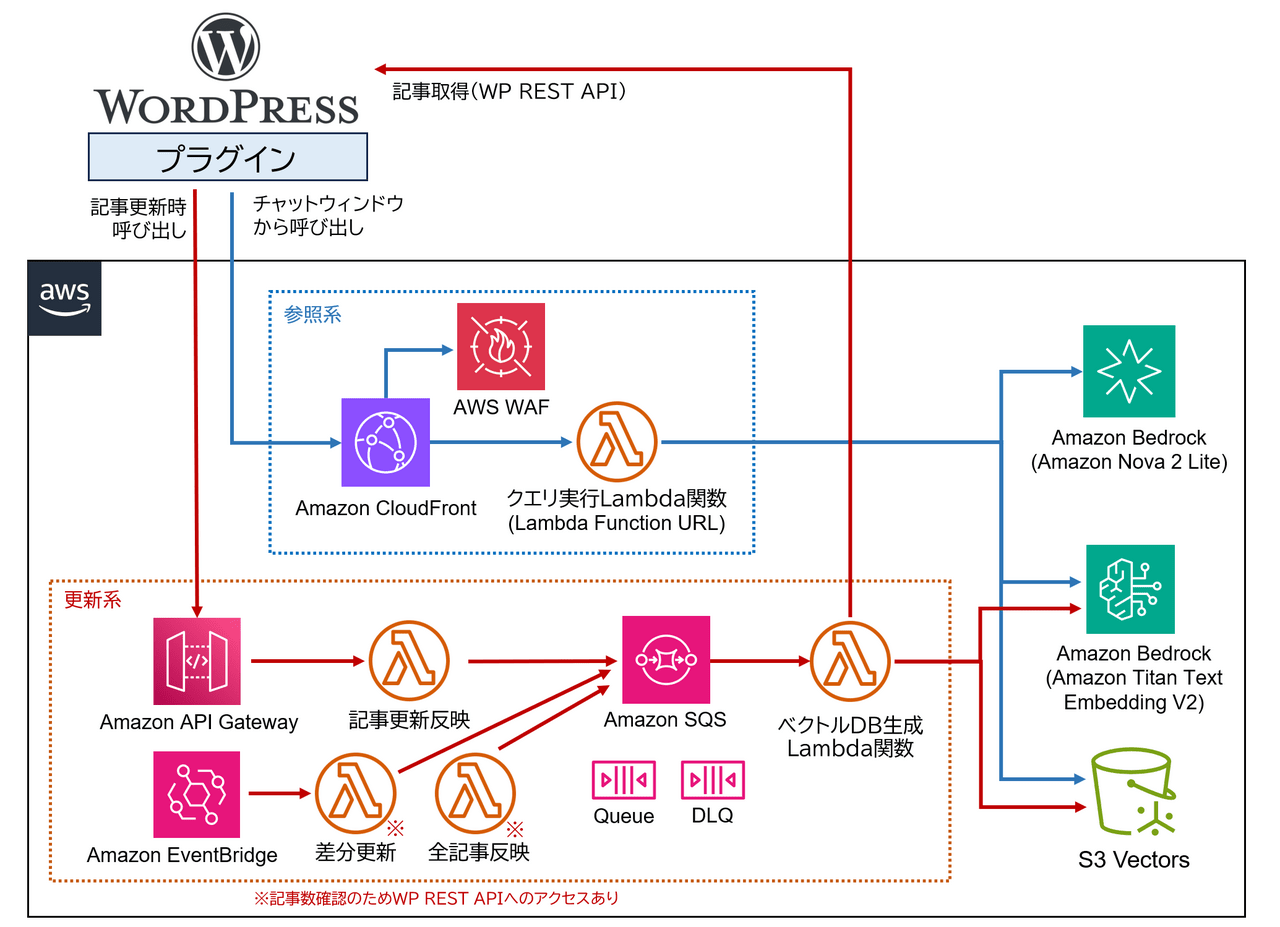
今回はAWSが提供するマネージドのRAG環境「Amazon Bedrock Knowledge Bases」は選択せず、セルフマネージド構成としました。
理由は、WordPressとの統合を細かく、かつ柔軟(チャンキング戦略やUIのストリーミング制御など)に実装したかったためです。
また、後述するコストの観点でも低く抑えることができました。
以下、システム構成の概要をご説明します。
更新(登録)系
更新パターンは以下の3つを想定し、それぞれに対応する処理(Lambda関数)を構成しました。
- 全記事(初期投入時) ※手動実行
- 当該記事のみ(記事追加・更新時:API Gatewayの経由でWebhookを受信)
- 日次差分(更新漏れ防止:EventBridge Schedulerで起動)
全記事の初期投入時など、大量のコンテンツを処理する際には、Lambdaの実行時間制限に引っかかる懸念があります。
そのためAmazon SQSを間に挟み、ベクトルDBを作成するLambda関数を逐次処理として分離する構成にしています。
このベクトルDBを作成するLambda関数での処理の流れとしては以下の通りです。
- WordPress REST APIから当該記事データを取得する
- 文書を意味的・構造的に適切なサイズに分割する「チャンキング」を行う
- Amazon Titan Text Embeddingを用いて、テキストデータをベクトルに変換する
- チャンクデータをベクトルDB(S3 Vectors)に格納する
運用開始後のデータ同期は、記事更新時の差分追加と日次バッチ処理で対応します。
チャンキング戦略については後ほど解説します。
参照(検索)系
ユーザーからの質問に対し、RAGを用いて類似記事を含めた検索結果を返す「クエリ実行用Lambda関数」を開発しました。
なお、WordPressサイト上のミニウィンドウで手軽に利用できるよう、専用のWordPressプラグインも開発しました。
処理の流れとしては以下の通りです。
- ユーザーのリクエストはWordPressプラグインからAmazon CloudFront経由でLambda関数に届く
- ユーザーリクエストを検索に適したクエリに書き換える(Rewrite-Retrieve-Read手法)
- Amazon Titan Text Embeddingを用いて、検索クエリーをベクトルに変換する
- ベクトルDB(S3 Vectors)にて、似た意味を持つチャンクを検索する
- 抽出した関連ドキュメントをコンテキスト(根拠となる前提知識)として扱い、ユーザーの元の質問文と組み合わせたLLM向けのプロンプトを作成する。
- 構築したプロンプトをモデル(Amazon Nova 2 Lite)に渡し回答を生成する
- 回答と参照元のURL情報をユーザーに返す
なお、このクエリ実行用のLambda関数は、Lambda Function URLで公開しAmazon CloudFront経由で配信する構成としました。
考えられる構成としては
- Amazon CloudFront + Lambda Function URL(採用構成)
- API Gateway(HTTP) + Lambda統合
- Lambda Function URL直接公開
これらがあるのですが、一般公開するにあたりAWS WAFによる綿密なセキュリティ制御をするため、CloudFrontを経由での配信を選択した次第です。
また、回答の待ち時間をなくすため、Lambda Web Adapter (LWA) と FastAPIを組み合わせ、Amazon Bedrock(Nova 2 Lite等)の ConverseStream APIによる回答をHTTPレスポンスストリーミングとしてフロントエンドへ逐次配信しUX向上を高める構成としました。
これをCloudFront経由で配信することでユーザーにタイプライターのようにスムーズな応答を返します。
ポイント
本構成のキーとなるコンポーネントの選定理由や、運用・セキュリティ面で工夫した点を解説します。
RAG検索精度向上への取り組み
検索精度を上げるため、下記の工夫をしています。
ベクトルDB作成時
以下の工夫を行い、より検索に掛かりやすいようにしました。
- チャンクサイズのチューニング
一般的に精度が高いと言われている、300~500字程度の小さめにしています。
但し、小さすぎると文脈が細切れになるため、オーバーラップを大きめ(80字程度)にチューニングしました。 - タイトル・見出し構造の活用
ブログ記事は見出しで章立てされていることが多いため、タイトル・見出しをプレフィックスに含めて回答の出典がしやすいようにしました。 - 英文字は全て小文字化
大小文字の違いで検索に掛からないケースがあったので、全て小文字化し格納するように修正しました。
検索時
意図しないハルシネーション(嘘の回答)を防ぐため、ベクトル検索とプロンプトの間に工夫を入れました。
- Rewrite-Retrieve-Read 手法
ユーザーの口語的な質問文をそのままベクトル検索するのではなく、一度Bedrockで「検索に適したクエリ」に書き換えてからS3 Vectorsへ投げることで、ヒット率を向上させるようにしました。 - 厳密な距離フィルタ
S3 Vectorsの検索結果に対し、コサイン距離の閾値を設定し、関連性の低い記事がプロンプトに混入するのを強制的に除外するようにしました。
セキュリティの向上
本システムはWebサイトを通じて一般公開されるため、より一層セキュリティを考慮し以下の実装を行いました。
- WAF統合
ボットによる大量アクセスでコストの増大の可能性があったため、同一IPからのレート制限超過時にCAPTCHAを要求してボットを足止めできるよう、CloudFrontにWAFをアタッチするようにしました。AWS ManagedRules(Common Rule Set)による保護も可能です。 - Bedrock Guardrailsの利用
プロンプトインジェクションを防ぐ Prompt Attack フィルタを適用し、不適切な指示をブロックするようにしました。
なお、日本語対応のためStandard Tierのクロスリージョン推論を利用する必要があります。 - 短期署名トークン(HMAC認証)
固定のAPIキーではなく、WordPressのウィジェットがページ表示ごとにHMAC-SHA256で署名した有効期限付き(既定5分)のトークンを発行し、それを送信することでLambda関数側で認証を行うようにしました。 - Lambda Functions URL直接アクセス禁止
CloudFrontがオリジンリクエストに付与する固定シークレットヘッダーをLambda側で照合し、Function URLへの直接アクセスを403エラーで弾くようにしました。POSTリクエストの場合はOrigin Access Controlが利かないため、旧来の仕組みを採用です。
コストを抑えた構成の選定
核となるベクトルデータベースには、サーバレスかつベクトル専用のストアである「S3 Vectors」を採用しました。


AWS上で構成可能なベクトルDBにはAmazon OpenSearch Serverlessなど他にも多様な選択肢がありますが、以下の点から今回のユースケースには最適だと判断しました。
- 圧倒的なコスト優位性
S3 Vectorsは完全従量課金のため圧倒的に安価に運用可能です。 - インフラ管理が完全に不要
クラスタサイズやシャードの設計、監視運用が不要で、APIを呼び出すだけで利用できます。 - S3と同様の耐久性
S3同等の99.999999999% の耐久性があります。 - スケーラビリティ
1インデックスあたり最大20億ベクトルまで拡張可能であり、RAG用途であれば数百万記事レベルまで対応できます。
一方で、S3 Vectorsには以下のようなデメリットもありますが、今回の要件では全く問題になりません。
- 検索速度が100~300ミリ秒と少々遅いこと
- ベクトル次元の上限が4096であること(今回使用するTitanモデルの上限が1024なので問題なし)
- PutVectorsの上限が 500ベクトル/リクエスト、2,500ベクトル/秒であること(100記事の初回インデックスで5分程度のため許容範囲)
気になるコストですが、1000記事格納、検索は100回/日想定で、$7以下となります(ほとんどはWAFのACLコスト)
AIを用いたシステムですが、それ程高くならずに安心です。
動作の実際
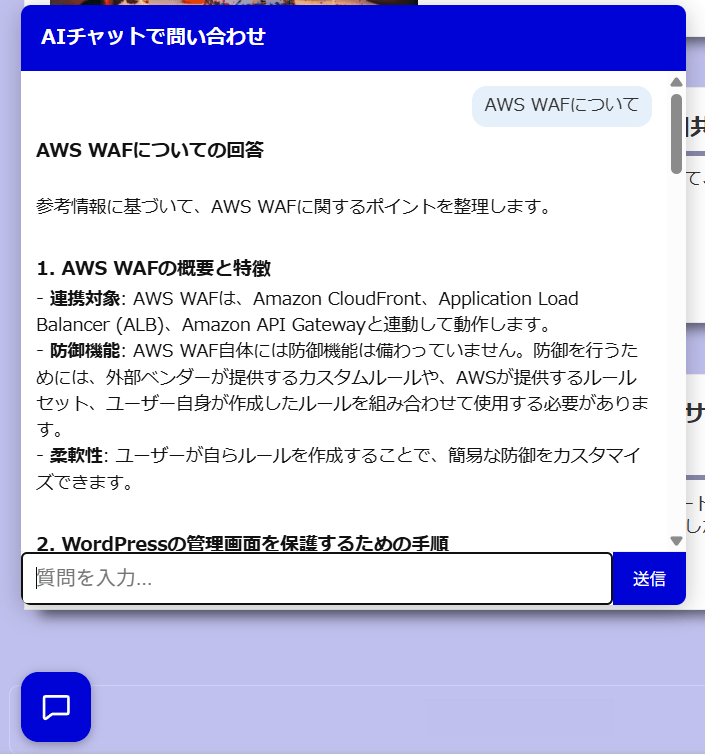
さて本システムは開発を完了し、現在PoCを行っております。
概ね順調な状況ですが、確認のうえ本サイトへの実装を検討したいと考えています。
今後に向けて
RAG開発は以前から行いたいと考えており、遅くなっていたのですが「夏休みクラウド自由研究」を機にチャレンジしてみました。
RAG環境が完全従量課金でできるとは、良い時代になりましたし、S3 Vectorsを初めて触ってみて大変面白いなと思いました。
今回はKiroを用いて開発していますが、今後も色々とアイディアの実現をして行いればと思います。