現代の企業や公共機関の業務インフラは、特定のハイパースケーラーのパブリッククラウドの上に成り立っています。電子メール、チャット、ファイル共有からセキュリティ、アイデンティティ管理に至るまで、単一のクラウドプラットフォームへの集約は圧倒的な運用効率と統合性をもたらした一方で、2026年11月12日から13日にほぼ丸一日に及んだMicrosoft 365(M365)のグローバルな大規模接続障害は、その高密度な統合が抱える構造的な脆弱性を白日の下に晒すこととなりました。
単なるインフラ障害と捉えるだけでなく、構造的脆弱性として「セキュリティ監視基盤がSaaS基盤と共倒れするブラインドSOCリスク」や「SLA・規制対応の実務的摩擦」などを包括的に解説します。
1. 業務停止以上の脅威 — セキュリティ基盤まで一括停止したM365大規模障害の衝撃
2026年11月12日から13日にかけて丸一日発生したMicrosoft 365の大規模接続障害は、単なる「メールやチャットの不通」という日常的なITトラブルの枠組みをはるかに超え、現代の企業および公的機関が構築してきたデジタルガバナンスの根底を揺るがす緊急事態となりました。本インシデントの真の脅威は、主要な業務通信機能がダウンしたこと以上に、組織の脅威検知、データ保護、デバイス統制を司るセキュリティ基盤までもが同一のSaaS基盤上で同時に「暗転」した点にあります。利便性と運用効率を最優先し、通信・認証・セキュリティのすべてを単一のクラウドエコシステムに委ねてきた現代企業のアーキテクチャ設計における致命的な盲点が、もっとも最悪な形で露出したと言えます。
本障害による社会的インパクトは極めて広範かつ深刻でした。
- 日本政府・中央省庁(GSS): 古川デジタル大臣および尾崎官房副長官の記者会見により、政府共通業務環境「GSS」でOutlookによるメール送受信不能などの支障が発生したことが発表されました。デジタル庁、内閣府、総務省、法務省、外務省、金融庁、復興庁、農林水産省、経済産業省、国土交通省、環境省、公正取引委員会、特許庁、原子力規制委員会、警察庁、観光庁、海上保安庁、運輸安全委員会など霞が関の広範な機関に波及。経産省では公募・入札書類の締め切り延長、金融庁では電話対応への切り替えなど緊急措置が講じられました。
- 地方自治体・公的機関: 東京都、愛知県、富山県、三重県、山梨県、佐賀県、長崎県、仙台市、横浜市、大阪市、さいたま市、熊本市、室蘭市などで全庁的にメール受信不能や問い合わせフォームの確認不可が発生。最高裁判所での司法修習生採用手続の自動返信遅延、警察庁の各種申請通知不達など行政手続きに直撃しました。
- 教育・金融・民間企業: 国内の大阪大学、筑波大学、鳴門教育大学、室蘭工業大学等でシステムが停止。民間では金融機関の北國銀行で各種申込受付影響、民間企業では、NTT東日本の受付一部対応遅延、サイボウズイベント(Cybozu Days Japan)での受講票メール確認不可、白水社等に波及。、各種EC・通販での発送通知メール停止など、社会的コミュニケーションが目詰まりを起こしました。海外においても、ハーバード大学、デューク大学、ワシントン大学セントルイス、ミズーリ大学、ネブラスカ大学、ウィスコンシン大学ミルウォーキー校などの教育機関、欧州証券取引所(Euronext:上場関連通知の遅延)、海運巨大企業Maersk(顧客向け連絡・更新の遅延)、英国の医療機関NHS Fife(行政システムの影響)に至るまで、官民問わず世界中の重要インフラおよび社会経済活動がマヒ状態に陥りました。
しかし、セキュリティアナリストの視点から最も深刻に評価されるべきは、単なる業務停止(ダウンタイム)ではなく、セキュリティガバナンス基盤の同時機能不全です。統合脅威検知ポータルであるMicrosoft Defender XDR、メール保護機能Defender for Office 365、データ損失防止(DLP)や情報保護を司るMicrosoft Purview、ならびにデバイス管理を担うMicrosoft Intuneが同時に障害の影響を受けたことで、企業のSOC(セキュリティ運用センター)は「視覚障害(ブラインドSOC)」状態へ叩き落とされました。
単一プロバイダーへの過度な依存がもたらしたこの構造的危機のルーツを解明するため、次章では障害の発生から拡大、収束へと至る詳細な時系列推移と、内部システムで生じていた技術的カスケードダウンのメカニズムを解剖します。
2. インシデント時系列と技術的メカニズム:EX1550543 / MO1550821 が引き起こしたカスケードダウンの解剖
本障害の本質は、外部からの破滅的なサイバー攻撃や大規模なDDoS攻撃によるものではなく、ハイパースケールクラウド内部における自動復旧機構と負荷分散設計が裏目に出た「連鎖的破綻(カスケード障害)」にあったと言えます。ヘルスチェック処理機構の異常から始まり、残存インフラへの負荷集中、そしてサーバー再起動時の暗号化ハンドシェイク(TLS)過負荷による再ダウンというフィードバックループが形成された技術的背景を精査することは、今後のレジリエントなインフラ構築において不可欠な検証プロセスです。
発災メカニズムと連鎖的破綻の過渡的プロセス
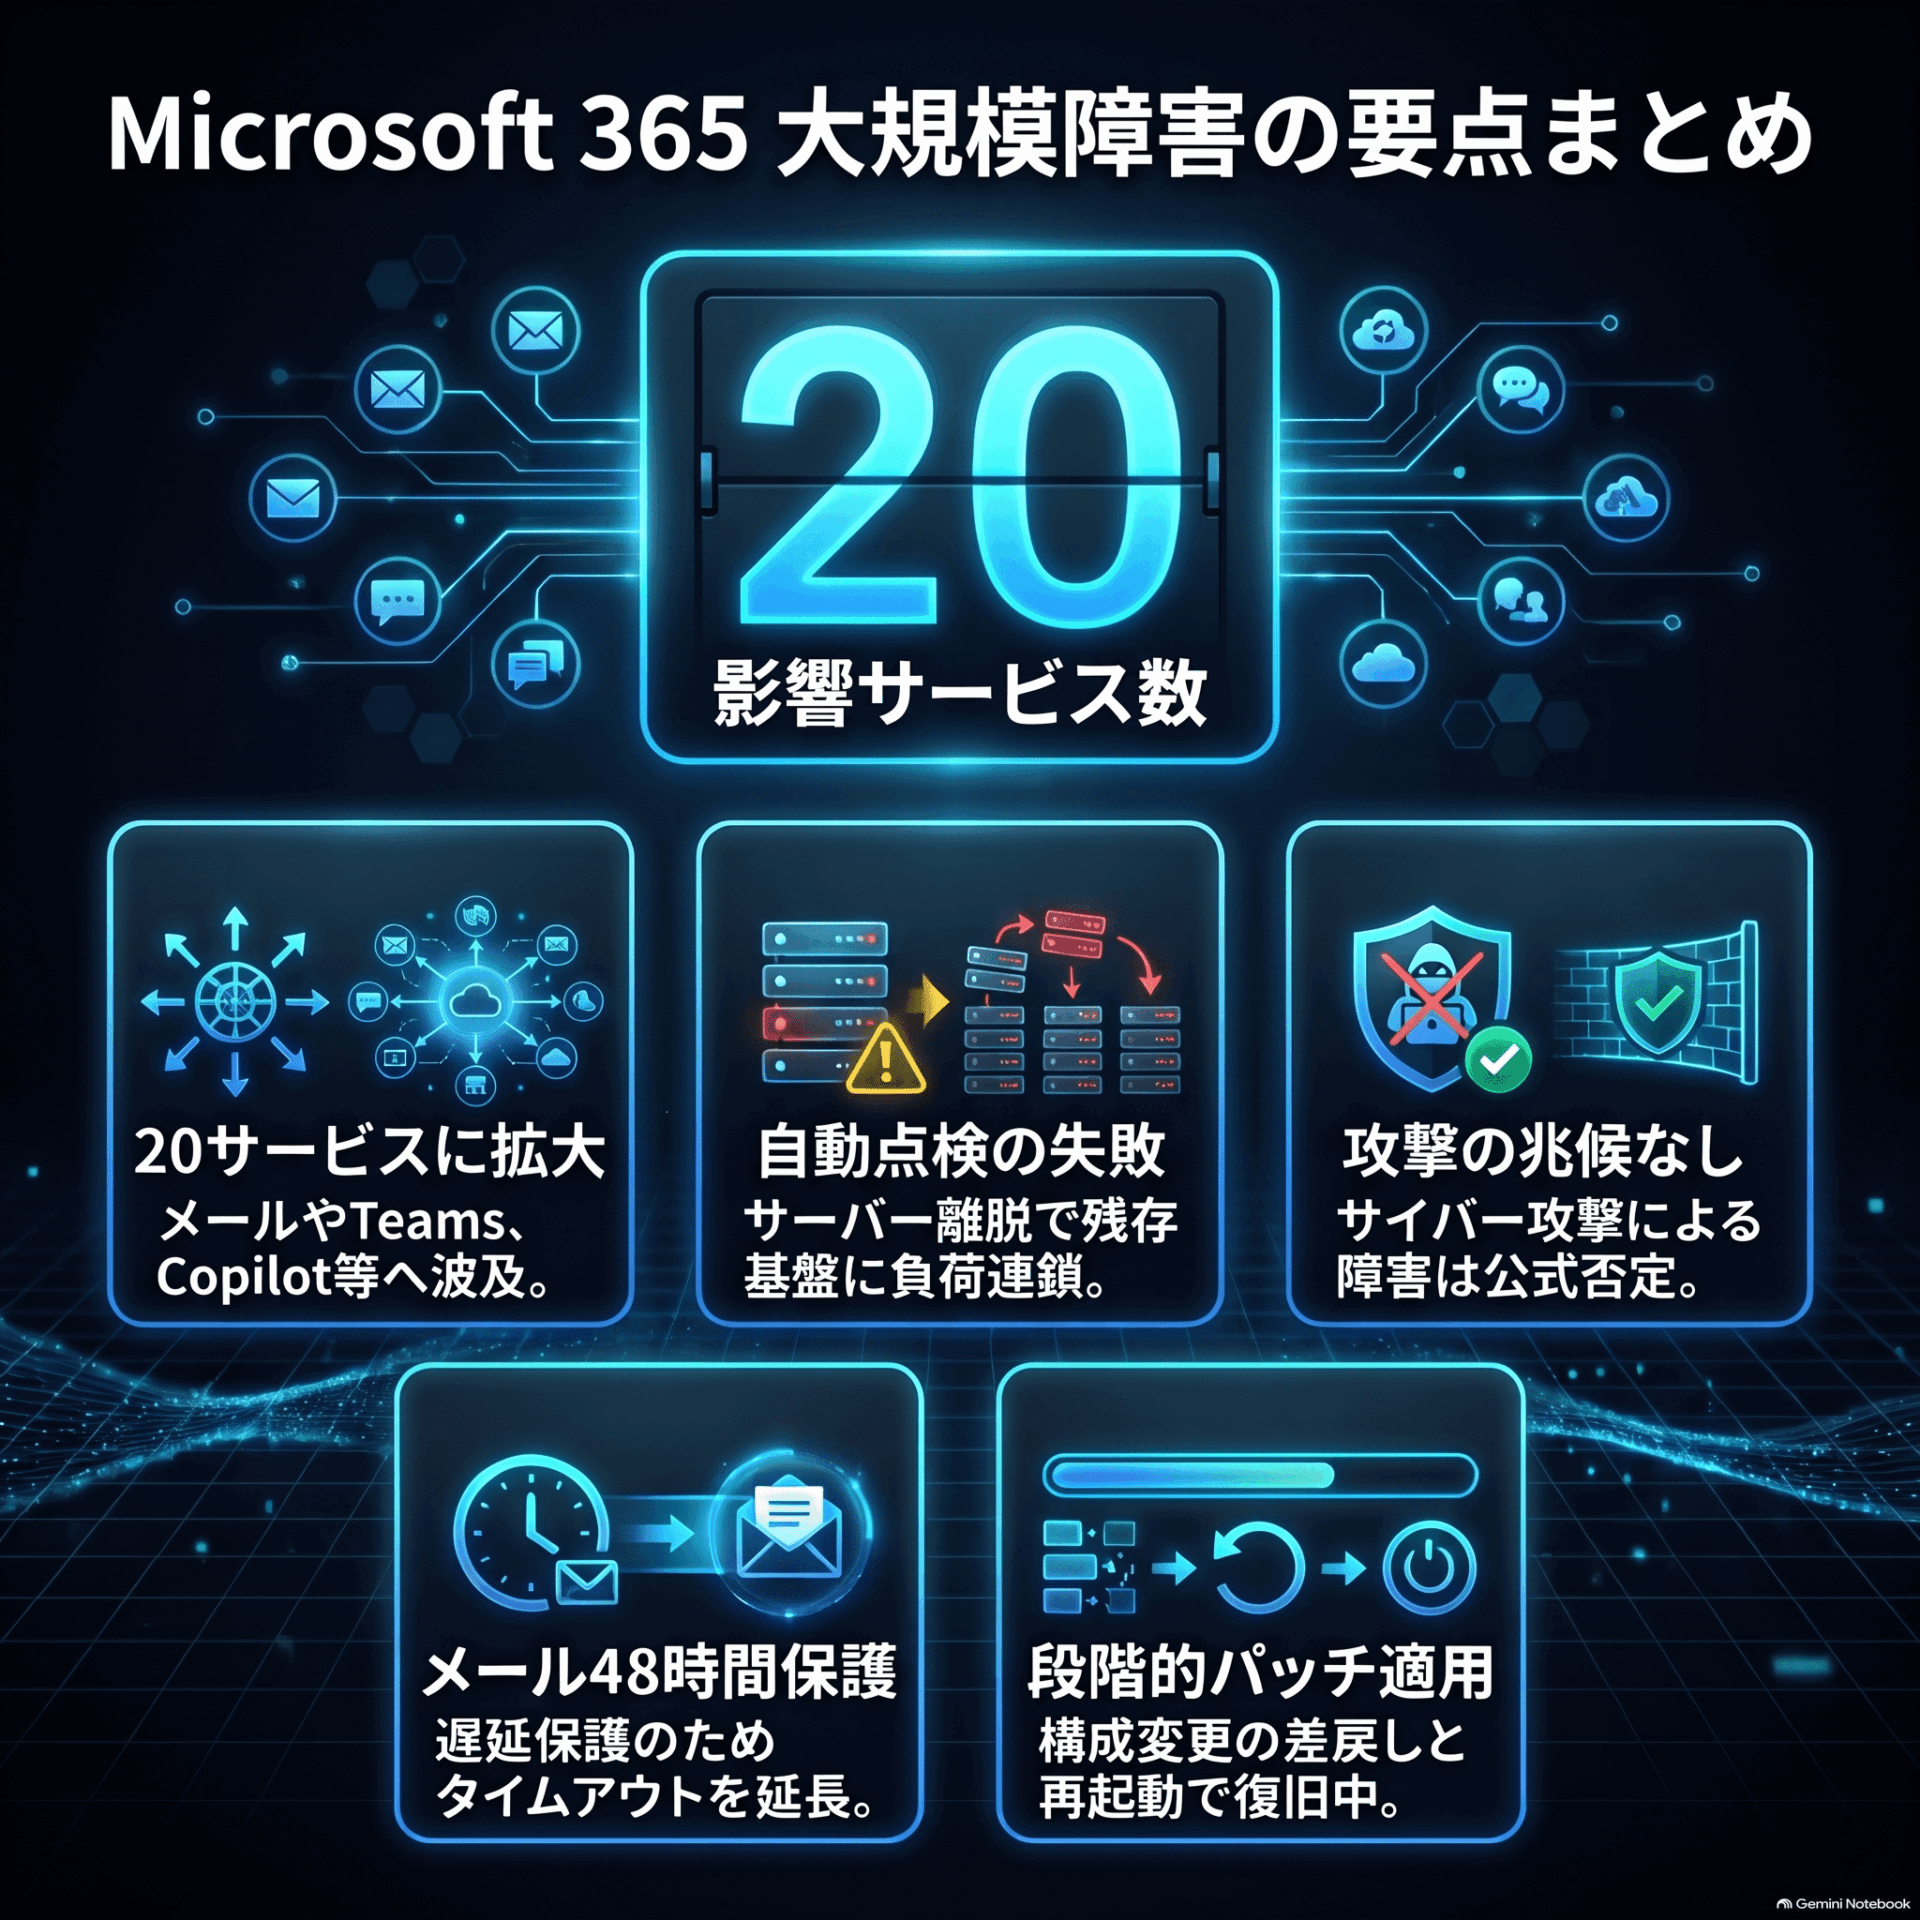
本インシデントは、Exchange Onlineのメールボックス接続障害(識別コード:EX1550543)として発現し、直後にM365スイート全体を覆うMO1550821へと拡大した。障害の継続時間は主要地域で約10〜19時間以上に及び、Microsoftは処理遅延によるメール消失を防ぐため、メールタイムアウト期間を48時間へ緊急延長する措置を講じました。なお、同一日の午前中にはTeams単体で短時間の障害(TM1550488:原因はリソース競合)が発生していたが、Microsoftは本件との直接的関連性を否定しています。
障害の発生と緩和の過程で、Microsoftによる原因の説明は過渡的に二転三転しました。発災当初、同社はトラフィックの突発的急増(アクセス殺到)を疑ったが、その後の解析により「多数のサーバーが自動ヘルスチェックに予期せず連続して失敗し、サービスプールから自動離脱したこと」が負荷集中の引き金であったと訂正されました。正常なロードバランシング環境下では、ヘルスチェックに失敗したサーバーは自動隔離されるが、その結果、残存する健全なサーバー群へ瞬時にトラフィックが移転。キャパシティを超えた残存サーバーも次々と過負荷に陥り、離脱の連鎖を引き起こしました。
さらに事態を致命的にしたのは、隔離・再起動されたサーバーの復旧プロセスです。再起動を経てサービスに復帰したサーバーに対し、接続を待機していた膨大なクライアント(Outlook、Teams、Graph API連携アプリケーション等)からのリクエストが一斉に殺到。「安全な接続を確立するプロセス(TLS/暗号化ハンドシェイク)」にCPUリソースが極度に飽和し、復帰したはずのサーバーがトラフィックを受信した瞬間に再び応答停止(フリーズ)へ追い込まれるという破綻のループが形成されました。
Microsoftは事態の収束に向け、全デプロイメントの静止、代替ヘルスチェック方式の適用、上流の認証およびルーティング構成要素に対する緊急パッチの適用、直近に実施されたネットワーク構成変更の巻き戻し(ロールバック)、仮想マシン(VM)の増強といった緩和策を段階的に投入しました。最終的にサービス保健ダッシュボードにて「悪意あるサイバー攻撃の兆候はない」と結論付けられたものの、クラウド内部の自律制御メカニズムが大規模ダウンを引き起こす構造的リスクが実証される結果となりました。
インシデント詳細時系列表
| 日時 (UTC) | 日時 (JST) | 識別コード / 発表主体 | 事象およびMicrosoftによる分析・緩和策の推移 |
| 11/12 16:17 | 11/13 01:17 | EX1550543 | Exchange Onlineにおけるメールボックス接続障害の発生を管理センターが記録。 |
| 11/12 17:54 | 11/13 02:54 | X (@MSFT365Status) | 米州地域でのExchange Onlineアクセス障害に関する調査開始を公表。 |
| 11/12 18:26 | 11/13 03:26 | MO1550821 | 複数サービスへの影響波及を受けスイート全体のインシデントを開設(当初5サービス)。 |
| 11/12 19:18 | 11/13 04:18 | 管理センター / X | 負荷上昇の原因が外部アクセス急増ではなく「多数サーバーの予期せぬ利用不能」と修正。 |
| 11/12 19:43 | 11/13 04:43 | 管理センター | サーバーが自動ヘルスチェックに失敗して離脱していることを特定。全デプロイメントを静止。 |
| 11/12 20:56 | 11/13 05:56 | 管理センター | 代替ヘルスチェック方式を検証。応答停止サーバーに対する自動連続再起動処理を準備。 |
| 11/12 22:00 | 11/13 07:00 | 管理センター / X | 中核プロセスの過負荷を報告。インフラの一括隔離と段階的トラフィック復旧の検証を開始。 |
| 11/13 00:00 | 11/13 09:00 | 管理センター / X | 復帰させたサーバーがトラフィックを受信すると再度応答停止になる現象(再過負荷)を観測。 |
| 11/13 01:06 | 11/13 10:06 | 管理センター | 暗号化処理(TLS確立プロセス)のCPU飽和を特定。直近のネットワーク構成変更の巻き戻しを開始。 |
| 11/13 07:25 | 11/13 16:25 | 管理センター | 上流の認証/ルーティング構成要素へパッチを適用し、サーバー安定性に良好な結果を得たと報告。 |
| 11/13 09:03 | 11/13 18:03 | MO1550821 | 初期段階の安定化傾向を公表。遅延メール保護のためタイムアウト期間を48時間に延長。 |
このインフラストラクチャ層における壊滅的な過負荷と連鎖破綻は、上位層で稼働するセキュリティおよびガバナンス機能に対しても致命的な分断をもたらしました。次章で、セキュリティツールの暗転がSOC運用へ与えた具体的な影響をより詳細に解説を行います。
3. 「セキュリティツールの暗転」がもたらす盲点
ITインフラストラクチャの基盤と、それを保護・監視するためのセキュリティツール群を同一のSaaSベンダー基盤に一括集約する「単一ベンダー統合アプローチ」は、現代企業の運用効率化を支えてきました。しかし、基盤そのものが大規模障害に見舞われた際、セキュリティ監視体制ごと一括して消失するという重大な構造的欠陥が今回証明されています。ポータルにアクセスできず、ログ収集やポリシー制御が停止したことで、企業のSOCは脅威に対する完全な視覚障害(ブラインドSOC)状態へと追い込ました。
影響を受けた主要管理ツールの機能不全評価
インシデントMO1550821の影響範囲が拡大するにつれ、企業セキュリティの中核を担う以下の管理コンポーネントが次々と麻痺状態に陥りました。
- Microsoft Defender XDR:統合セキュリティポータルへのアクセスが遮断され、リアルタイムの脅威アラート確認、自動調査・レスポンス(AIR)、および高度な脅威ハンティング(Advanced Hunting)機能が停止。SOCアナリストはテナント内での不審な挙動を検知・追跡する手段を全面的に失った。
- Microsoft Defender for Office 365:メール本文内の危険なリンクを検証する
Safe Linksや、添付ファイルをサンドボックスで動的解析するSafe Attachments機能が低下・停止。受信トレイに到達した未知のフィッシングメールや悪意ある添付ファイルに対する動的検証が無効化された。 - Microsoft Purview:データ損失防止(DLP)ポリシーのリアルタイム適用、機密データ(個人情報、知的財産等)の自動ラベル付け、および通信コンプライアンス監視が停止。障害に乗じた意図的・偶発的な情報漏洩をブロックするセキュリティ制御弁が消失した。
- Microsoft Intune & Entra ID / MFA:デバイスのコンプライアンス状態評価やセキュリティポリシーの即時配信に著しい遅延が発生。一部の特権アクセス管理やポリシー変更設定の反映が阻害された。
- Microsoft 365 管理センター:管理者自身が障害状況を確認するための一次情報ダッシュボード(Service Health)すら表示不全・アクセス不能となり、障害発生時に発動すべきセキュリティインシデント対応プレイブックの着手が不可能となった。
セキュリティツール以外のMicrosoft365の主要コンポーネントについては以下の通りです。
- Exchange Online / Outlook:Web、デスクトップ(MAPI)、モバイル、REST APIすべてでアクセス不可・メール遅延。
- Microsoft Teams:通話や会議参加等のコア機能は稼働したものの、カレンダーでの予定作成・会議編集などExchange依存機能が失敗。
- SharePoint Online:直接格納されたファイル閲覧は可能だが、メール連携・通知機能が停止。
- Microsoft 365 Copilot:Copilot Chatの読み込み不可、メールやカレンダー、ファイルへのアクセス失敗。
- Microsoft Power Apps / Power BI:管理ポータル不具合、Power BIでの感度ラベル付きPDFエクスポート失敗等。
- その他:Microsoft 365 Apps、Education、Fabric、Microsoft Graph、Planner、To Do、Universal Print、Windows 365。
さらに障害はMicrosoft製品群の内部だけに留まらず、API連携やサードパーティAIにも影響を及ぼしました。
- Microsoft Graph APIの応答停止:多くの企業が構築している「メールから自動でチケットを起票するヘルプデスク」「CRMへのメール同期」「請求書送付フロー」「Power Automate / Zapier等の自動化ワークフロー」がGraph APIのタイムアウトにより一斉に停止しました。
- サードパーティAIエコシステムへの打撃:Anthropic社が提供する「Claude for Outlook」やM365コネクタ機能において、メール・カレンダー・検索リクエストの大半が失敗。生成AIを活用した先進的な業務プロセスが直接的な障害に見舞われました。また受付システムの「RECEPTIONIST」や監視ツールの「Mackerel」におけるTeams通知連携など、多くのSaaSが連鎖的に機能を制限されました。
主要管理ツールの機能不全とSOC/情シスへの影響対比
| サービス名 | 障害時の機能不全内容 | SOC・情シス運用への実務的打撃 |
| Microsoft Defender XDR | 統合ポータル閲覧不可、脅威検知・自動調査・ハンティングの停止。 | アラートの即時確認が不可能となり、攻撃の侵入や横移動に気付けない「視覚障害(ブラインドSOC)」に転落。 |
| Defender for Office 365 | Safe Links / Safe Attachments によるリアルタイム検証の停止。 | 悪意ある動的URLや解析前の添付ファイルがフィルタを通過し、ユーザーの受信トレイへ直接到達。 |
| Microsoft Purview | DLP(データ損失防止)、自動ラベル付け、通信コンプライアンスの停止。 | 機密情報の外部持ち出しや不正な共有に対するリアルタイム遮断および監査ログ追跡が完全麻痺。 |
| Microsoft Intune | デバイス制御、コンプライアンスポリシー適用、構成変更の遅延。 | 未許可端末のアクセス制御や不正アプリの即時隔離など、エンドポイント統制の実行力を喪失。 |
| M365 管理センター | サービス保健(Service Health)ダッシュボードの表示遅延・閲覧不能。 | 一次情報の取得が遅れ、インシデントの状況把握、社内エスカレーション、対応手順の発動が停止。 |
セキュリティ監視の途絶は、単なる「運用ツールの不便」にとどまりません。サイバー攻撃者にとって、セキュリティツールが暗転している監視空白期間は絶好の攻撃機会となる。次章では、インフラ障害の陰に潜む二次的なサイバー脅威と運用リスクを検証します。
4. 障害発生時に潜む4つの二次的サイバー脅威と運用リスク
大規模クラウド障害の最中において発生するサイバー脅威は、システム不具合そのものによる一時的な業務停止リスクをはるかに凌駕する被害を組織にもたらす可能性があります。インフラの暗転に乗じた悪意ある攻撃者の暗躍と、業務停滞に焦る現場ユーザーの行動が生み出すセキュリティホールは、復旧後も永続する重大な侵入経路となり得えます。
障害に乗じる4つの二次的リスク
- アラート空白期間を狙う攻撃者とブラインドSOC:SOCの監視ポータルやアラート生成がストップしている空白期間中、攻撃者は検知を恐れることなく初期侵入(Initial Access)、権限昇格、ネットワーク内の横移動(ラテラルムーブメント)を試みることが可能となる。この空白期に実行された不正アクセスは、システム復旧後もログの遅延や欠損に紛れ、発見が大幅に遅れる危険性がある。
- 「復旧通知」を装う標的型フィッシングと既知脆弱性の悪用:「メールボックスが復旧しました。アカウントを再検証してください」「IT部門からの緊急メンテナンス完了通知」といった、ユーザーの焦りに付け込むソーシャルエンジニアリング攻撃が急増する。さらに、同時期にはOutlookのNTLMv2ハッシュ漏洩の深刻な脆弱性(CVE-2026-124194:CISAのKEVカタログに登録済み)などの悪用リスクも並行して存在しており、インフラ障害の影で個別脆弱性を狙う攻撃への厳重な警戒が必要となる。
- 現場の焦りによるセキュリティコントロールの迂回(シャドーIT):業務を継続しようとする社員が、会社のメールを許可なく個人アドレス(Gmail等)へ転送したり、未承認のサードパーティ製チャット・ストレージツールを利用したりする事象が多発する。さらに、ITヘルプデスクに対して「MFA(多要素認証)や条件付きアクセスを一時的に解除してほしい」という要請が殺到し、運用ルールを折り曲げてセキュリティ設定を無効化してしまう重大な運用リスクが発生する。
- サイレントインテグレーション障害:Microsoft Graph APIのタイムアウトやエラー(HTTP 429/503)により、CRM(顧客管理)、ヘルプデスク(チケット起票)、ERP(会計処理)、電子請求書発行などの外部連携システムが無宣告で処理に失敗する。最悪の場合、復旧後のバックログ一括処理に伴い、同一データが二重登録・二重送信されるといったデータ完全性の破綻につながる。
二次的脅威への構造化緊急対抗策
以下のチェックリストは、CISOおよびセキュリティチームがインフラ障害時・復旧直後に緊急発動すべき対抗策です。
- [ ] 1. ブラインドSOC期のアラート空白追跡(脅威検知リスク)
- 攻撃シナリオ: 監視停止隙を突いた不正アクセス、横移動、クレデンシャル窃取、データ流出の見落とし。
- 緊急対抗策: サービス復旧後、障害時間帯(11/12 16:00〜11/13 06:00 UTC等)に遡り、Entra IDサインインログ、新規デバイス登録、メール転送ルールの追加履歴を重点的に過去ログ監査(レトロスペクティブ・ハンティング)せよ。
- [ ] 2. 復旧騙りフィッシング&脆弱性悪用への対処(ソーシャルエンジニアリングリスク)
- 攻撃シナリオ: 「アカウント再検証」等を騙る偽メールによる認証情報窃取、およびCVE-2026-124194等の既知脆弱性狙いの攻撃。
- 緊急対抗策: 帯域外チャット・電話網等を通じ全社へ「IT部門から再検証メールを送ることはない」旨を緊急周知せよ。同時に、Office/Windowsの最新セキュリティパッチ(CVE-2026-124194修正)の適用状態を強制確認せよ。
- [ ] 3. 現場のセキュリティ迂回・シャドーITの阻止(運用バイパスリスク)
- 攻撃シナリオ: 業務焦りによる個人メール転送、未承認クラウド利用、ヘルプデスク圧迫によるMFA/条件付きアクセス解除。
- 緊急対抗策: ヘルプデスクに対し「障害時であってもMFA、条件付きアクセス、メール自動転送制限の解除・緩和は一切厳禁」とする緊急統制命令を発令せよ。
- [ ] 4. 外部システム連携のサイレント障害・二重処理防止(データ統合リスク)
- 攻撃シナリオ: Graph API遮断によるCRM/ヘルプデスク連携の静かな停止、復旧後の重複データ生成。
- 緊急対抗策: Graph API連携プログラムに指数バックオフおよび冪等性(Idempotency)が設計されているか確認し、復旧後は連携ログのデータ突合・バックログ二重処理チェックを実施せよ。
これら二次的リスクが突発する根底には、認証・通信・セキュリティのすべてを単一のクラウドプロバイダーに全幅の信頼で委ねるアーキテクチャの構造的限界が存在します。次章では、このSPOF(単一障害点)リスクと、SLAおよび欧州規制(DORA/NIS2)における実務的・法的な現実を考察します。
5. 単一クラウドベンダー依存(Single Point of Failure)の構造的限界とSLA・規制対応の実務
企業のITインフラ、アイデンティティ認証、そしてセキュリティ監視のすべてを単一のクラウドプロバイダーに集約する手法は、運用コストの削減や統合管理という強力なメリットをもたらします。しかしその裏返しとして、ベンダーの基盤障害時に組織の全機能が同時に暗転するという Single Point of Failure (SPOF) の重大なトレードオフを抱え込むこととなります。
SLA(サービスレベル合意)返金手続における構造的摩擦とMSPのジレンマ
障害発生後、多くの企業やMSP(マネージドサービスプロバイダー)がサービスクレジットの請求を検討するが、パブリッククラウド事業者が設定する返金プロセスには、実質的に申請を断念させるレベルの運用摩擦(フリクション)が組み込まれています。
MicrosoftのOnline Services SLA規約に基づき、月間稼働率が99.9%未満に低下した場合は10〜25%、99.0%未満に低下した場合は50%のサービスクレジット対象となり得るため、今回の障害(約10~19時間)のように7時間以上に及んだ場合、月間稼働率は99.0%を大きく下回り50%クレジットの条件を満たします。しかし、このクレジット返金は自動適用はされず、ユーザー側からの手動申請が厳格な期限付きで必須となっている。今回の11月12日の障害の場合は、申請期限は翌月の最終営業日(12月31日)までとなります。
さらに、申請のために求められる証拠保全のハードルは極めて高いものとなります。すでにRedditのMSPコミュニティ(r/msp)等の実務者議論においても浮き彫りになっている通り、申請には以下の膨大なデータと手続が要求されます。
- 対象となる正確なインシデント識別コード(
EX1550543/MO1550821) - 影響を受けた個々の顧客テナントGUID
- 障害の正確な開始・終了タイムスタンプおよび詳細なダウンタイム時間
- 影響を受けた具体的なユーザー数および拠点情報の記録
- 影響を受けたテナントのドメインから送信された、顧客からの公式な補償請求要請メール(個人メールアドレスや代理送信は即座に拒否される)
- 障害発生時に管理者側で一次切り分けを行った対応記録、および管理画面エラーのスクリーンショット
数千から数十万ライセンスを管理するMSPや企業情シスにとって、顧客ごとにこれらの証拠を収集・作成・提出する作業には数十から数百時間の工数が費やされる。これに対し、実際に承認されて返金される金額はユーザーあたりわずか1〜2ドル程度、あるいはライセンス費用の一部分にとどまることが多く、さらに、申請提出後も審査プロセスに6〜18ヶ月を要し、最終的に「手続上の不備」を理由に却下されるケースも散見されます。結果として、「得られる僅かな返金額に対して作業コストが大幅に赤字となる」という経済的合理性の不在から、多くの組織が請求を断念せざるを得ない構造が存在します。
欧州DORAおよびNIS2規制が突きつける法的要求
欧州のデジタル運用レジリエンス法(DORA)やNIS2指令をはじめとする最新のサイバー規制フレームワークは、金融機関や重要インフラ事業者に対し、ITサードパーティ依存リスクの厳格な管理を義務付けています。
単一のクラウド事業者に依存し、障害時の代替手段(Out-of-band)や独立した監視体制を持たないアーキテクチャは、規制上の「単一障害点リスクの放置」とみなされるリスクが高まっています。DORAにおいては、サードパーティのサービス停止時における事業継続計画(BCP)の実行力検証や、サードパーティリスクの定量的評価が法的要件となっており、クラウド事業者の障害を前提としたレジリエンス設計が経営上の必須要件となっています。
構造的限界と規制上の要求を理解した上で、企業が具体的に取り組むべき「デジタルレジリエンス再構築」の実践的アクションプランを次章で解説します。
6. 企業が今すぐ取り組むべきレジリエンス&BCP戦略
過去に何度も経験していることですが「クラウド事業者はダウンしない」という幻想を排除し、「主要クラウドは必ず定期的に障害を起こす」という前提(Design for Failure)に立ったシステムの再構築が急務である。システム設計、SOC体制、運用プロセスの3層において取り組むべき5つの推奨対策を以下に提示します。
5つの領域における具体的推奨対策
1. 帯域外(Out-of-band)緊急コミュニケーション経路と緊急用アカウントの確保
M365(Teams/Outlook)基盤から完全に独立した連絡手段(Signal、別ドメインで運用するSaaSチャット/メール、電話連絡網等)をあらかじめ定義し、社員に周知する。また、Entra IDの認証障害時でも独立してアクセス可能な「非常用管理者アカウント(Break-glass accounts)」を事前に作成・検証しておく。
2. マルチベンダーSOC視点による独立監視体制の構築
同一のSaaS基盤内でセキュリティ監視を完結させず、外部の別の独立したSIEM/MDRサービス(サードパーティSOCソリューション事例に代表される独立監視網)を活用する。これにより、M365ポータルが暗転した場合でも、エンドポイントやアイデンティティのテレメトリ監視を継続できる独立した視界を確保する。
3. Graph API連携のレジリエント設計(技術的4要素の徹底)
社内システムやCRMとMicrosoft Graph APIを連携させる開発・アーキテクチャ設計において、以下の4要素を設計規約に義務付ける。
- 指数バックオフ(Exponential Backoff)とリトライ上限: API呼び出しでエラー(HTTP 429/503等)が発生した際、
Retry-Afterヘッダーを遵守しつつ、待機時間を指数関数的に延ばしてリトライする。 - デッドレターキュー(DLQ): 一定回数リトライしても成功しないリクエスト・ペイロードは破棄せず、隔離用キュー(DLQ)に保存して手動・自動の再処理に備える。
- 冪等性(Idempotency)設計: 各メールやイベント処理にユニークな識別子(
internetMessageId等)を付与し、遅延バックログの一括処理時に同一データが重複登録されない設計とする。 - デルタ同期(Delta Query): 「最終実行時刻からの差分」ではなく、GraphのDelta Queryトークンを用いて状態を追跡し、長時間の障害復旧後もデータの抜け漏れなく同期を再開する。
4. SLA申請実務の自動化と証拠保全手順の標準化
障害発生時に、テナントGUID、ダウンタイム時間、システムログ、顧客からの申請要請メールを自動収集するスクリプトやプレイブックを準備し、申請期限(12月末等)までに速やかにサービスクレジットの請求を行える体制を整える。
5. サプライチェーン&サードパーティリスク管理(DORA/NIS2適合)
DORAやNIS2規制に準拠し、サードパーティ依存度のリスク評価を定期的に実施。マルチクラウドやハイブリッド構成を考慮し、単一ベンダー依存による事業停止リスクを削減する。
7. まとめ:クラウド時代の「ゼロトラスト」はクラウド事業者自体の障害も想定する
従来のネットワーク境界型セキュリティ(境界型防御)から脱却し、すべてのアクセスを疑い検証する「ゼロトラスト」の思想は、現代のサイバーセキュリティにおけるデファクトスタンダードとなっています。しかしながら、多くの組織においてその適用範囲は「外部からの攻撃者」や「信頼できない端末・ネットワーク」にとどまっており、「インフラを提供するクラウド事業者そのものの可用性失効」というリスクが盲点として置き去りにされています。
記憶に新しい2024年7月に発生したCrowdStrike障害が「端末層のエージェント破綻」による世界的混乱を引き起こしたとすれば、今回の2026年11月のMicrosoft 365大規模障害は「クラウド基盤層の同時暗転」がもたらす構造的危機を突きつけました。両インシデントが教える共通の教訓は、どれほど巨大で信頼できる主要ベンダーであっても、単一のシステムに企業のすべての機能を委ねる設計は本質的に巨大なリスクを抱え込むという事実です。
「誰も信じず、常に検証する(Never Trust, Always Verify)」というまさにゼロトラストの原則は、サードパーティクラウド事業者の健全性や可用性評価に対しても厳格に適用されなければならない。単一ベンダーエコシステムへの盲目的な依存を脱し、疎結合なシステム設計、帯域外の代替手段、そして独立したセキュリティ視界(マルチベンダーSOC)をアーキテクチャの根幹に組み込むこと。これこそが、不確実性が増すデジタル時代において、CISOおよびセキュリティ・ITリーダーに求められる真の戦略的責務であると言えます。
SCSKでは、境界型防御が終焉を迎えた今、内部への侵入を100%遮断することは不可能な「Assume Breach(侵害前提)」の環境において「侵害の阻止(Prevent Breach)」と同様に「被害半径の縮小(Reduce Blast Radius)」への投資が必須であると考えています。フロンティアAI時代における「3層防御モデル」など「多層防御(Depth in Defense)」と「ゼロトラストアーキテクチャ(Zero Trust Architecture)」となります。
フロンティアAI時代に対応した次世代のソリューションへの刷新が特に重要となっています。その中でも、ランサムウェア被害で最も課題となっているラテラルムーブメント(横移動)を阻止する具体的なソリューションとして 次世代マイクロセグメンテーション Zero Networks をお勧めしております。
Zero Networks は、サーバ・クライアントなどのホスト単位でのネットワーク分離(セグメンテーション)するのはもちろん、特許技術を用いて管理ポート(RDP/SSH等)をデフォルトで閉鎖し、ジャストインタイム(Just-In-Time:JIT)の多要素認証(MFA)を適用することが可能です(≒特権ID管理)これまでのレガシーなマイクロセグメンテーション製品と異なり完全エージェントレス型で、通信の可視化からAIによるポリシー自動生成が可能なため短期間の導入が可能です。「封じ込め(Containment)」アーキテクチャを確立することで、N-hour攻撃下でも安全にパッチを適用できるインフラ耐性を確保することができます。
すでに多くの引き合いをいただいておりますが、Zero Networks にご興味をもたれた方は、ぜひSCSKまでお問い合わせください。

それ以外にも、マイクロセグメンテーションと組み合わせることで完全なゼロトラストを実現する SASE(Secure Access Service Edge)、これまでのウィルス対策ソフトやEDRと異なり、AIを活用し非常に高い検知率を誇る次世代エンドポイントソリューション、そして攻撃者が侵入後に真っ先に狙うバックアップデータを保護し、確実な復旧を早期に実現するためのゼロトラストデータ保護ソリューションなど、多層防御とゼロトラストを実現するセキュリティソリューションをご紹介することが可能です。
最後までお読みいただき、ありがとうございました。