みなさん、こんにちは。SCSKの石井です。
先月、あるお客様のCSIRT責任者から、こう聞かれました。
「この攻撃、どこの国なんですか」。
私は即答できませんでした。ログにも検体にも、犯人の国籍は書いていないからです。
ただ——書いていないだけで、消えてもいない。マルウェアには開発者の指紋が残ります。使うコンパイラ、埋め込むフォント、APIを呼ぶ順番。人の文章を読むように、コードの「文体」を読む。2026年、帰属は勘と経験から、統計の領域へ移りつつあります。今日はその現在地を、2017年のちょっと乱暴な実験から辿ってみます。
あ、それはそうと。。ようやくセキュリティ動画配信され、皆さまにご案内が遅れてしまいましたが、
以下にてご案内させていただきまっす!
SCSK IT Platform Navigator YouTubeサイト(↓)
Claude Mythosとは?AI時代のサイバー攻撃と企業が取るべきセキュリティ対策を専門家が解説!
2026年、攻撃の「量」は見える。だが「誰が」は見えない
まず前提を揃えておきます。IPAの「情報セキュリティ10大脅威 2026」(2026年1月29日公開)の組織編は、1位「ランサム攻撃による被害」が11年連続、2位「サプライチェーンや委託先を狙った攻撃」が8年連続。そして3位に「AIの利用をめぐるサイバーリスク」が初選出されました。5位には「機密情報を狙った標的型攻撃」、6位には「地政学的リスクに起因するサイバー攻撃」が入っています。上位の顔ぶれは、もはや純粋な技術問題ではなく、国家・地政学・組織の話です。
警察庁が2026年9月に公表した「令和8年上半期におけるサイバー空間をめぐる脅威の情勢等」も示唆的でした。ランサムウェアの被害報告は半期で123件、統計を取り始めて以降で最多。中小企業が約6割、製造業が約3割。復旧に1,000万円以上かかった組織が6割、1か月以上を要した組織が5割超。加えて、ぜい弱性探索とみられる不審なアクセスは前年同期比で大幅に増え、その大部分が海外を送信元としていました。
数字は雄弁です。ただ、数字が教えてくれるのは「どれだけ」まで。「誰が」は教えてくれません。ここから先は、ログの外側にある情報を読む仕事になります。
帰属が難しい5つの理由
帰属(アトリビューション)の難しさは、現場で説明するといつも伝わりにくい。そこでDeep Instinctの研究チームが論文で挙げている論点を、私なりに5つに整理しました。
- 一国に複数のサイバー部隊がある。開発者ごとに書き方が違うので、文書の執筆者推定のような「単一の作者」モデルが崩れます。
- キャンペーンごとに作り替える。C2サーバーも静的シグネチャも、作戦単位で交換される。
- 「悪性」の判定自体を避けてくる。パッキング、暗号化、ゼロデイ。解析の入口で足をすくわれる。
- 偽の特徴を埋め込む。別の国の言語フォントを同梱するなど、意図的に他国を陥れるための「false features」を仕込む事例が指摘されています。
- 検体の絶対数が少ない。機械学習でいう「汎化」が、とにかく難しい。
5番目は、実務者ほど刺さるはずです。検体が数百しかない世界で、未知のキャンペーンにも効くモデルを作る。普通に考えて無理があります。だから帰属は長らく、属人的な職人芸の世界でした。
2017年の実験:生ログを、そのまま10層に放り込む
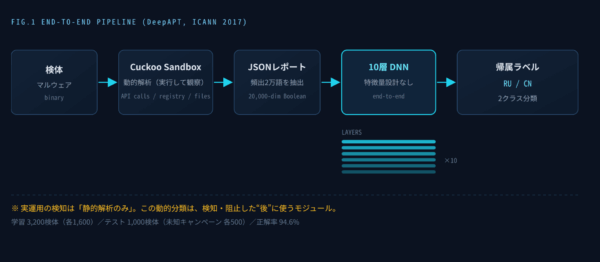
その前提を、正面から殴りにいった研究があります。Deep InstinctのIshai Rosenberg氏らによる「DeepAPT」(ICANN 2017/arXiv:1711.09666、Springer LNCS 10614所収)です。
やったことは、ある意味で乱暴でした。Cuckoo Sandboxが出力する動的解析レポート(JSON)から頻出2万語を抜き出し、パースもせず、特徴量設計もせず、出現有無のBooleanとしてそのままニューラルネットに投入。10層のDNNで「ロシア製か、中国製か」の2クラスに分類します。学習は各クラス1,600検体、計3,200。テストは学習に含まれない別キャンペーンから各500検体、計1,000(NetTraveler、Winnti/PlugX、Cosmic Duke、Sofacy/APT28)。結果は94.6%でした。
私の整理:帰属は「3つの層」で見る
論文を読んで、私は頭の中で帰属の材料を3層に分けることにしました。これが現場でお客様に説明するとき、いちばん腹落ちがいい整理です。
| 層 | 主に残る痕跡 | 寿命 | 偽装されやすさ | AIの効き方 |
|---|---|---|---|---|
| コード層 | コンパイラ/ビルド環境、言語リソース、埋め込まれたフォント、API呼び出しの順序、例外処理の癖 | 長い | 低い(作り直しのコストが高い) | 大きい。end-to-endが最も効く帯域 |
| インフラ層 | C2ドメイン、証明書、ホスティング、ASN、ポート運用 | 短い | 高い(使い捨てできる) | 小さい。IOCは数日で陳腐化 |
| 運用層 | 標的の選び方、作業時間帯、TTP、撤退時の痕跡消去 | 中〜長 | 中程度 | 中程度。地政学的な目的との整合で読む |
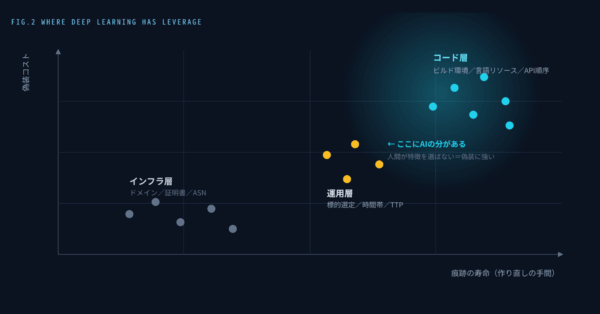
この整理で言いたいことはシンプルです。end-to-endの深層学習が効くのは、圧倒的にコード層。人間が「この特徴を見よう」と決めた瞬間、攻撃者はそこに偽装を置ける。特徴選択を人間がやらないことの強みは、精度よりも「騙されにくさ」の側面が大きい——私はそう考えています。ただし、出てくるのは「容疑者リスト」であって「判決」ではありません。ここを混同すると、技術は簡単に誤用されます。
防御側の結論:帰属は事後、遮断は事前
帰属がどれだけ進化しても、それが終わるのは被害が出た後です。そして2026年のいちばん厄介な変化は、AIによって攻撃コードの生成と亜種の投入が高速化し、シグネチャの寿命が構造的に短くなっていること。警察庁の報告書も、AIの悪用として不正プログラム作成やフィッシングサイト作成の事例を挙げ、攻撃がより高速かつ大規模になるリスクに言及しています。
だとすれば、投資の順序は明確です。帰属の精度を上げる研究と同じか、それ以上に、「実行前に止める層」を厚くする。Deep Instinctは、静的解析だけで未知の攻撃を20ミリ秒未満で予測・遮断し、誤検知率0.1%未満をうたう予防型のプラットフォームです(数値はいずれも同社の公表値)。判定根拠を即座に示すDIANNAのような説明機能は、CSIRTの報告書にも、経営会議の説明にも効きます。「止めた理由」を残せることは、技術的な要件というより、いまや説明責任の要件です。
まとめ:読む力より先に、止める力を。
帰属は技術として面白い。けれど事業を守る順番で言えば、最初に必要なのは「読む力」ではなく「止める力」です。コードの文体を読む研究の蓄積があって、はじめて「誰が」を語れる。その順序を間違えないことが、2026年の現実的な防御だと私は思っています。
SCSKでは、Deep Instinctの検証(PoV)から導入・運用までをご支援しています。「未知のものを、実行前に止める」仕組みを一度見てみたい方は、下記の製品ページからお問い合わせください。
★ディープラーニングによる予防型エンドポイントセキュリティに興味をお持ちの方へ
本記事でご紹介したディープラーニング(深層学習)による革新的な防御思想を、実際のプロダクトとして体現し、
多くのお客様の環境を守っているのが、SCSKが取り扱う「Deep Instinct(ディープインスティンクト)」です。
従来のセキュリティ運用(EDRなど)に限界を感じている方、未知のランサムウェア対策を強化したい方は、ぜひ以下の製品詳細ページをご覧ください。